大语言模型的数值线性代数
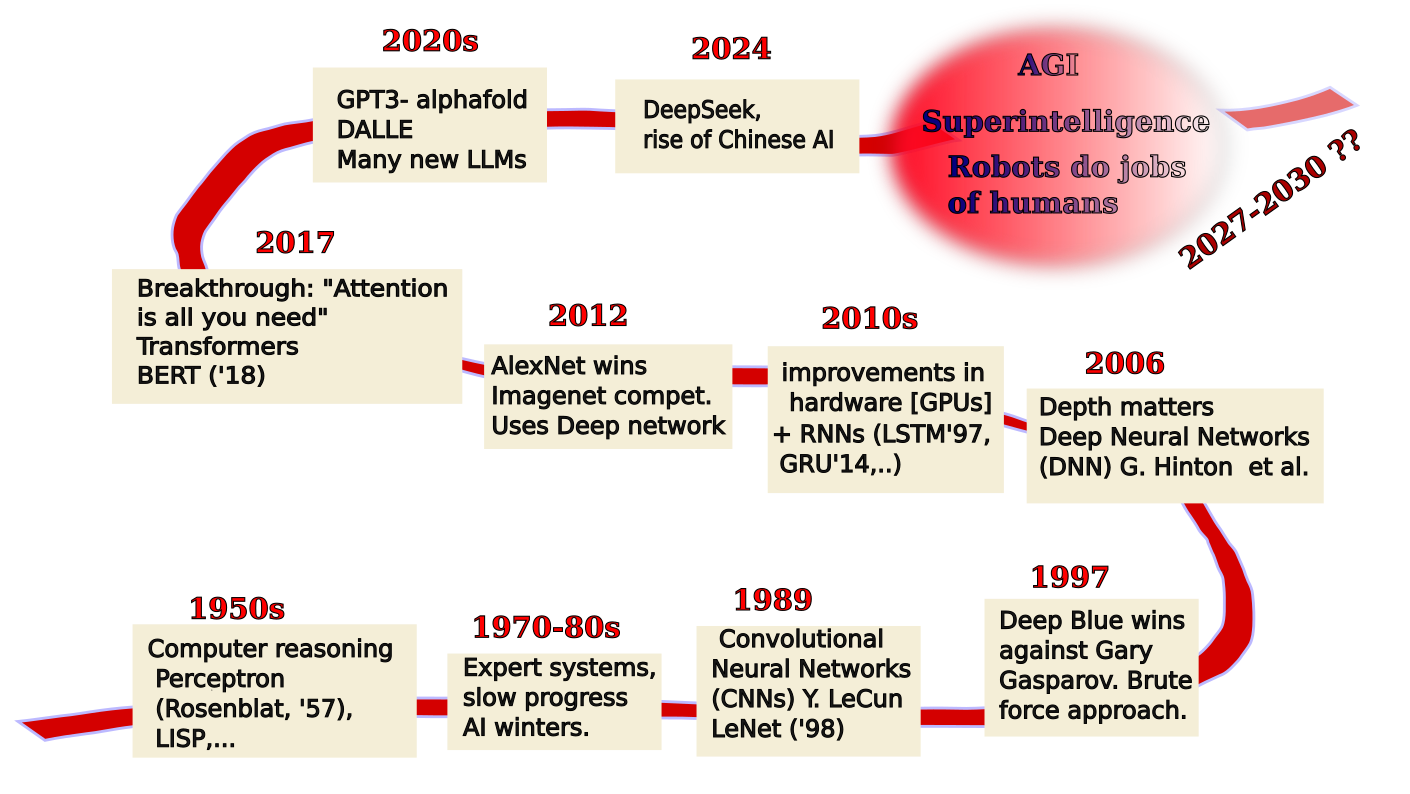
数值线性代数(Numerical Linear Algebra, NLA)长期在推动科学发展中扮演关键角色,为科学与工程应用中的基本问题提供求解工具。几十年来,它不断演进以应对一波又一波科学发现带来的需求:20 世纪 50–60 年代,大量工作致力于求解空气动力学中涌现的特征值问题,由此诞生了 LR 与 QR 算法;此后关注点转向计算空气动力学等领域常见的稀疏线性系统求解。 如今我们正经历又一轮重大科学进展,NLA 再次处于其发展核心。这股 Machine Learning (ML) 浪潮对科学与工程极具颠覆性,许多 ML 工具(尤其是 Large Language Models (LLMs))都建立在矩阵与张量方法之上。随着我们逼近 Artificial General Intelligence (AGI),矩阵方法必将发挥更重要的作用。对数值线性代数从业者而言,当前变化之快使适应尤为困难。 本文是一篇以机器学习技术为核心的综述,尤其聚焦大语言模型,主要有两个目标: 1. 以数值方法专家易于理解的方式,阐明 Large Language Models 背后的核心概念; 2. 梳理 LLM 技术所采用的关键 Numerical Linear Algebra 概念,并重点介绍 NLA 近期对该领域的若干重要贡献。
论文精读
TL;DR 从数值线性代数视角系统拆解 LLM 的 Transformer、注意力、优化等核心组件,揭示矩阵/张量方法在其中的关键作用,为算法工程师提供交叉学科地图。
问题
问题背景
当前 AI 行业核心焦点是大规模 Transformer 架构与 LLM 的训练、推理及效率优化。矩阵与张量计算构成模型前向、反向与参数更新的基础,数值线性代数(NLA)重新成为底层关键。
现有方法局限
传统 NLA 工具主要面向中小规模、确定性的线性系统或特征值问题,其假设在 LLM 场景下普遍失效:
- 稠密/稀疏假设失效:注意力矩阵、前馈权重具有低秩、块对角(MoE)等特殊结构,经典 BLAS/LAPACK 未充分利用,导致计算与存储浪费。
- 随机优化下的数值稳定性:SGD/Adam 的随机梯度带来噪声,传统向后误差分析难以直接迁移;混合精度训练中 FP16/BF16 的舍入误差累积可能引发训练发散。
- 超大规模与分布式约束:单卡显存无法容纳千亿参数,矩阵分块、通信与量化需要新的 NLA 框架;传统正交化、SVD 在 TB 级张量上不可行。
为什么难/重要
LLM 的尺度(万亿参数、百万 token 上下文)使得矩阵运算的数值误差、内存带宽与通信模式成为瓶颈。注意力机制的 O(n^2) 复杂度与长序列要求低秩/稀疏近似,但精度损失又影响生成质量。此外,AGI 竞赛 驱动业界不断扩展模型,底层数值方法的微小改进可转化为显著的成本与能效收益。NLA 与 ML 的交叉成为算法工程师、研究员与产品经理共同关注的技术底座。
行业类比
类似 芯片制造中的光刻与设计规则:LLM 的矩阵计算如同光刻工艺,数值线性代数的每一个算法改进,都像提升光刻分辨率一样,直接决定下一代模型的可行性、良率与成本。
核心洞察
- **LLM 组件是模块化的矩阵/张量算子,为 NLA 从业者提供了统一的数值分析框架。** 不同于 ML 社区将 Transformer 视为“黑箱”堆叠的神经网络层,本文显式地将注意力、MLP、LayerNorm、残差连接表示为线性投影、加权平均、逐元素缩放和残差求和等结构化映射。这种视角使秩、条件数、谱范数、低秩近似等 NLA 工具可直接用于分析模型表达能力和数值稳定性。工程上可据此设计低秩压缩、量化或混合精度策略,减少对经验试错的依赖,从算子复合角度进行系统性优化。
- **注意力机制的秩瓶颈与 MLP 的参数主导地位揭示了 LLM 效率与扩展性的核心权衡,为稀疏化和低秩压缩提供了理论依据。** 论文指出单头注意力的输出仅依赖低秩的 value 投影加权组合,存在信息瓶颈;而 MLP 层虽计算结构简单,却占据绝大多数参数和 FLOPs。这一视角将 MoE、LoRA 等流行技术重新解释为针对不同算子瓶颈的结构化近似,而非孤立技巧。工程上可优先对 MLP 子层进行低秩或稀疏化处理,同时监测注意力矩阵的秩分布,避免盲目压缩导致性能大幅下降,从而在参数效率和模型容量之间取得平衡。
方法
输入与表示
本文作为一篇综述,不提出单一新模型,而是以 数值线性代数 (NLA) 视角系统拆解 LLM 架构与训练。输入侧:原始文本经分词器转为 token_id 序列,映射为嵌入向量并叠加位置编码,形成数值矩阵。
关键模块的 NLA 解读
- 多头自注意力:将嵌入矩阵通过 Query/Key/Value 投影矩阵做线性变换,再执行缩放点积注意力,本质上是低秩亲和度矩阵与 Value 的加权平均。论文指出注意力存在低秩瓶颈,可借助 NLA 的低秩近似、稀疏化方法压缩。
- 前馈网络 (MLP):通常采用 SwiGLU 等门控结构,包含两个线性层与非线性激活;它占据绝大部分参数量和计算量,是 NLA 优化的重点对象。
- 层归一化与残差连接:RMSNorm 替代 LayerNorm,残差流作为工作记忆贯穿各块,形成复合算子。
训练与输出
堆叠块最终输出 logits,经 softmax 得到下一 token 概率分布。训练采用自回归交叉熵损失,优化器如 AdamW 涉及梯度计算与二阶矩估计,NLA 在高效矩阵运算、混合精度数值稳定性等方面提供支撑。论文还梳理了近期 NLA 对 LLM 的贡献,包括注意力低秩压缩、MoE 路由稀疏化、量化与低秩微调等。
与常规 NLP 或深度学习综述不同,本文面向数值线性代数研究者,以算子复合与矩阵结构为主线,将 LLM 各组件映射为明确的线性代数对象,揭示计算瓶颈与优化空间。
实验
实验设计叙述
本文为综述文章,未包含独立的实验环节。作者通过系统梳理 Large Language Models (LLMs) 中关键组件的数值线性代数(NLA)基础,将 Transformer 架构拆解为可分析的算子结构,重点覆盖 self-attention、multi-head attention、MLP、LayerNorm/RMSNorm 及 residual stream。这种“算子化”视角使 NLA 从业者能理解 LLM 的计算核心,无需依赖具体数据集或训练流程。
关键发现
- 矩阵与张量运算贯穿始终:从 token embedding 到 attention 的
Q/K/V投影,再到 MLP 的扩张-压缩,均涉及大规模矩阵乘法,NLA 工具(如低秩分解、随机投影)可显著降低复杂度。 - 注意力机制本质是加权平均:scaled dot-product attention 可视为对 value 向量的加权组合,其 rank 与计算瓶颈直接影响模型效率,这为低秩近似和稀疏化提供了切入点。
- 残差流充当工作记忆:decoder-only LLM 中,residual stream 的线性累加特性使得反向传播和梯度分析更符合 NLA 的视角。
- 文章指出,随着 AGI 推进,矩阵方法将扮演更重要的角色,NLA 与 ML 的交叉是必然趋势。
与基线对比解读
本文并非与某个 baseline 模型对比,而是对比了 NLA 思维与 ML/AI 思维的差异:前者关注数值稳定性、条件数、低秩结构,后者更侧重端到端优化和泛化。作者强调,理解这些底层算子有助于设计更高效、更稳定的 LLM 训练与推理方法,例如利用 NLA 中的结构化矩阵来替换密集投影。
行业影响
落地场景
NLA 优化成果可直接用于 LLM 推理加速与模型压缩。以电商推荐为例,通过低秩近似(如 LoRA 的矩阵分解)与稀疏注意力计算,可将大模型部署在低端 GPU 甚至边缘设备,实现实时个性化推荐。内容平台可对海量用户生成内容进行快速语义分类与情感分析,降低 token 级延迟。教育领域利用 NLA 加速的轻量模型完成自动批改与答疑。
商业价值
核心降本是推理成本,通过量化、剪枝、低秩分解减少 FLOPs 与显存占用,直接降低云服务账单;同时提升吞吐,在固定硬件上服务更多并发请求,改善用户体验(低延迟)。对训练侧,优化优化器与混合精度(如 AdamW 的矩阵计算)可缩短训练周期,加速模型迭代,提高企业响应市场变化能力。
与现有产品/工作流的接口
与现有 ML 栈无缝集成。在 PyTorch 或 JAX 中,NLA 优化以算子库形式(如 cuBLAS、CUTLASS)或自动微分内的自定义 kernel 实现。推理服务可集成到 TensorRT、ONNX Runtime、vLLM 等引擎,通过替换注意力核函数或启用低秩适配插件获得加速。训练框架支持混合精度与内存高效注意力,无需改变模型架构。此外,NLA 工具可嵌入 MLPerf 基准测试,指导硬件选型。
具体落地 use case:
- 电商实时推荐:使用 LLM 提取商品文本特征,通过低秩注意力加速,将单次推理延迟从 50ms 降至 15ms,可在用户浏览时实时生成推荐理由。
- 金融新闻情绪分析:利用压缩后的 Transformer 在 CPU 上实现每秒数百条文本处理,辅助高频交易决策。
局限
- 这篇综述文章的主要局限在于其 **综述性质**:它没有提出新的数值线性代数算法或理论结果,也没有对 LLM 中的矩阵运算进行新的实证分析。因此,对于希望获得可复现代码或新基准的读者,贡献有限。文章主要整合已有文献,对 NLA 与 LLM 交叉领域的梳理可能不够系统,某些部分(如注意力机制的线性代数解释)可能只是总结常见知识,缺乏深入的分析或批判性比较。
- 可推断的局限是 **覆盖范围与深度权衡**:文章试图同时面向数值方法专家和 LLM 从业者,但可能两边都不讨好。对于 NLA 专家,LLM 部分的讲解可能过于基础,缺少对最新架构(如 Mamba、RWKV、RetNet 等非 Transformer 模型)中线性代数问题的讨论;对于 ML 从业者,NLA 部分可能未深入涉及实际训练中的数值稳定性、混合精度、低秩压缩等工程痛点。与专门的 LLM 数学基础综述(如《The Mathematical Foundations of Transformers》)相比,本文在数学严格性和前沿性上可能有差距。
- 由于是撰写于特定时间点的综述,可能存在 **时效性局限**。LLM 领域发展极快,比如稀疏注意力、线性注意力、KV 缓存量化、MoE 训练优化等话题在近期有大量新工作,文章可能未能涵盖这些最新进展。此外,文章虽然强调 NLA 对 LLM 的贡献,但对 NLA 社区面临的开放性挑战(如长序列的线性代数复杂性、低精度下的稳定性分析)可能只做了浅层讨论,缺少对未来研究方向的明确指引。