EyeRobot 2.0: 无需腕部相机的主动注视精确操作
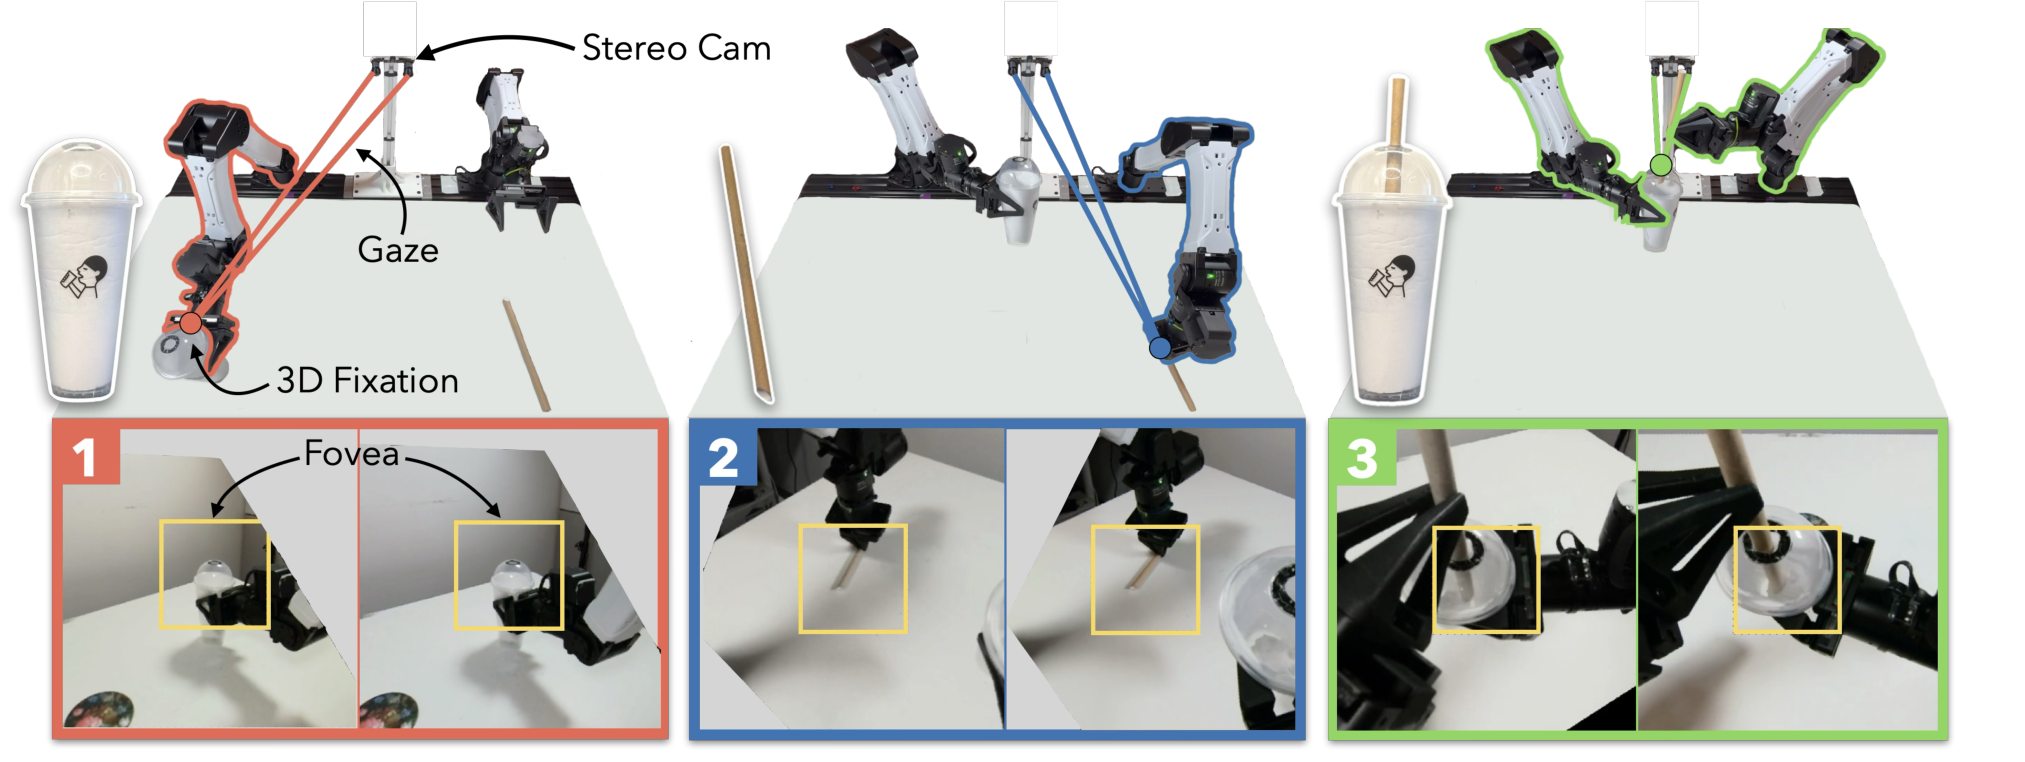
受人类视觉启发,我们提出一个使用主动注视(active gaze) 的框架,仅凭单个 stereo camera 即可完成细粒度双手操作。EyeRobot 2.0 通过转动两个 eye viewpoints,将注视中心对准场景中的 3D fixation point,从而在物理上「注视」目标;所得图像以 foveal 方式处理,为中心区域分配更多 visual tokens,把计算集中在任务相关特征上。 这种 Active Visual Fixation(AVF) 需要任务执行期间精心协调的注视,我们采用分层方式实现:先基于目标物体训练低层 gaze servoing policy,再训练 target selector,依据任务进展输出 fixation goals。两个模块都在真实世界数据上用 RL 训练:前者使用稠密的几何奖励,后者与 BC gripper policy 协同训练,从而发现类似人类执行任务时的注视序列。 EyeRobot 2.0 进一步利用 fixation,将 gripper 信息规范化到 fixation-relative 的 SE(3) 坐标系,从而压缩待学习的动作分布。我们采集了 7 个真实任务与 6 个仿真任务的遥操作数据,并进行了 1000+ 次真机试验 与 1800 次仿真试验,在相同数据下对比 EyeRobot 2.0 与 passive stereo、ego + wrist camera 策略。 - 移除腕部相机对标准策略代价高昂:仅用 passive stereo 时,真实成功率从 52% 降至 27%。 - EyeRobot 2.0 仅用 stereo 即弥补该差距,真实环境超越 passive stereo 40%,仿真环境 20%。 - 当腕部视角清晰时,它与 ego + wrist 策略相当(69% vs. 64%);当抓取物体遮挡腕部相机时,成功率超过其两倍以上(48% vs. 22%)。
论文精读
TL;DR EyeRobot 2.0 模仿人眼主动注视,驱动立体相机动态对准操作点,结合中央凹视觉处理,仅用无手腕相机的立体视觉实现双臂精细操作,性能媲美带手腕相机策略,并在遮挡场景下成功率翻倍。
问题
问题背景
机器人操作学习领域当前关注如何利用视觉感知实现精细操作,尤其是从人类演示中学习技能。
现有方法局限
主流方案依赖 手腕相机 wrist camera 与 自我中心相机 ego camera 的组合,但手腕相机在抓取物体后常被遮挡,导致关键视觉信息丢失;仅使用 被动立体相机 passive stereo 时,视觉分辨率有限,难以支撑毫米级精细操作。此外,现有学习框架通常将视觉 token 均匀分配在整幅图像上,缺乏对任务相关区域的聚焦,计算效率与感知精度均受限制。
为什么这个问题难/重要
主动注视需要在任务执行中实时规划 注视点 fixation point,并与操作动作策略协同优化。这涉及 分层强化学习:低层注视伺服需在真实世界数据上训练,高层注视目标选择需与操作策略共同进化,工程挑战大。但若解决,可摆脱手腕相机依赖,降低硬件成本,提升遮挡鲁棒性,对产业界有吸引力。
行业类比
类似自动驾驶中的 主动传感器管理:根据驾驶场景动态调整激光雷达/相机注意力区域,以有限计算资源获取关键信息。
核心洞察
- 主动视觉注视通过物理转动立体相机与中央凹 token 分配,将有限的计算资源动态集中在任务相关区域,仅凭单个立体相机即可替代传统 ego + wrist 多相机配置。对比被动立体相机均匀采样导致成功率从 52% 降至 27%,EyeRobot 2.0 在相同数据下提升 40%,证明注意力机制比单纯增加分辨率或相机数量更关键。该方法模仿人类扫视行为,每次注视点切换都重新分配视觉计算,适合精细操作中局部高精度感知需求。
- 分层强化学习将注视策略分解为底层注视伺服与高层目标选择器,目标选择器与行为克隆策略协同训练,自动发现类似人类的扫视-注视序列,无需手工设计注视规则。与固定注视末端执行器或基于启发式切换的 baseline 相比,该框架从任务成功信号中隐式学习何时、何地注视,并能适应遮挡等动态变化,显著降低 RL 探索难度,同时为多阶段操作任务提供可解释的注意力轨迹。
方法
输入与感知
EyeRobot 2.0 仅使用单个立体相机(stereo camera)作为视觉输入。相机两目可以物理转动,将视线中心对准指定的 3D 注视点。图像处理采用 foveated architecture:对图像中心区域分配更多视觉 tokens,边缘区域压缩,模拟人眼中央凹的高分辨率集中计算。
关键模块
Active Visual Fixation (AVF)
- 低级 gaze servoing policy:以目标物体为条件,通过 RL 在真实世界数据上训练,使用稠密几何奖励,将注视点精确伺服到目标 3D 位置。
- 高级 target selector:根据任务进度(如抓取阶段、放置阶段)发出下一个注视目标。它与 BC gripper policy 协同训练,通过 RL 发现类似人类的注视序列,无需人工标注注视数据。
Fixation-Centric Action Chunking
将 gripper 的动作表示转换到 fixation-relative SE(3) 坐标系,即以当前注视点为参考系描述末端执行器的平移与旋转。这压缩了动作分布,降低策略学习难度。
输出
策略输出为双手 gripper 的动作 chunk(连续时间步的动作序列),直接控制机器人完成精细操作任务。
与同类被动立体视觉或依赖 wrist cameras 的方案相比,EyeRobot 2.0 通过主动注视与注视相对动作表示,在仅用单个立体相机时显著缩小性能差距,并对腕部遮挡和视觉干扰更具鲁棒性。
实验
实验设计
作者在 7 个真实世界任务(如 Tape、Pot、Toaster)和 6 个模拟任务上收集遥操作数据,训练并比较三类策略:EyeRobot 2.0(主动注视 + 单立体相机)、被动立体(无手腕相机)和 ego + 手腕相机 基线。真实世界执行 1000+ 次试验,模拟执行 1800+ 次试验,覆盖手腕视图清晰与被抓物体遮挡两种条件。
关键发现
- 移除手腕相机对标准策略冲击显著:真实成功率从 52% 降至 27%。
- EyeRobot 2.0 仅用立体相机即可追平或超越手腕相机策略:手腕视图清晰时 69% vs 64%;手腕被遮挡时 48% vs 22%。
- 与被动立体相比,EyeRobot 2.0 在真实世界提升 40 个百分点,模拟提升 20 个百分点。
对比解读
主动注视通过 注视中心动作表示(fixation-centric action chunking)和 中央凹图像架构 将计算聚焦于任务相关物体,弥补了缺少手腕相机的信息损失。在遮挡场景下优势显著,表明系统能自适应切换注视点,避免固定视角失效。而清晰视图中略高于 ego+手腕策略,可能说明注视机制与手腕视图信息存在部分冗余,但 EyeRobot 2.0 以更少的传感器实现同等性能。
行业影响
落地场景
EyeRobot 2.0 的核心是免腕部相机 的精细双手操控,仅依赖单一立体相机 + 主动注视。适合相机布局受限、需要高精度抓取与装配的场景:
- 仓储物流:机器人分拣小件、异形件时,无需在末端执行器上加装额外相机,降低硬件成本与布线复杂度。
- 实验室自动化 / 医疗辅助:精细操作(如移液、器械传递)中,相机可能被操作物遮挡,腕部相机失效,EyeRobot 2.0 可保持注视点稳定。
- 服务机器人:在狭小空间或人机协作环境中,单一外部相机即可支持双手操作。
商业价值
- 硬件降本:省去每个腕部的相机、同步与标定开销,简化产线集成。
- 鲁棒性提升:在遮挡情况下成功率提升明显(真实任务从 22% 到 48%),减少人工干预和停机。
- 数据效率:AVF 动作分块和注视相对 SE(3) 表示压缩了动作分布,可能降低模仿学习所需演示数量。
与现有工作流接口
- 可替换现有被动立体相机前端:保留已有的抓取策略网络,仅替换视觉编码器和加入注视控制模块。
- 训练流程采用BC-RL 联合,可直接接入现有演示数据采集管线;注视目标选择器与抓取策略并行训练。
- 推理时,注视伺服策略输出相机角度,需要电机驱动云台或复用机器人头部关节;若不改造硬件,可先用仿真或低成本双轴云台验证。
具体落地 use case
在电商订单履约的拣选机器人中,多 SKU 小件(螺栓、化妆品、电子元件)经常遮住腕部相机,使用 EyeRobot 2.0 可省去双臂共 4 个腕部相机,单套立体相机加两轴云台即可覆盖,减少维护点。在生物实验自动化中,移液管尖端可能遮挡操作视野,主动注视可保持任务相关区域高分辨率。
局限
- **硬件依赖与校准成本**:EyeRobot 2.0 依赖可动态调整注视方向的双目立体相机头,其机械结构、实时伺服控制与精确标定要求较高,实际部署时需额外维护。论文未详细讨论相机运动机构的寿命、标定漂移或不同硬件平台间的迁移性,这限制了该框架在低成本或固定相机机器人上的直接应用。对工程团队而言,引入主动注视硬件意味着额外的设计、标定和故障排查工作量。
- **真实世界 RL 训练开销**:注视伺服策略和目标选择器均在真实世界数据上通过 RL 训练,需要大量在线交互和奖励设计。尽管论文没有给出具体训练小时数,但基于 RL 的真实机器人训练通常比从离线演示学习更昂贵且存在安全风险。与纯 BC 方法相比,其数据效率和可扩展性可能受限,尤其在新任务或新环境中需要重新训练或微调,推高整体研发成本。
- **任务与场景泛化未充分验证**:实验覆盖 7 个真实任务和 6 个模拟任务,但主要集中在桌面双手操作场景,对更复杂的动态环境、透明或反光物体、大幅光照变化下的性能缺乏系统评估。此外,注视序列学习是否能够泛化到未见过的物体组合或布局,以及多机器人协作、移动操作等场景仍有待探索。与基于 wrist camera 的方案相比,其视野相对受限,可能遗漏手部附近的局部细节。