会下棋并解释自己走法的语言模型
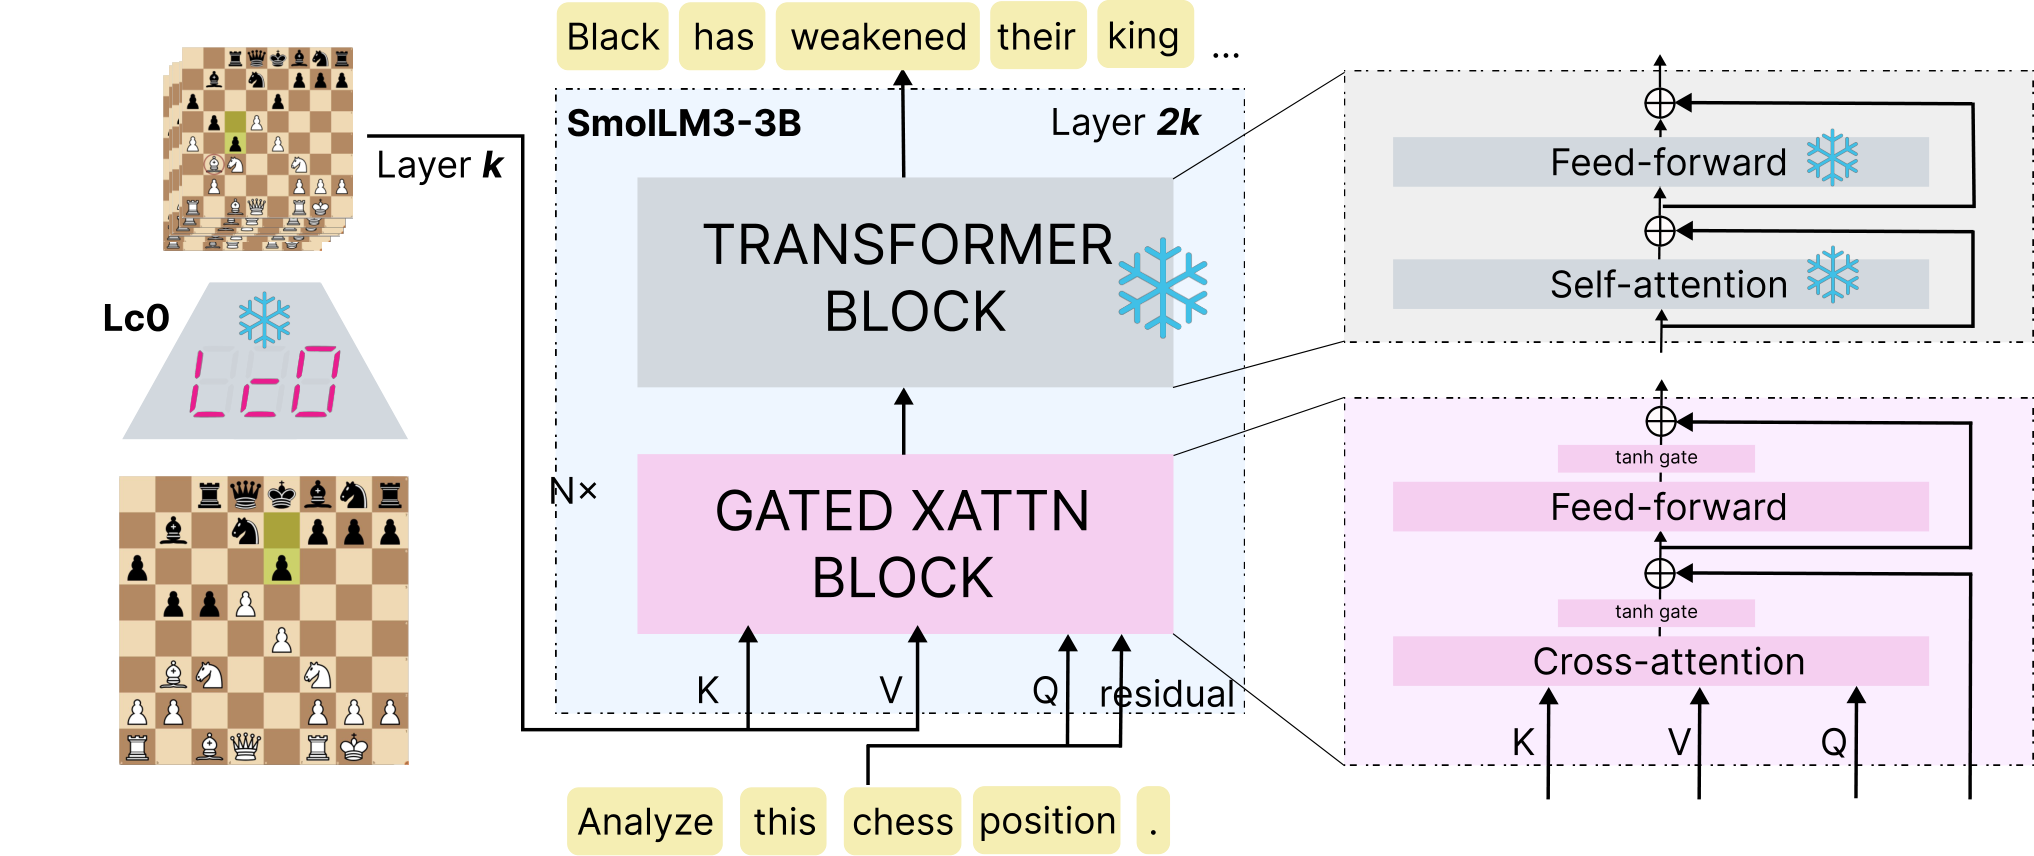
现代棋类引擎是沉默的专家:棋力超人,却不解释自己的走法;语言模型(LM)能生成听起来合理的解释,但棋力太弱,使其解释的实用价值受限。我们提出 Queen:一个 4B 参数的棋类语言模型,能以典型 Grandmaster 的水平对弈,并解释其走法与计划。 我们的新框架通过互补组件实现领域特定推理:编码器-解码器架构 与 迭代蒸馏算法。该架构用 cross-attention 将沉默的棋类专家编码器与指令微调 LM 结合,并以问答课程训练,从编码器的表示中提取棋类概念。 在此领域适配模型之上,我们用 Bellman 更新 的自然语言类比迭代改进解释:模型分析其最优候选走法之后的局面,整合为对当前局面的解释,再蒸馏回模型。经七轮迭代,模型 Elo 从 1782 升至 2697(提升超过 900 分),在棋力与题目准确率上大幅超越所有前沿模型,参数量却少三个数量级。 基于 LM 的评估显示,其解释流畅,连贯性接近 GPT-5.6-Sol (high)。该架构与训练流程具有通用性,为在存在沉默专家编码器的领域(游戏、机器人、计算机操作)应用语言模型提供了配方。
论文精读
TL;DR Queen 用 4B 参数将国际象棋引擎的隐性知识蒸馏进可解释语言模型,经七轮迭代自我改进达到 2697 Elo 特级大师水平,同时输出连贯走法解释,超越参数量大三个数量级的前沿模型。
问题
问题背景
当前棋类 AI 领域关注如何让模型既能达到专家级水平,又能提供可理解的决策解释。传统国际象棋引擎(如 Stockfish、Leela Chess Zero)依靠搜索与评估函数达到超人类棋力,但它们是“无声的专家”,无法用自然语言解释走法。而大型语言模型(LM)虽能生成流畅解释,但其棋力通常低于 1500 Elo,难以为解释提供可靠依据。
现有方法局限
- 纯引擎:输出仅为一个移动,缺乏概念性解释,用户无法理解背后的战略意图。
- 纯 LM 微调:直接让 LM 在棋谱上做监督学习,棋力提升有限,因为 LM 缺少搜索机制与精确评估能力;生成的解释常常“听起来合理”但与实际最优走法脱节。
- 浅层结合:已有工作尝试将引擎评分作为提示注入 LM,但未充分对齐引擎内部表示与语言空间,解释质量受限于模板或简单特征,无法捕捉深层局面概念。
为什么这个问题难/重要
难点在于:专家编码器(如 Leela 的隐藏状态)包含丰富的盘面信息,但它们是高维数值向量,与离散的自然语言符号之间存在巨大语义鸿沟;同时,训练一个模型同时优化棋力与解释能力容易导致灾难性遗忘或两者皆弱。业界对可解释 AI 的需求日益增长,尤其是在高风险或需要人类协作的决策场景(如棋类训练、策略分析),一个既能下得好又能讲清理由的模型具有显著应用价值。
行业类比
类似自动驾驶系统不仅要决策正确,还要向乘客解释“为什么这样变道”;或医学诊断模型既要准确又要给出可验证的推理依据。
核心洞察
- 将 silent expert chess encoder 与指令微调 LM 通过 cross-attention 桥接,并用 QA 课程从编码器隐状态中蒸馏棋弈概念,使模型既能下棋又能解释。这不同于直接给 LM 棋盘文本或仅用棋谱微调,它保留了专家引擎的精准评估,同时让 LM 学会用自然语言阐述这些内部表征,解决了“弱棋手解释不可信”与“强引擎无解释”的矛盾。
- 自然语言 Bellman 更新作为迭代蒸馏:模型分析其候选着法之后的局面,并将这些分析整合为当前局面的解释,再蒸馏回自身。这种自我改进循环与传统的拒绝采样或 RLHF 不同,它利用搜索产生的后续局面信息来反向生成更连贯、更有根据的解释,七轮迭代获得 900+ Elo 提升,表明解释质量与棋力可以相互促进。
方法
输入与架构
Queen 接收棋局状态作为输入,采用 编码器-解码器 架构。其中编码器是一个不输出自然语言的国际象棋专家模型,负责产生高维棋盘表示;解码器是指令微调的语言模型,通过 交叉注意力 层在生成每个 token 时读取编码器的隐藏状态,实现棋类知识与语言生成的融合。
两阶段训练
- 领域适配:使用问答课程训练模型,从专家编码器的隐藏状态中提取棋类概念(如子力、王安全、开放线等)。初始种子解释由前沿 LM 蒸馏得到,让解码器学会将编码器表征转化为自然语言棋评。
- 迭代搜索蒸馏:核心创新是自然语言版 Bellman 更新。对当前局面,模型先分析其 top 候选着法之后的子局面,再将这些子局面分析归纳为当前局面的解释,并将归纳结果蒸馏回模型自身。经过 7 轮迭代,棋力从 1782 Elo 升至 2697 Elo,同时解释连贯性接近 GPT-5.6-Sol (high)。
输出
模型同时输出候选着法与自然语言解释,解释既可作为自我对弈的思考过程,也可供人类理解。
与同类工作相比,Queen 通过架构级融合与迭代自蒸馏,首次让不足 4B 参数的模型同时达到大师级棋力与可读解释,而非仅用 LLM 事后解释棋步或依赖超大模型。
实验
实验设计
作者采用两阶段训练策略:
- 域自适应:用 QA 课程让 LM 通过 cross-attention 从 silent chess encoder 的隐藏状态中提取国际象棋概念。
- 迭代搜索蒸馏:以自然语言版 Bellman update 迭代七轮,每轮分析 top 候选着法后的局面,合并成解释再蒸馏回模型。
关键发现
- Elo 提升 900+:从初始 1782 跃升至 2697,达到典型特级大师水平,远超所有 frontier models 的下棋强度与谜题准确率。
- 参数效率:仅 4B 参数,比前沿模型少三个数量级,却在下棋与解释任务上实现超越。
- 解释质量:LM 评估显示流畅度与连贯性接近
GPT-5.6-Sol (high),说明专用架构能在保证棋力的同时产出可理解的解释。
基线对比解读
对比 frontier models(如 GPT-5.6-Sol),Queen 在专有任务上展现明显优势:领域专用 encoder 提供强先验,配合迭代蒸馏逐步强化推理深度,避免了通用 LM 在棋盘局面上的浅层幻觉。该方法提示:在游戏、机器人、计算机使用等具备 silent expert encoder 的领域,采用 encoder-decoder + 迭代自蒸馏的路径,可能以更小模型达到超过大模型的领域性能。
行业影响
落地场景
Queen 展示了一种可复用的“静默专家 + 语言解释”范式,可直接落地到在线棋类教育与对战平台:平台可嵌入该模型作为 AI 对弈引擎,同时生成自然语言走法理由,用于课程交互、赛后复盘与难度分级练习。另一个场景是企业决策辅助(如金融交易合规审查、供应链调度),将已有规则引擎或优化求解器作为 silent expert,通过类似架构输出可审计的决策解释,降低人工复核成本。
商业价值
模型仅 4B 参数 却达到 2697 Elo,推理成本远低于 frontier LLM,适合高频、低延迟的实时互动场景;可解释性提升用户信任与留存,例如教育产品可从“纯对弈”升级为“AI 私教”订阅服务,带来增收。对开发者而言,迭代式自蒸馏(Bellman 更新)减少了对昂贵人工标注或大模型蒸馏的依赖,显著降低数据成本。
与现有产品/工作流接口
Queen 的 encoder-decoder + cross-attention 设计允许将现有专家系统(如国际象棋引擎 Stockfish、Leela Chess Zero)作为编码器,前端 LM 负责自然语言输出;可以通过 API 微服务 替换原有静默决策组件,输出结构为 {move, explanation, evaluation}。若企业已有领域专家模型,可复用其隐藏状态,运行 3-5 轮 iterative distillation 微调,快速适配到新任务(如机器人路径规划、药物分子筛选)。代码开源在 GitHub,便于集成实验。
局限
- 依赖**专家编码器**与**前沿 LM 标注**:方法要求已有 silent expert encoder(如 Leela Chess Zero)提供可解释的中间表示,且初始蒸馏依赖 GPT-5.6-Sol 的标注,这限制了在没有强专家系统或高质量语料的领域直接复用。虽然作者宣称可迁移至 robotics、computer use,但论文仅在 chess 验证,泛化性尚未得到实证。
- **解释质量评估主观性**:coherence 主要靠 LM-based 判断(GPT-5.6-Sol 打分),缺乏人类大师的系统性核验。模型可能在走法质量较高时解释合理,但在出现错误时仍能生成流畅但误导性的解释,无法确保解释忠实于实际决策过程,特别是模型可能“事后文饰”而非真实反映搜索计算。
- **计算成本与迭代可扩展性**:迭代蒸馏需要每轮对大量 seed 位置递归采样候选走法、生成后续局面并 consolidating,再执行 SFT,虽然最终模型仅 4B,但数据生成和多次训练的资源消耗显著;论文未报告具体 GPU 时数或能耗,难以评估实际部署门槛。