4DCodeBench: 在动态场景逆图形学上评测智能体
我们提出了 4DCodeBench,一个通过代码生成实现 4D 逆图形学 的基准测试:智能体需要从视频中重建动态场景,并输出可执行的图形程序。为完成这一任务,智能体必须把视觉观察转化为场景结构与动态的紧凑表示,并通过实现物理模拟等抽象来复现复杂行为。 为评估这一能力,我们收集了一批真实世界视频,并构建了涵盖多种物理现象的合成场景,包括形变、流体流动与断裂。 我们对前沿模型进行了大规模评测,发现:强大的静态重建能力尚不能转化为对复杂动态的可靠重建。 4DCodeBench 为追踪智能体通过代码理解世界动态的进展提供了测试平台。基准已开源于 https://github.com/4DCodeBench/4DCodeBench
论文精读
TL;DR 4DCodeBench 通过让智能体编写图形代码从视频重建动态场景,评估其对形变、流体、断裂等物理动力学的理解;评测显示前沿模型的静态重建能力很强,但复杂动态重建仍不可靠。
问题
问题背景:4D 逆图形学正成为连接视觉感知与可执行世界模型的关键路径,目标是从动态视频中恢复结构、形变与物理参数。近年来静态场景的“视频转代码/图形程序”已展示出强泛化性,但动态场景仍以 neural fields 或生成式视频为主,无法提供显式几何与可交互表示。
现有方法局限:静态逆图形基准(如仅处理刚体和固定拓扑的代码生成)难以迁移到连续动态;常见的 NeRF/3DGS 系列依赖逐帧优化或测试时训练,缺乏场景级物理抽象,不能输出可复用的 simulate() 程序。对变形、流体、断裂等拓扑变化,现有指标多用 RGB 重建误差或 FID,无法评估几何时序一致性与物理合理性。因此模型在静态 PSNR 上表现良好,但无法保证 mesh.deform() 后仍符合质量守恒/接触约束。
为什么难/重要:从视频推理物理参数是病态逆问题:单目输入存在深度/运动歧义,且不同物理参数可产生相似外观。要写出可执行的动态图形程序,需同时完成几何解析、参数辨识、符号化抽象与离散/连续模拟选择,搜索空间远大于静态重建。工业界对可物理仿真的场景表示有明确需求:数据生成、机器人训练、仿真测试都依赖从真实视频自动构建可编辑 4D 资产。
行业类比:这类似自动驾驶需要的“视频→可仿真世界模型”——把一段真实交通视频转换为物理引擎中的可编程场景,用于闭环验证感知与规划策略。
核心洞察
- 将 4D 逆图形任务定义为代码生成,迫使智能体用可执行图形程序显式编码场景结构与动力学,而非隐式神经表示。这种做法独特在:现有逆图形基准大多输出静态网格或神经场,难以表达形变、流体、断裂等复杂动态;4DCodeBench 要求智能体自行实现物理模拟等抽象,检验其从视觉观测中提炼可泛化、可解释的世界模型的能力。
- 评估动态重建不能仅依赖逐帧渲染相似度,4DCodeBench 同时检查几何量随时间的演变(如动态 IoU、轨迹 DTW、流体 EMD),并揭示强静态重建能力不能可靠迁移到复杂动态。这一发现与同类工作形成关键差异:许多基线在静态场景上表现良好,但面对快速运动或拓扑变化时失败,说明需要专门针对时间一致性与物理合理性的评估协议,为后续模型改进指出方向。
方法
任务形式化
4DCodeBench 将 4D 逆向图形定义为 代码生成任务:输入一段真实或合成的动态场景视频,代理需输出一个可执行的图形程序(如 Python 脚本),该程序显式表达场景结构、几何与动力学。输出代码必须遵循规定格式(附录 G.3),包含 相机 (Camera)、网格 (Meshes)、动态 (Dynamics)、液体 (Liquids)、渲染 (Render)、检查 (Checks) 等模块,从而能够从零重建并渲染出与输入视频一致的动态场景。
数据集构建
基准包含 200 个场景,均衡分为两部分:
- 100 个真实视频:来自日常动态现象,涵盖刚体、弹性体、流体等运动模式;
- 100 个合成场景:由多个物理模拟器生成,覆盖变形、流体流动、断裂等复杂物理行为,保证真值几何与动力学参数已知。
评估流程
代理生成的程序在统一沙箱中执行,重新渲染为视频;随后从以下两方面进行度量:
- 渲染质量:使用 DINOv3 相似度、动态 IoU、深度误差、光流误差等指标,逐帧比较渲染输出与输入视频;
- 几何与动力学一致性:对合成场景提取随时间变化的几何,计算 3D 轨迹 DTW、场景注册误差、EMD step 等指标;真实视频则通过深度、光流和 2D 轨迹评估。
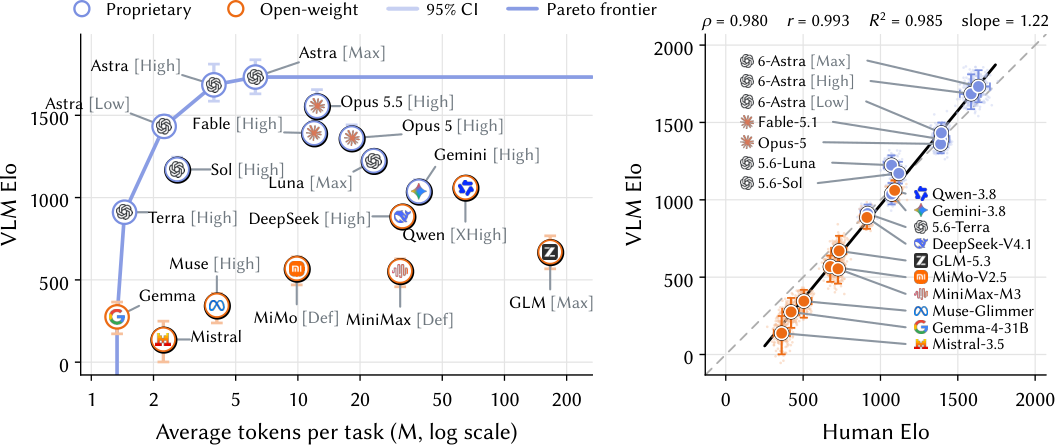
此外引入 VLM 成对排名 和人工评分,校准各自动指标与人类判断的 concordance。
与同类方法的差异
与静态 3D 重建基准不同,4DCodeBench 要求代理通过可执行代码显式建模动力学而非直接回归神经场,直接检验模型对物理规律的抽象与程序化表达能力。
实验
实验设计
4DCodeBench 提出一个通过代码生成完成 4D 逆图形 的基准任务:给定输入视频,智能体需要编写可执行的图形程序(如物理模拟)来重建动态场景,并将程序渲染回视频进行验证。数据集包含 100 个真实视频 与 100 个合成场景,覆盖变形、流体、断裂等物理现象。评估结合渲染相似度、几何精度与可执行性等指标,并对 18 个前沿模型进行了基准测试。
关键发现
实验结果显示,当前模型在静态场景重建上表现尚可,但在复杂动态重建上可靠性显著不足:
- 静态重建能力与动态重建能力之间存在明显落差,强大的静态重建能力并不能可靠地迁移到复杂动态上。
- 对于涉及物理模拟(如流体、断裂)的场景,模型倾向于输出无法执行或视觉偏差大的程序。
- 推理时推理(inference-time reasoning)的作用仍需进一步验证,现有结果未显示其能显著弥补动态重建的不足。
与同类工作对比及工程启示
相比仅评估静态几何或单帧深度估计的基准,4DCodeBench 将任务推进到 可执行世界模型 层面,要求智能体具备物理抽象与代码生成能力。对实际工程的启示是:在构建视频理解或世界模型系统时,不能只优化像素级预测指标,需要引入代码生成作为中间表示,并验证其可执行性与物理一致性。该基准可作为跟踪 AI 智能体动态世界理解能力的测试平台。
行业影响
落地场景
4DCodeBench 评估的“视频到可执行 4D 代码”能力,可落地于多个 AI 产品线:
- 数字内容创作:从单目视频自动生成可编辑的动态 3D 资产(含物理模拟),服务游戏、影视特效、XR 内容。
- 电商展示:将商品视频转为可交互 3D 动态模型,用户可旋转、缩放、触发物理交互(如布料折叠、液体倾倒),提升详情页转化。
- 自动驾驶 / 机器人仿真:从真实路采视频重建动态场景(变形、流体、断裂),自动生成仿真环境,加速感知与控制算法训练。
- 企业数字孪生:监控视频实时重建工业设备动态行为,辅助故障预测与维护规划。
商业价值
主要降本增效:传统 4D 内容制作依赖美术手工建模与动画,单场景成本高、周期长。若模型可靠,可大幅压缩到分钟级。同时,动态交互展示 能提升电商转化率与用户停留时长,带来直接增收;仿真环境自动生成可降低自动驾驶数据采集与标注成本。
与现有工作流接口
生成的代码可直接对接 Blender / Unreal Engine / Unity 等引擎,作为插件或资源导入管线。评测可集成到模型研发 CI,并可与静态重建工具(NeRF / 3DGS)组成两阶段流水线:先静态几何,再推理动力学。
具体 use case:电商平台将商品视频上传后,自动生成带物理属性的 3D 模型(如衣物垂坠、液体流动),替代静态 360° 图集;自动驾驶公司用该能力从城市道路视频批量构建动态仿真场景,覆盖罕见事故与极端天气,降低实车测试成本。
局限
- 4DCodeBench 包含 100 个真实视频和 100 个合成场景,物理现象覆盖变形、流体、断裂等,但类别仍然有限,难以全面反映真实世界的动态复杂度。真实视频的 ground truth(如深度、光流、轨迹)获取依赖传感器或人工标注,存在噪声和不完整性;合成场景虽可控,但其渲染外观和物理参数分布与真实数据存在域差距。此外,每个场景的时长和交互复杂度未详细说明,可能影响对长时依赖和复杂多物体交互的评估。该基准目前只支持单目视频输入,未覆盖多视角或 RGB-D 等更丰富的观测模态。
- 现有指标主要基于低层视觉相似性(如 DINOv3 similarity、Dynamic IoU、深度误差、光流等),难以捕捉重建结果在语义正确性、物理合理性和因果结构上的对齐程度。VLM-based pairwise rankings 和 VQA gating 引入了模型主观判断,而这些 VLM 本身可能存在偏见或对特定物理现象理解不足,且其评估一致性未经验证。附录中的 metric concordance 分析显示指标间存在分歧,单一指标不能全面反映重建质量。此外,可执行性作为硬性门槛可能过度惩罚因环境配置或 API 误用导致的运行失败,而非真正的理解缺陷。
- 基准要求智能体输出可执行图形代码,并限定使用特定编程接口(如物理仿真库和渲染器)。这种设定虽然保证了可复现性,但也限制了模型自由选择表示形式(如神经隐式场、粒子系统或学习到的动力学模型)的能力。执行环境对代码鲁棒性敏感,模型可能因微小的语法或 API 错误被判定失败,尽管其高层理解正确。此外,测试模型均为通用大语言模型,并未针对 4D 理解或物理推理进行专门微调,因此结果可能低估了定制模型在该任务上的潜力。基准未提供物理先验或仿真器反馈,完全依赖零样本代码生成,使任务难度较高,但也更接近真实世界的通用智能要求。