从蒸馏私有健康记录中进行智能体驱动的血液生物标志物发现
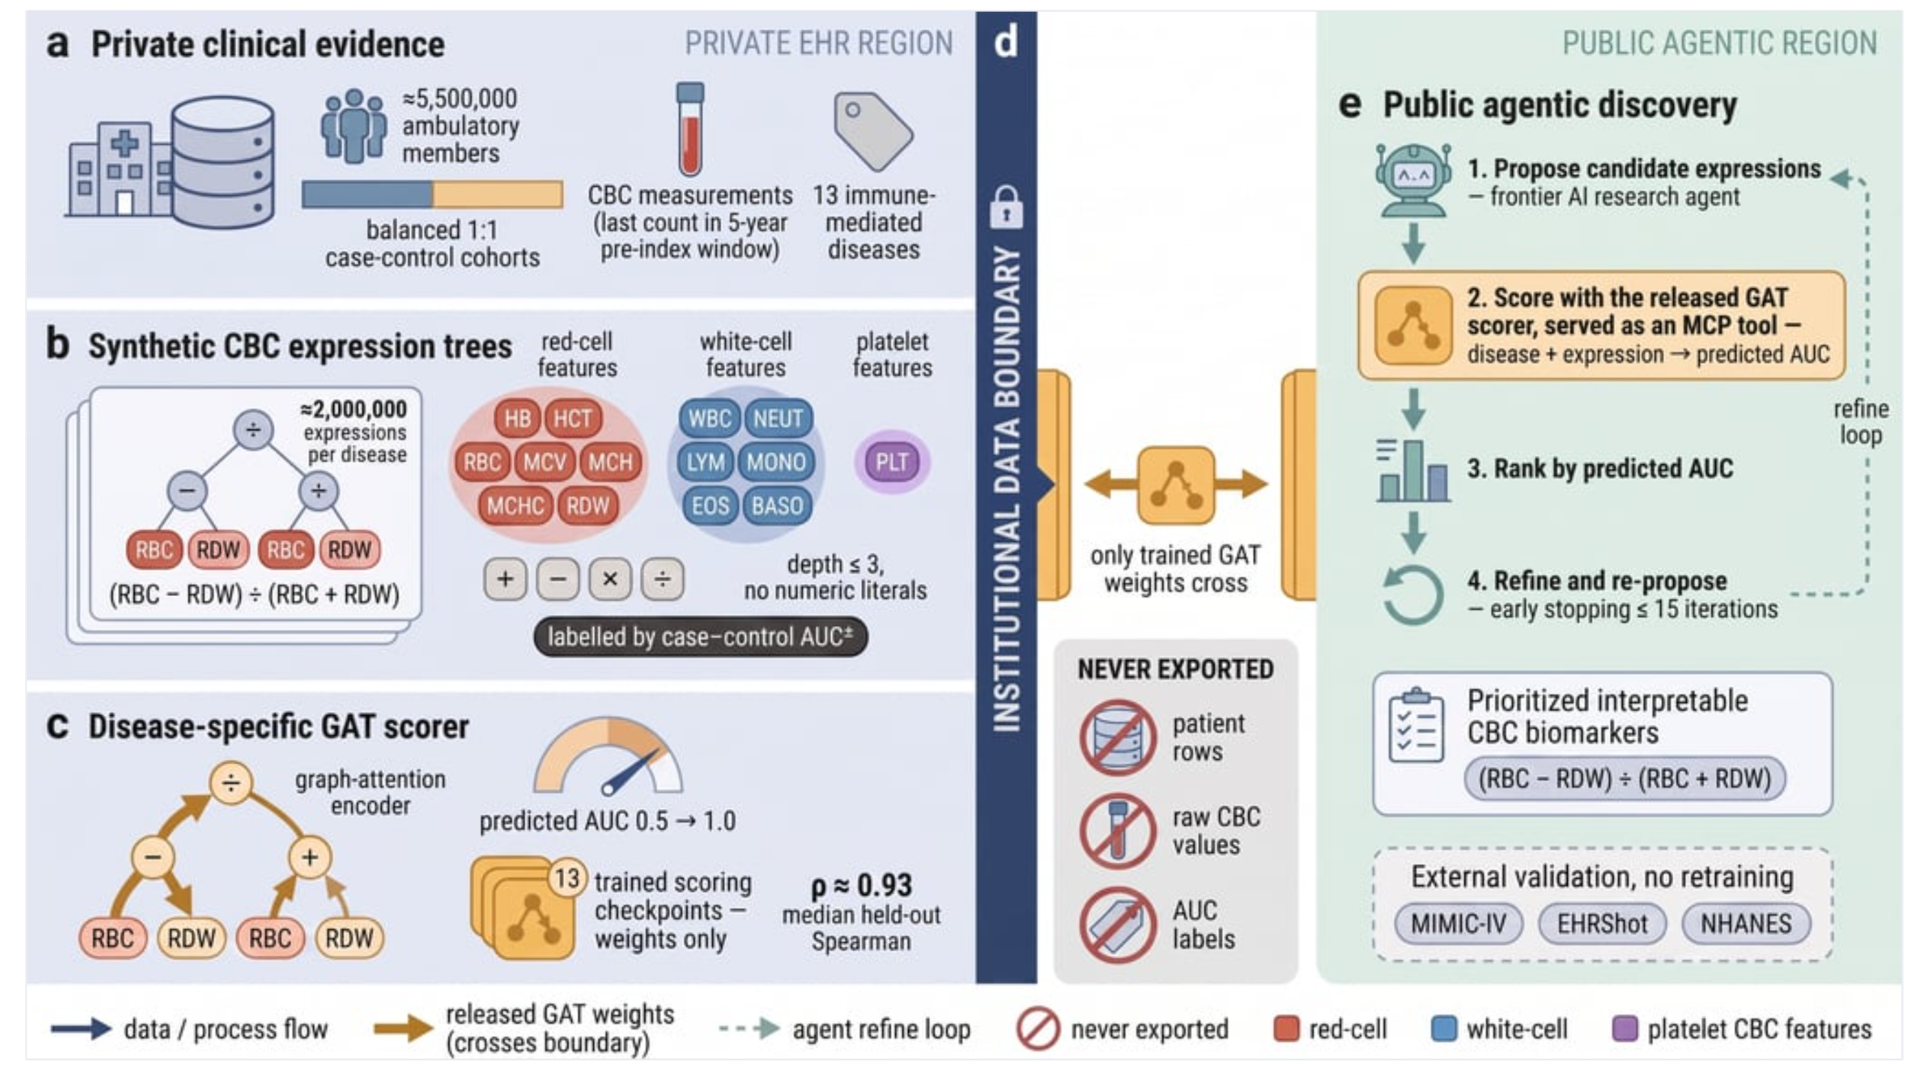
常规全血细胞计数(CBC) 有望产出新的生物标志物,但评估候选指标所需的私有记录无法与擅长科学发现的前沿语言模型智能体共享。 为此,我们构建并公开了一个评分工具,把 Clalit Health Services 逾 540 万 患者群体中的证据蒸馏出来:针对 13 种免疫介导疾病,在数据边界内部训练图注意力网络,预测候选 CBC 表达式的病例对照 AUC,并且只发布训练后的权重。该工具让智能体的 propose-score-refine 循环锚定在真实世界数据上,而不暴露任何患者数据。 在外部验证中: - 智能体发现的表达式相比其文献初始起点,中位提升 4.18 个 AUC 百分点; - 在三个独立队列中,对三个前沿研究工具所给候选进行重排序,在多数比较中优于其首选结果,增益随队列而异。 该评分器的发布支持隐私保护的生物标志物假设生成。
论文精读
TL;DR 从 540 万患者私有病历中蒸馏出可发布的 GAT 评分器,供 LLM 智能体进行“提出-评分-优化”循环发现血液生物标志物,外部验证 AUC 中位数提升 4.18 个百分点。
问题
问题背景
常规血液检查(如全血细胞计数,CBC)是临床最普遍的检测之一,其多种参数组合可能构成新的疾病生物标志物,尤其在免疫介导疾病中。当前 AI 社区正尝试用语言模型代理(LLM agents)自动提出并优化候选生物标志物表达式,但医疗数据的隐私限制成为关键瓶颈。
现有方法局限
LLM agents 虽能基于文献生成大量候选表达式,但缺乏真实患者数据来评估其判别能力(如 case-control AUC)。直接让代理访问私有健康记录违反隐私法规,去标识化也不足以消除重识别风险。传统联邦学习避免了原始数据外传,但无法支持代理的交互式 propose-score-refine 循环,因为每次评分都需在数据本地执行,通信与计算开销过大。此外,用合成数据替代真实数据往往导致代理发现的经验无法迁移到真实队列,外部验证时性能大幅下降。
为什么这个问题难/重要
医疗数据同时具有高价值和高度敏感性,任何数据使用都必须满足严格的合规要求。该问题位于隐私保护机器学习与生成式 AI 的交叉点:既要释放 LLM 的科学发现能力,又要确保患者级信息不被泄露。技术上,挑战在于如何将 540 万患者的高维纵向数据压缩为一个紧凑的评分模型(如图注意力网络 GAT),且该模型权重只编码群体统计规律,无法反推个体记录,同时仍能准确评估任意候选表达式的预测性能。业界对可发布的隐私保护评分工具需求迫切,因为它能打破数据孤岛,加速标志物发现流程,减少无效实验。
行业类比
该思路类似于在金融反欺诈场景中,利用差分隐私训练一个欺诈评分 API,外部分析师可查询任意交易特征组合的风险分数,但无法获取底层交易明细,从而在合规前提下赋能生态创新。
核心洞察
- 该工作通过将私有健康数据蒸馏为可发布的 GAT 评分器,使 LLM agent 在 propose-score-refine 循环中利用真实数据反馈,从而在不暴露患者数据的前提下发现血液生物标志物。与联邦学习或差分隐私合成数据不同,该方法只发布模型权重作为工具,不传输原始数据或梯度,同时保留判别能力;LLM agent 负责探索表达式空间,评分器提供真实队列的 case-control AUC 信号,形成闭环。这种“模型即工具”的范式为敏感数据驱动的 AI 发现提供了新的工程路径。
- 训练得到的 GAT 模型接受 CBC 表达式树并预测 AUC,不仅用于 agent 打分,还通过 Shapley 归因解释发现的生物标志物,并可用于重排其他 LLM 系统生成的候选。以前的 LLM 生物标志物研究缺乏数据验证或只能依赖小规模开放数据,该工作提供了一个冻结权重工具,可在三个独立队列中重排候选,且多数情况下改进首选,表明模型蒸馏的通用性和可复用性,为后续研究提供了可解释的验证基础设施。
方法
输入
- 私有队列:Clalit Health Services 的 5.4M+ 患者常规全血细胞计数(CBC)数据以及 13 种免疫介导疾病的表型标签。
- 候选空间:CBC 表达式树,由基础 CBC 参数(如白细胞、血红蛋白、血小板等)通过算术运算与组合构建,作为潜在生物标志物。
关键模块
- GAT 评分器蒸馏:在数据边界内训练一个图注意力网络(GAT),以预测任意候选表达式在每种疾病上的 case-control AUC。训练仅使用开发队列,不暴露个体数据;释放模型权重作为评分工具,替代原始数据访问。
- Agent propose-score-refine 循环:LLM agent 生成候选表达式,调用释放的 GAT 评分 API 获取 AUC 估计,然后根据得分迭代优化表达式(可类比强化学习的提议-评估-细化)。
- 外部验证与消融:将发现表达式在三个独立队列上验证;同时进行随机评分消融、单 CBC 特征基线和 Shapley 归因分析,确认评分器贡献与生物学合理性。
输出
- 排序后的 CBC 表达式候选,每个对应一种免疫介导疾病的预测性能(AUC)。
- 在外部验证中,agent 发现的表达式相对文献种子表达式中位数 AUC 提升 4.18 个百分点;在重排序三种前沿研究工具候选时改善首选项。
跟同类方法的差异点:通过释放训练好的 GAT 评分权重而非共享数据,实现了隐私保护下的数据驱动生物标志物假设生成,使 LLM agent 能在真实世界证据约束下搜索,而无需接触私有记录。
实验
实验设计
在私有数据边界内训练 图注意力网络 (GAT),将 CBC 表达式作为图节点,仅释放训练权重作为评分工具,驱动 agent 的 propose-score-refine 循环。外部使用三个独立队列验证;并设置随机评分消融、单 CBC 特征基线和 Shapley 归因等对照。
关键发现
- agent 发现的表达式相比文献种子中位提升 4.18 个 AUC 百分点。
- 对三个前沿 LLM 工具生成的候选重新排序,在多数比较中改善了首选结果。
- Shapley 归因显示所发现表达式大多恢复了已知血细胞计数生物学。
- 但泛化性在不同外部队列间并不一致(见 2.2 节)。
与基线对比解读
与直接让 LLM 自由生成相比,用真实世界数据评分器接地可有效减少幻觉,提升假设质量。私有数据蒸馏成模型权重是一种实用的隐私保护协同机制,评分工具以 API 形式发布,无需暴露患者数据即可支持假设生成。然而中位提升幅度温和,且跨队列波动明显,提示需进一步研究归一化策略或领域自适应,以增强模型在异质人群上的稳健性。
行业影响
落地场景
该工作发布了一个隐私保护生物标志物发现工具:在私有健康记录上训练图注意力网络 (GAT),仅开放模型权重 API,使 LLM agent 可在不出域的情况下执行 propose-score-refine 循环。典型落地场景包括:
- 药物研发管线的早期靶点发现:制药企业无需直接访问患者数据,即可用 LLM agent 筛选血液学标志物候选,加速临床前研究。
- 临床决策支持系统:医院或健康平台可集成该 scorer,辅助医生解读血常规中的复合指标,提升疾病早期筛查能力。
- 健康数据协作平台:作为隐私计算或数据中介的轻量替代方案,让数据持有方安全地提供模型推理服务,促进多方协作。
商业价值
- 降本:无需建立复杂的数据共享协议或安全计算环境,直接调用模型 API 即可迭代探索,显著降低数据治理与合规成本。
- 增收:发现的新 biomarker 可形成专利或授权,带动诊断试剂、数字生物标志物产品收入。
- 体验提升:提高诊断准确率与时效性,同时强化患者隐私保护,增强数据提供方的信任与合作意愿。
与现有产品/工作流的接口
该工具以 API 形式发布(gat_agent_tool),可直接嵌入现有 LLM agent 框架(如 LangChain、AutoGen)。典型集成流程:
- Agent 生成 CBC 表达式树候选;
- 调用 scorer API 获取预测 AUC 分数;
- 根据反馈迭代优化候选;
- 将 top 候选交予下游湿实验或外部队列验证。
现有医疗数据分析平台(如 OHDSI、FHIR 生态)可通过适配器将标准化检验数据转换为表达式输入,复用该工具。
具体落地 use case:一家生物科技公司在自身免疫疾病管线中,使用 LLM agent 基于公开文献种子和该 scorer,在类风湿关节炎和系统性红斑狼疮上迭代发现新的血细胞比率组合,用于患者分层或治疗响应预测;一家远程医疗平台分析用户上传的血常规报告,调用该工具计算复合指标风险分,结合其他健康数据提供个性化健康建议,全程无需接触原始私有数据。
局限
- **泛化性有限**:论文在三个独立外部队列上验证时,agent 发现的表达式并非一致提升性能,且候选重排增益因队列而异。摘要中明确提到『did not uniformly generalize across three external validation cohorts』,表明评分器可能过拟合于 Clalit Health Services 的特定人群特征(如种族构成、医疗实践模式、年龄分布)。对于数据分布差异较大的其他真实世界数据集,工具给出的预测性能可能与实际偏差较大,限制了其作为通用生物标志物筛选工具的可靠性。
- **应用范围狭窄**:研究仅覆盖 13 种免疫介导疾病,且评分器基于单一私有队列训练。该队列来自以色列的 Clalit Health Services,人口统计学和医疗记录特征不同于全球多样化的患者群体。此外,工具只输出表达式的预测 AUC,不提供生物学机制或临床可解释性线索,需要额外的下游验证才能确认候选标志物的真实价值。对于其他疾病领域,需要重新训练评分器,无法直接复用现有权重。
- **搜索空间受限于 LLM 生成能力**:propose–score–refine 循环依赖于 LLM 提出的候选 CBC 表达式,而 LLM 的训练数据中可能缺乏对罕见或复杂组合的先验知识,导致搜索偏向常见表达式,遗漏潜在的高价值特征。论文未系统评估不同 LLM 或生成策略对发现质量的影响,也未展示 agent 是否能够稳定复现最优结果。此外,发布的 GAT 仅是一个评分器,不能主动探索表达式空间,因此方法的创新性更多在于隐私保护框架而非发现算法本身。