LiFT: Loop Flow Transformers
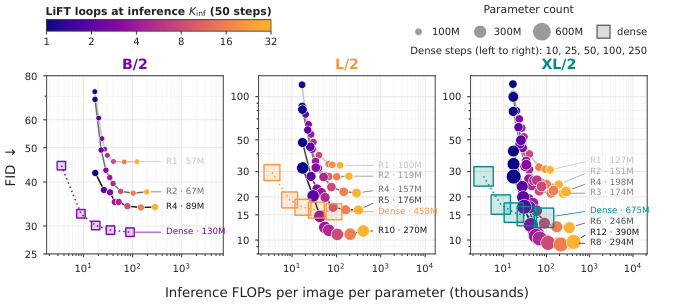
LiFT(Loop Flow Transformers) 是一类循环式生成模型,其核心思路是反复调用一个共享的 Diffusion Transformer(DiT) 主干来扩展计算量,而对标准架构只做轻微改动。 方法上,LiFT 并不要求每个循环步都直接给出最终预测,而是让每一步只学一个回归目标:从模型初始估计通往 flow matching 目标点的一条直线路径上的某一点。由于这些目标由一个连续的深度坐标索引,训练好的模型可以在不重训、不做 early exit 或任何其他修改的情况下,循环远超其训练深度。 实验表明,更长的 rollout 能提升生成质量,因此推理计算量可以随需求增长而无需增加参数量。在 ImageNet 256x256 上,LiFT-L/2 相比稠密基线 DiT-XL/2 的 FID 低 3.34 点,同时参数量约少 60%,训练 FLOPs 少 32%,推理 FLOPs 少 52%。
论文精读
TL;DR LiFT 让共享 DiT 核心循环执行,以连续深度坐标回归流匹配路径上的点,训练后可在推理时任意加深循环、无需重训,从而用更少参数与 FLOPs 显著降低 FID。
问题
问题背景
生成模型(扩散模型与流匹配)已成为高保真图像生成的主流技术路线,但 计算可扩展性 尚未充分解决:如何在推理时根据算力预算灵活调整计算量,同时避免参数膨胀,是当前业界关注的焦点。
现有方法局限
传统 Diffusion Transformer (DiT) 采用固定深度前馈结构,每个 token 仅经过一次网络,推理 FLOPs 固定,无法伸缩。循环 Transformer 尝试共享权重、重复应用核心模块,但面临三个技术瓶颈:
- 训练信号冲突:若要求每个循环步直接预测最终输出,多个监督目标会相互干扰,导致优化困难。
- 深度泛化能力弱:模型只在固定循环步数下训练,推理时增加步数会进入训练分布外的深度域,生成质量急剧下降,难以获得「算力换质量」的收益。
- 额外控制开销:部分方法依赖早停机制或额外控制器决定展开步数,引入新参数和超参,削弱了循环模型的简洁性。
为什么这个问题难/重要
深度泛化是循环生成模型的核心障碍:推理深度的增加意味着更强的表征能力,但若模型无法稳定泛化到更深的展开,则算力扩展无从谈起。LiFT 通过连续深度坐标与直线回归目标,将深度从离散步数转化为连续变量,使模型在训练时覆盖一个深度区间,从而能在推理时无修改地循环到任意深度。这一特性对实际部署意义重大:同一个 checkpoint 可适配不同算力场景,无需重新训练或多版本管理,显著降低推理成本与工程复杂度。
行业类比
这类似于 大语言模型 中通过增加推理步数(如 chain-of-thought)来提升复杂任务表现的做法——LiFT 在生成模型中实现了类似的 算力换质量 机制,让图像生成的推理预算成为可调参数。
核心洞察
- LiFT 的核心创新在于把循环生成每一步的监督目标从最终样本换成了直线路径上的中间点,并用连续深度坐标索引这些目标。这样模型在训练时学会的不是逐步逼近最终结果,而是学会在任意深度位置对当前估计进行正确修正。与固定步数循环 Transformer 或逐步预测最终图像的 baseline 不同,LiFT 可以在推理时自由增加循环步数,无需重新训练或早退出机制,生成质量随深度提升,实现了对训练深度之外的外推。
- LiFT 将生成模型的扩展方向从增加参数转向增加循环深度:共享同一个 DiT 核心,把计算量作为可调的资源维度。在 ImageNet 256×256 上,LiFT-L/2 的 FID 比 dense DiT-XL/2 低 3.34,同时参数减少约 60%、训练 FLOPs 减少 32%、推理 FLOPs 减少 52%。这提供了一种新的 scaling 视角——在固定参数预算下用更多循环步换取质量,而不是依赖更大的模型容量,对需要控制推理成本的工程场景有直接借鉴意义。
方法
输入与核心模块
LiFT 将生成过程分为流匹配时间与循环深度两个维度。输入为标准 DiT 的初始噪声与时间步,核心是一个共享的 DiT core,作为循环单元反复应用。每次迭代输出对最终样本的估计,同时该估计或中间特征被反馈至下一迭代。关键修改是在标准 DiT 架构中注入一个连续深度坐标,使模型感知当前循环步数;该坐标通过额外嵌入或条件调制融入 token 表示。
监督与训练
训练时,每个循环步不直接监督最终干净样本。给定流匹配目标,在模型初始估计(通常为第一遍输出或噪声)与目标之间的直线路径上采样一个点作为回归目标。每一步使用同一损失函数(如 MSE)逼近该点,损失权重由深度坐标决定。附录指出,使用随机深度坐标比固定值更利于训练深度之外的外推,并引入一个轻量prelude loss 防止初始估计锚点漂移。
推理与输出
推理时选择一个深度预算(可远大于训练深度),模型按该次数循环应用。最终样本来自最后一次迭代输出,或结合流匹配时间步采样。由于深度坐标连续,模型无需重新训练或早退即可深度外推。实验证明,增加循环次数能降低 FID,而参数量不变,推理 FLOPs 按深度线性增长。计算资源可在深度与流匹配时间两个维度灵活分配。
与同类方法差异:不同于循环 transformer 中常见的逐步预测最终目标或早退机制,LiFT 以直线路径中间点作为统一回归目标,结合连续深度索引,实现了真正的无修改深度外推。
实验
实验设计
- 在 ImageNet 256×256 上训练 LiFT-L/2,以 DiT-XL/2 为基线。
- 核心手段:共享 DiT 核心循环应用,训练时监督从初始估计到 flow-matching 目标的直线路径上的点,并用连续深度坐标索引目标。
- 围绕四个问题展开实验:深度外推能力、可比算力下的生成质量、计算在深度与时间上的分配、资源预算下的模型选择。
关键发现
- LiFT-L/2 在 FID 上比 DiT-XL/2 低 3.34,同时参数量减少约 60%,训练 FLOPs 减少 32%,推理 FLOPs 减少 52%。
- 训练后的模型可以循环超过训练深度,无需重训练或任何修改,而且更长的循环能进一步提升生成质量。
与基线对比解读
- 结果表明,循环深度扩展比单纯堆参数更高效:在更少参数和计算量下获得更好 FID,验证了计算深度作为扩展维度的潜力。
- 但 FID 改善幅度有限(3.34),且循环推理可能引入额外延迟;实际部署需要权衡循环步数与吞吐量。
- 该方法与 DiT 架构兼容,只需轻量修改,易于在现有流程中部署。
行业影响
落地场景
LiFT 的循环 DiT 核心适合图像 / 视频 / 3D 生成任务,尤其对高分辨率、低延迟敏感的在线产品。典型场景:
- 电商商品图生成:批量生成产品场景图,按需调整推理深度,在保证视觉质量下大幅降低每次生成成本。
- 内容平台视频生成:短视频或动态素材生成,利用循环深度作为计算预算旋钮,适配不同创作者套餐或设备算力。
- 设计工具与游戏资产生成:本地或边缘部署,减少参数后可在消费级 GPU 甚至移动端运行。
商业价值
论文显示 LiFT-L/2 相比 DiT-XL/2 基线:FID 低 3.34,参数少约 60%,训练 FLOPs 少 32%,推理 FLOPs 少 52%。这直接映射为:
- 降本:训练和推理算力需求近乎减半,生成服务单位成本显著下降。
- 体验提升:推理时增加循环深度可进一步提升生成质量,无需重新训练,允许针对高价值客户提供“高质量模式”增值。
- 灵活定价:按计算深度分层服务,实现差异化产品。
与现有产品 / 工作流接口
LiFT 只对标准 DiT 架构做轻量改动,可无缝替换现有 Flow Matching / 扩散模型 骨干。集成要点:
- 保留原有 U-Net 或 DiT 的 VAE 编解码与文本编码器,仅替换去噪骨干。
- 训练阶段增加 prelude loss(辅助回归)与随机深度坐标采样,代码改动小。
- 推理阶段暴露
depth超参数,便于服务端根据负载动态调整,如低峰期用高深度、高峰期用低深度。
实际用例:电商平台使用 LiFT 替换商品图生成模型的骨干,在批量生成 10 万张图片时节省约一半推理成本,同时允许高价值商品使用更深循环获得更精细背景;内容平台短视频生成服务在 API 层提供 quality=draft|standard|premium 映射到不同循环深度,实现按需计费。
局限
- LiFT 通过回归到直线路径上的点来监督每个循环步骤,隐含假设最优传输路径为直线,但高维复杂数据分布的最优路径可能弯曲,此设计可能限制了理论最优性。论文未探索更灵活的路径(如曲线或学习路径),且训练中不同深度步骤回归到同一路径的不同点上,可能导致早期与后期步骤的优化相互干扰。虽然使用了 prelude loss 缓解 anchor drift,但并未完全解决该冲突。工程上,辅助损失权重需要额外调优,且直线假设可能不适用所有模态。
- 实验仅在 ImageNet 256×256 类别条件生成上验证,未涉及更高分辨率(如 512×512、1024×1024)或文本到图像等更复杂任务。LiFT 的深度泛化能力在更大规模数据、更长序列或需要强文本对齐的任务中是否仍成立尚未得到验证。此外,FID 对比仅基于 dense DiT-XL/2 基线,未与 U-ViT、MDT、蒸馏方法等高效生成模型直接比较,无法全面评估相对优势。循环推理虽然节省参数,但多次前向可能增加推理延迟,对实时应用是潜在弱点。
- 论文提供了条件回归和梯度流分析,但未证明循环深度增加时模型会收敛到某个固定点或稳定分布,也未给出深度泛化的理论保证。实验观察到 FID 改善随深度增加出现 diminishing returns,表明无限循环并非总能持续获益。与已有 looped transformers 相比,LiFT 的深度坐标机制增加了实现复杂度:训练需随机采样深度坐标,推理需手动选择深度预算,加重超参数调优负担。缺乏自适应深度机制,用户可能需要针对不同数据集或任务手动调整推理深度,限制了易用性。