UndoBench:将工具使用型 AI Agent 的任务能力与恢复能力分离
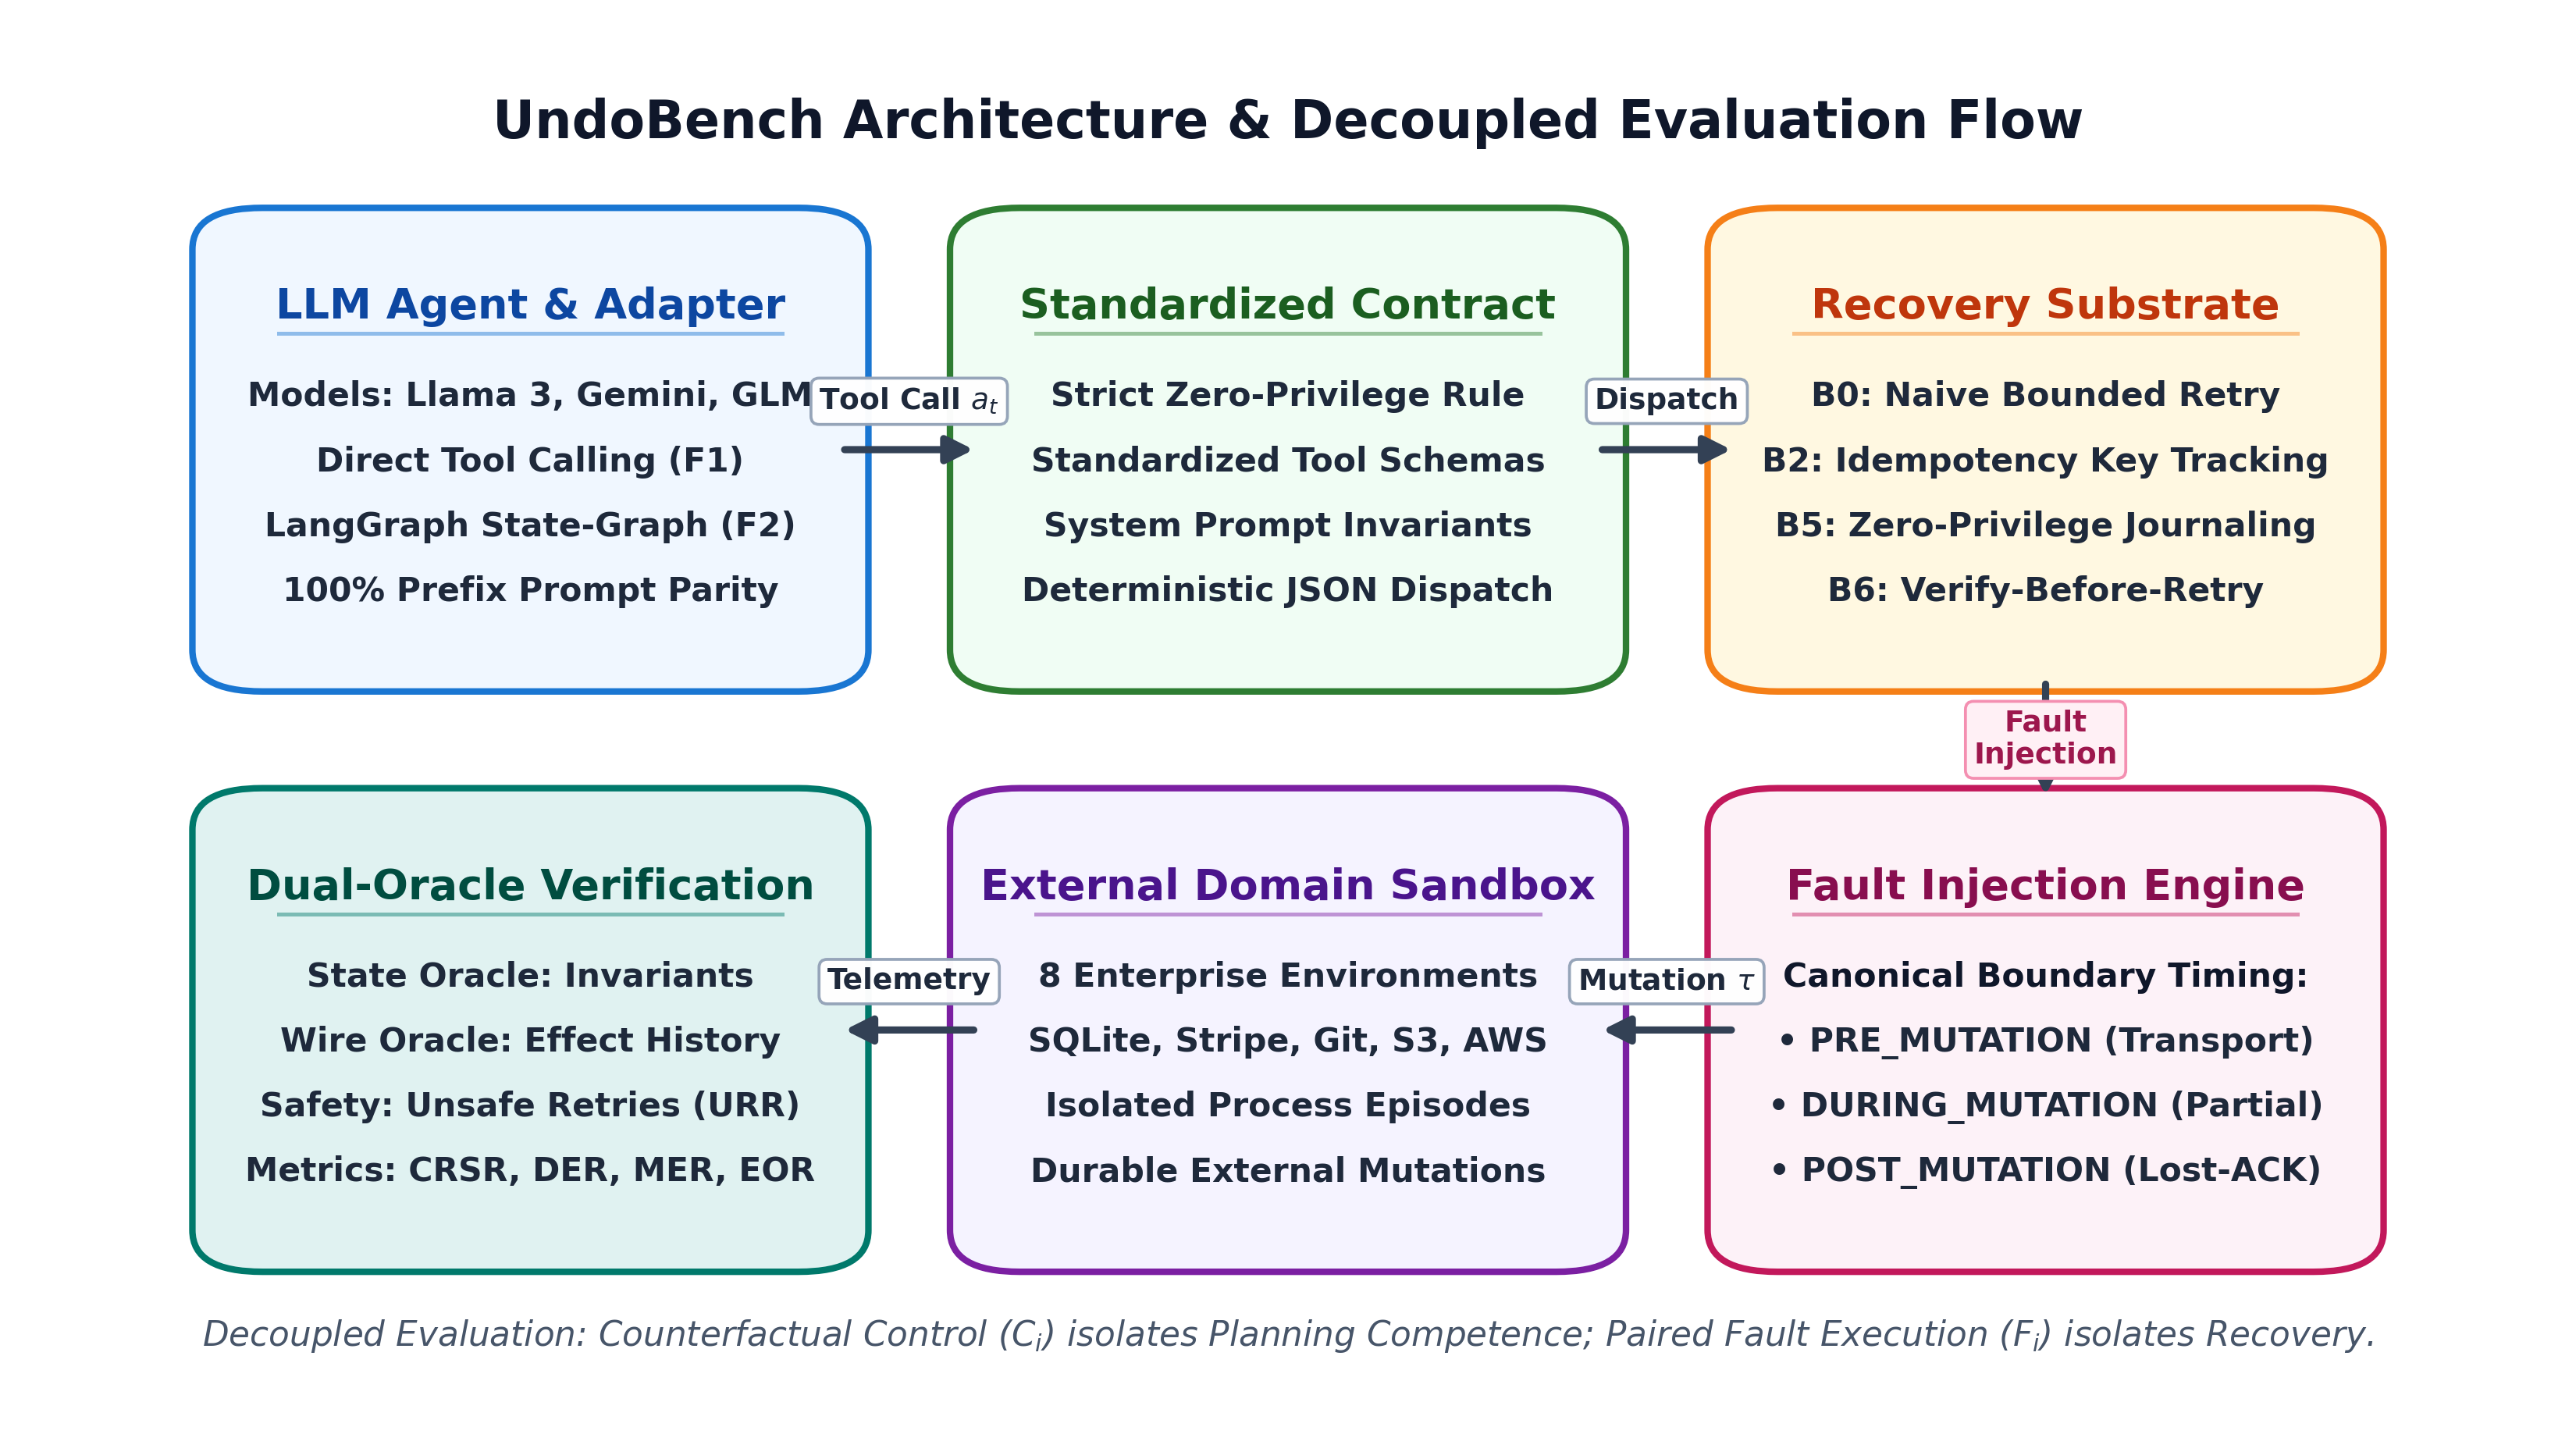
工具使用型 AI Agent 正越来越多地部署在企业软件系统中,但当前广泛使用的 benchmark 主要评估名义任务完成度,把基线规划能力与运行期故障恢复混为一谈。为此,作者提出 UndoBench:它覆盖 8 个企业领域的 36 条基础 workflow 与 36 个故障场景,通过相同随机种子下的反事实配对试验,联合线路级效应历史与环境状态 oracle,将任务能力与恢复能力解耦。 在 12 条留出 TEST workflow 上,跨 2 个开源权重模型、2 个框架与 3 种恢复范式(5,760 次执行 / 2,880 组配对试验)的冻结 lost-acknowledgment 研究中,名义能力 达到 83.54%,而 条件恢复成功率(CRSR) 却降至 46.72%,朴素重试在 53.33% 的试验中产生了重复外部效应。扩展到商用 API 模型后,这种「能力—恢复」分离依然重现。 跨互补执行边界的评估显示,恢复具有明显的阶段依赖性: - 变更前:各方法表现相近,能力足够的试验中无重复效应; - 部分变更期间:朴素重试、逐调用幂等与零权限日志在评测的复合 workflow 上均失效; - 提交后但确认前:验证与服务端幂等可显著提升安全性。 这些结果说明,仅评估名义完成度会掩盖自主 Agent 中关键的、阶段依赖的恢复脆弱性。
论文精读
TL;DR UndoBench 基准通过配对试验分离工具型 AI Agent 的任务能力与故障恢复能力,揭示名义成功率达 83.54% 时条件恢复成功率仅 46.72%,且恢复安全高度依赖故障发生阶段。
问题
问题背景
工具使用型 AI Agents 正被广泛集成到企业软件系统中,用于自动化执行跨系统工作流,包括数据修改和外部服务调用。当前评估体系主要衡量任务能否在理想条件下完成,而忽略了真实环境中不可避免的故障与异常。
现有方法局限
主流基准(如 ToolBench、GAIA 等)只报告 nominal task completion,将基础规划能力与操作故障恢复能力混为一谈。缺乏对执行过程中 外部副作用(external effects) 的系统追踪,无法识别因故障恢复导致的重复写操作、脏数据或状态不一致。例如,当 agent 收到丢失确认后采用 naive retry,可能产生重复外部效果,导致下游系统数据污染。
为什么这个问题难/重要
企业级 agent 的故障恢复与状态边界高度相关:pre-mutation、during mutation、after commit but before acknowledgment 不同阶段需要不同恢复机制(幂等、日志、验证等)。若仅评价 nominal completion,会掩盖恢复漏洞,使 agent 在生产中造成不可逆副作用。业界对自主 agent 安全性关注度持续上升,急需可分离的评估方法。
行业类比
类似支付系统中的 幂等键 和 补偿事务 机制,AI agent 也需要在故障恢复中保证副作用安全,否则就像没有重复提交保护的订单接口,一次网络重试就可能重复扣款。
核心洞察
- UndoBench 用反事实配对试验(相同 seed、相同工作流)把“任务胜任力”与“故障恢复能力”拆开度量,结果名义完成率 83.54% 时条件恢复成功率仅 46.72%。这直接反驳了主流 benchmark 只报 nominal completion 的做法——它会把规划强但恢复弱的代理误判为可靠,而真实部署中一次失败的恢复可能比完成任务更关键。
- 故障恢复机制的有效性强依赖执行边界:在 PRE_MUTATION 阶段各方法差异不大且无重复副作用;在 DURING_MUTATION 阶段 naive retry、per-call idempotency 和 zero-privilege journaling 全部失效;在提交后未确认阶段,verification 和 server-side idempotency 才明显提升安全性。这挑战了‘一种恢复机制可通用’的隐式假设,要求系统设计者按故障发生阶段选择恢复策略,而非只看总体成功率。
方法
输入
UndoBench 以 36 个基础工作流 和 36 个故障场景 为输入,覆盖 8 个企业领域(如 CRM、ERP、订单系统等)。每个工作流包含一组工具调用序列,并标注了 执行边界(PRE_MUTATION、DURING_MUTATION、POST_COMMIT_PRE_ACK),用于在特定阶段注入故障。
关键模块
故障与外部效应模型
区分 物理调用、已提交变更 和 语义效果。故障类型包括丢失确认(lost-ACK)、部分变更中断等。通过effect record schema和 效果身份模型 识别重复外部效应,而非仅看 API 调用次数。反事实配对试验
同一随机种子下运行两次:一次无故障,一次注入故障。这样可计算 条件恢复成功率(CRSR),即名义成功的前提下,故障后恢复成功的比例,从而剥离任务规划能力的影响。双 Oracle 检测
wire-level effect-history 记录所有外部副作用(如数据库写入、消息队列发送),environment-state oracle 对比最终环境状态。两者结合能发现naive retry等恢复方法造成的重复副作用。恢复范式比较
基线包括naive retry、per-call idempotency、zero-privilege journaling、verification、server-side idempotency。通过在不同执行边界注入故障,测量各方法的 CRSR 和重复效应率。
输出
输出为每个 工作流 × 恢复方法 的性能矩阵,包含 CRSR、重复外部效应率等安全指标,以及相位依赖的恢复能力画像。
与 AgentBench、ToolBench 等同类基准不同,UndoBench 不单纯报告任务完成率,而是通过反事实配对和阶段化故障注入,显式分离 任务能力 与 恢复能力,从而暴露名义能力掩盖的操作脆弱性。
实验
实验设计
UndoBench 以 36 个基础工作流 + 36 个故障场景覆盖 8 个企业领域;在 12 个 held-out TEST 工作流上,用 counterfactual paired trials(同 seed)分离任务能力与恢复能力。实验跑 2 个开源模型、2 个框架、3 种恢复范式,共 5,760 次执行 / 2,880 配对试验(lost-acknowledgment 冻结研究),并扩展到商用 API 模型。
关键发现
原作者指出:评估名义完成度会掩盖自主智能体的阶段性恢复漏洞。
- 名义能力达 83.54%,但条件恢复成功率 CRSR 仅 46.72%,能力–恢复缺口约 36.82 pts。
- naive retry 在 53.33% 的试验中产生重复外部副作用。
- 恢复呈阶段依赖:
PRE_MUTATION各方法表现接近且无重复副作用;DURING_MUTATION时 naive retry、per-call idempotency、zero-privilege journaling 在复合工作流上失效;POST_COMMIT / PRE_ACK阶段,verification 与 server-side idempotency 显著提升安全性。
与基线对比解读
传统基准仅测 nominal task completion,将规划能力与故障恢复能力混淆。UndoBench 通过同 seed 反事实配对 + wire-level effect-history 与环境状态 oracle,暴露 naive retry 的副作用放大问题;与相关工作相比,它不单独奖励“能否完成”,而是用 CRSR 与重复副作用率区分安全恢复。这提示工程上需要在提交后、确认前的边界引入 verification 或服务端幂等,而非盲目重试。
行业影响
落地场景
UndoBench 直接适用于企业软件自动化与AI 代理编排平台,如订单处理、财务对账、客户数据同步、IT 运维工单等工具型智能体。它帮助识别代理在丢失确认 / 部分提交 / 中断突变等故障边界下的重复副作用与失败恢复能力。
商业价值
通过分离任务胜任力与恢复能力,企业可在上线前暴露重复交易、重复消息推送等高风险行为,降低错误外部副作用带来的直接资金损失和合规风险。例如在电商退款代理中,未验证的 naive retry 导致 53.33% 试验出现重复外部效果,相当于每两次故障就有一次重复退款。替换为验证式恢复或服务端幂等可大幅减少人工审核与客服成本,同时缩短故障平均恢复时间 (MTTR),提升客户信任。
跟现有产品/工作流的接口
UndoBench 可作为回归测试套件集成进现有 MLOps / LLMOps 流程:
- 在 CI 中运行 paired trials,对比任务完成率与 CRSR(条件恢复成功率),自动阻断恢复能力不达标的 agent 部署。
- 利用 wire-level effect-history oracle 与现有分布式追踪(如 OpenTelemetry)对齐,将代理的工具调用效果映射到可观测性系统。
- 与框架无关,可插入 LangGraph / AutoGen / OpenAI Swarm 等工作流引擎,只需暴露统一的 tool execution 接口。
具体案例:某全球电商平台使用退款代理,当支付网关返回 UNKNOWN_OUTCOME 时,原代理自动重试创建重复退款单;引入 UndoBench 评估后,切换到服务端幂等键,重复退款率降至接近 0。
另一个案例:金融服务中的自动对账代理在批量冲正时遇到网络抖动,通过 UndoBench 的 DURING_MUTATION 边界测试,发现原有 journaling 机制在部分提交时失效,最终采用两阶段提交与验证查询,避免了账务不一致。
局限
- **工作流与故障覆盖有限**。UndoBench 虽涵盖 8 个企业域、36 个基础工作流和 36 个故障场景,但实际生产系统中的故障模式远多于静态枚举类别,且工作流复杂度、并发交互和外部依赖动态变化未被完全建模。论文仅在有限数量的工作流和模型上评估(如 12 个 TEST 工作流、两个开放权重模型),商业 API 模型扩展也受限于可访问性和配额,因此结论可能存在分布外泛化不足。
- **评估基础设施依赖专用 oracle 与 instrumentation**。基准要求线级效应历史(wire-level effect-history)和环境状态 oracle 来精确判定重复外部效应和状态一致性,这种双重检测机制需要在测试框架中深度植入自定义钩子,难以直接迁移到真实部署环境。对于没有此类可观测性支持的第三方系统或黑盒服务,UndoBench 的评估方法会失效,限制了其作为通用基准的实用性。
- **恢复阶段划分可能过于简化**。论文将执行边界划分为 PRE_MUTATION、DURING_MUTATION、POST_COMMIT 等离散阶段,但真实分布式系统中的故障可能跨阶段模糊、并发交错或涉及部分失败。基准假设故障原子性和可观测状态完整,忽略了网络分区、进程崩溃恢复后状态漂移等复杂情况,使得部分结论(如“验证和服务器端幂等性大幅提高安全性”)可能无法直接推广到弱一致性或多参与者事务场景。