CurveCodec 2: 骨架无关的动画压缩与学习式熵模型
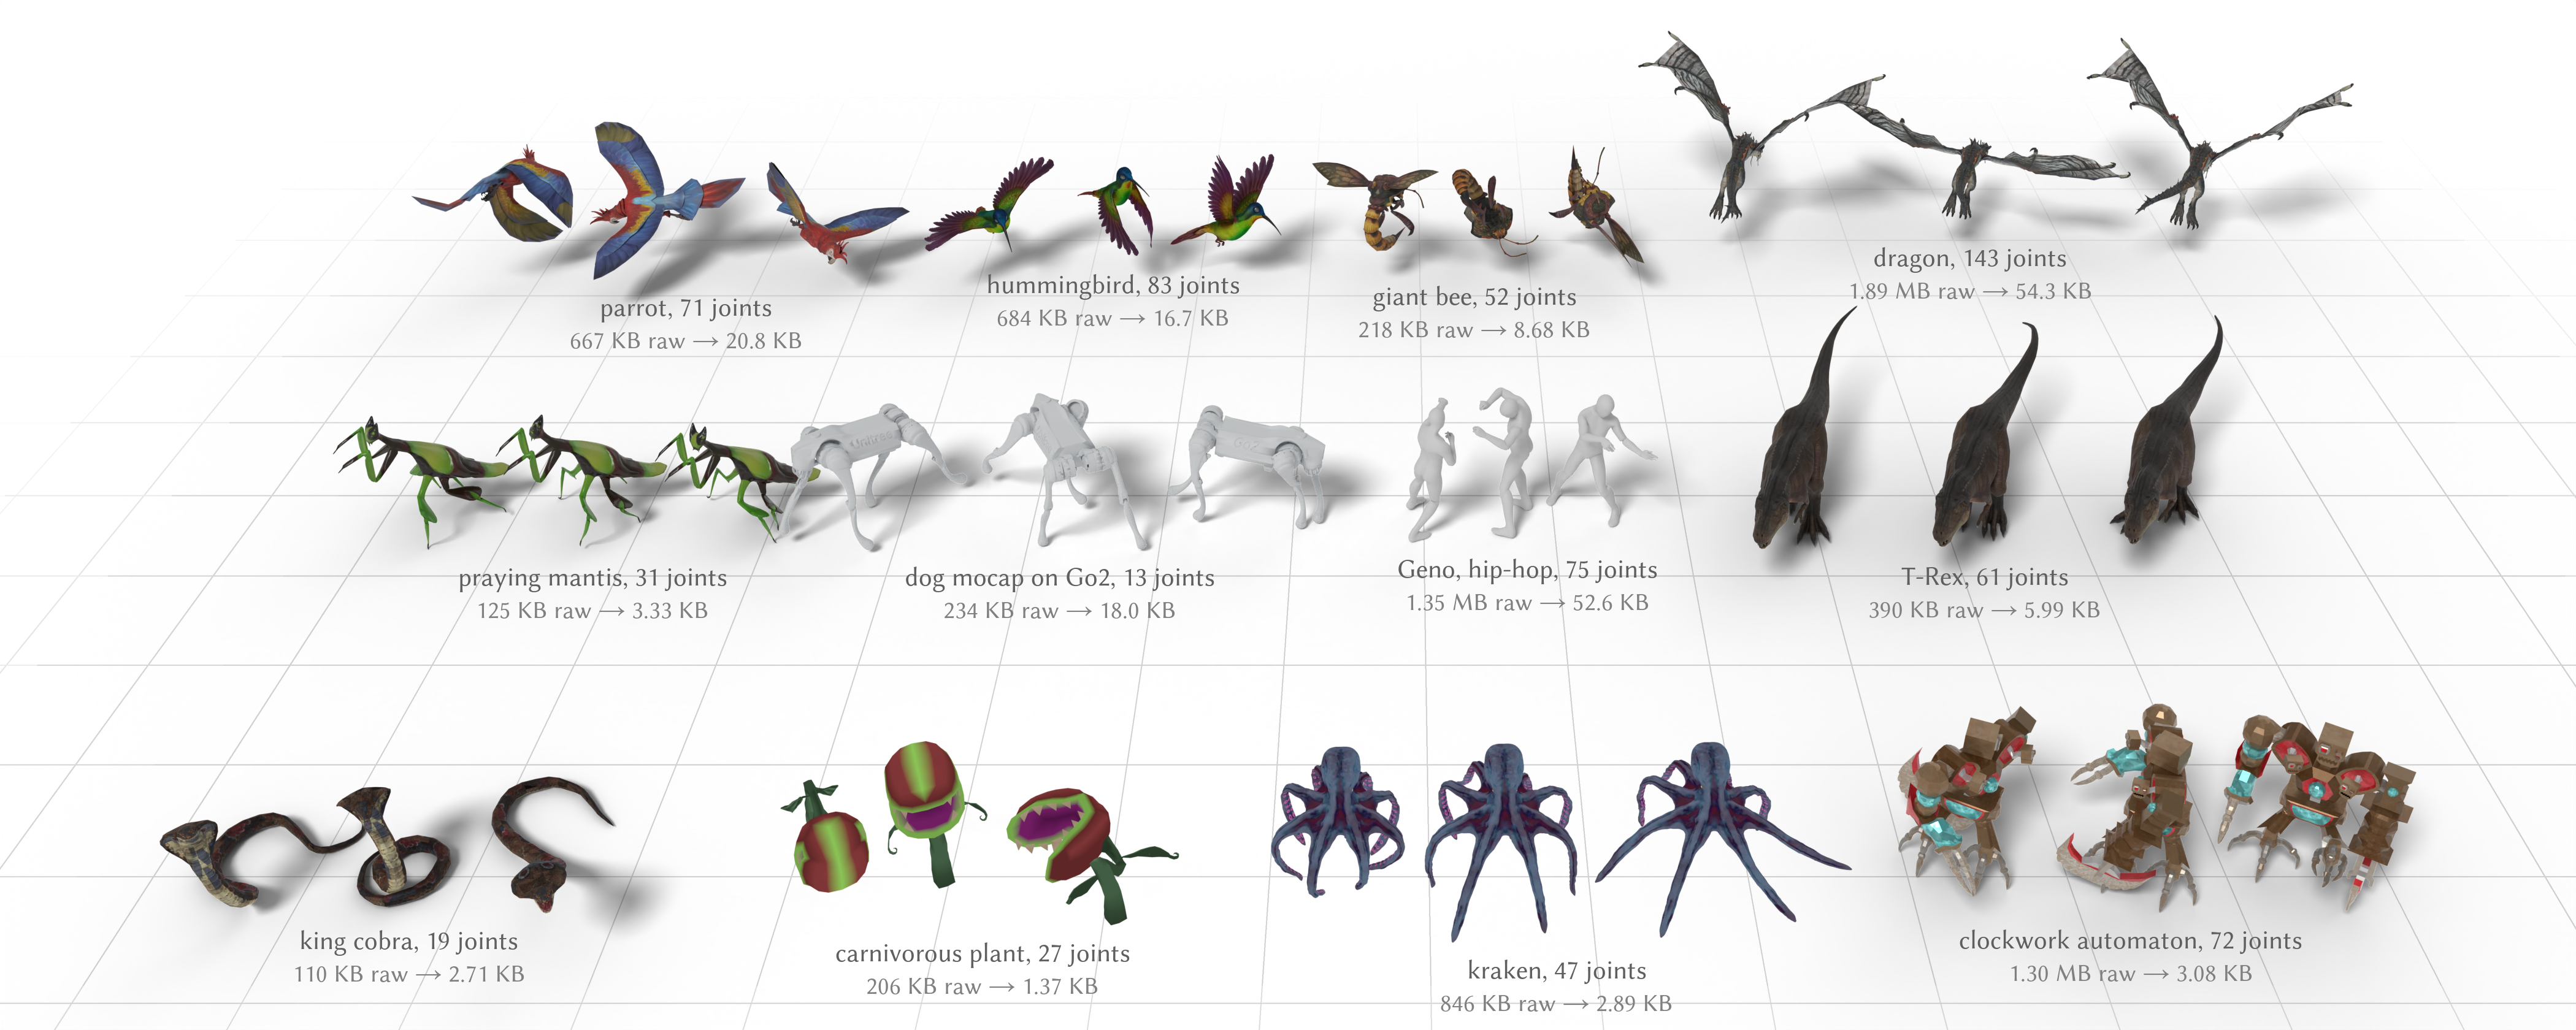
骨骼运动以每帧每个关节的变换形式存储,但其中大部分信息由身体结构本身隐含,而非运动所要表达的内容。压缩正是用来追问:当身体已知时,一段运动还必须说出什么?一个生产级 codec 必须对任意骨架、在给定误差界限下回答这个问题。 作者先测量冗余究竟在哪里。在生产精度下,最大的节省 来自用每条量化曲线的自身历史预测它,其次是逐关节、通过层级闭环地决定哪些采样不必编码。在编码器留下的空隙上,对数百万训练样本的最近邻 oracle 也不优于线性插值,试过的学习式补间器都无法回本。网络真正学到的是 codec 需要发送的残差分布。 CurveCodec 2 将每条 sub-track 编码为 log map 中的曲线,闭环量化并稀疏化为率失真筛选出的 key,残差在小型学习模型下熵编码,其整数推理在不同平台间 bit-exact。每个解码片段须满足两份契约之一:在给定容差内达到 ACL 自身的逐关节最坏情况误差,或达到 ACL 的逐片段平均误差。 在来自 33 个数据集、4,472 个片段的 held-out 测试集上: - 最坏情况契约 下,在 ACL 默认精度 0.01 cm 时只需 ACL 字节数的 0.37x - 平均误差契约 下,在 0.1 cm 时只需 0.22x - 单 CPU 核即可解码,且无需重训练即可迁移到训练中未出现的物种
论文精读
TL;DR CurveCodec 2 针对骨骼动画压缩,用学习熵模型对量化残差做位精确编码,在 ACL 最坏误差合约下仅需 0.37 倍字节数,且零样本跨物种泛化。
问题
问题背景
骨骼动画以逐帧逐关节变换存储,数据冗余极高,生产级压缩需在任意骨架上满足严格误差约束。
现有方法局限
- ACL 是当前工业标准,但基于手工规则独立量化每条子轨道,未充分挖掘关节层级与时间冗余,压缩率受限。
- 早期学习型方法如 CurveCodec 采用神经网络先验选择稀疏锚点,但仅匹配 ACL 平均误差,未能达到其最坏情况误差界,且将有效载荷按浮点数而非实际比特数计量,导致压缩率评估失真。
- 这些方法未从率失真角度闭环优化关键帧选择,也未对残差进行熵编码,忽略了学习模型在概率建模上的优势。
为什么难/重要
- 技术挑战:骨骼运动冗余高度结构化,父关节变换隐含子关节信息,时间序列自相关性。生产级编解码器需支持任意骨架、严格误差合约(最坏情况或平均误差)、跨平台位精确解码,这要求学习模型既能捕获残差分布,又能在整数推理下保持确定性。
- 业界关注:游戏引擎、虚拟制作、元宇宙场景中动画数据量巨大,压缩直接降低存储与传输成本。当前尚无学习型方法能在满足最坏情况误差的同时显著超越 ACL,因此该问题兼具学术与工程价值。
行业类比
类似于神经视频编码中用学习模型替代传统熵编码和运动补偿,但动画压缩要求更严苛的误差合约与骨架无关性,可类比为将 H.266 的混合架构引入游戏资产管线。
核心洞察
- 冗余的量化分析是设计学习组件的先决条件,而非直接端到端学习。本文通过大规模测量发现,在生产精度下压缩收益主要来自自回归预测与每关节稀疏化,而学习插值在编码器留下的间隙上不比线性插值更好,因此将学习模型仅用于残差分布建模,避免了对运动重建的过度参数化。
- 学习熵模型与闭环量化解耦,实现跨平台位精确解码。不同于多数学习编解码器依赖浮点推理导致位流不可复现,CurveCodec 2 在对数映射中进行闭环量化与率失真选键,残差由小型学习模型提供概率分布,使学习部分仅影响熵编码概率,解码器可执行整数推理,保证不同平台输出一致,同时压缩率显著优于 ACL。
方法
输入:任意骨骼动画片段,包含每关节的平移、旋转、缩放轨道。
核心模块:
- 表示折叠 (Representation Folding):将旋转从四元数/矩阵映射到对数空间(log map),使旋转变为可线性操作的向量,利于后续量化与预测。
- 闭环量化 (Closed-Loop Quantization):量化时前向传播误差,确保解码后的关节变换在给定的误差壳(error shell)内,满足最坏情况或平均误差合同。
- 率失真关键帧 (Rate–Distortion Keys):对每个子轨道,通过率失真优化选择关键帧集合,非关键帧由预测/插值重建,平衡比特率与失真。
- 预测与学习熵编码:利用每个曲线自身的历史预测当前帧残差,一个小型神经网络(仅整数运算,保证跨平台位精确)建模残差的概率分布,用算术编码压缩残差。
输出:紧凑比特流。解码时重建动画,并验证满足 ACL 的最坏情况每关节误差或剪辑平均误差合同。
与同类方法差异:CurveCodec 2 将学习模型聚焦于熵编码(残差分布),而非直接学习重建或插值,因此在低比特率下仍能保持可验证的误差界限,且单一模型可跨任意骨架与物种泛化,无需重训练。
实验
实验设计
在 held-out 测试集上评估,包含 33 个数据集、4,472 条动画片段,基线为 ACL。采用两种误差合同:最坏情况每关节误差(ACL 默认精度 0.01 cm)和平均误差(0.1 cm),验证解码比特流正确性与压缩率。
关键发现
冗余分析表明:生产精度下最大节省来自时序自预测,其次是通过骨骼层级闭环选择忽略哪些样本;在编码器留下的间隙上,基于百万样本的最近邻检索不比线性插值更好,且任何学习的插值器都无法回本。网络实际学到的是残差分布,用于熵编码。
最终 CurveCodec 2 在 ACL 默认精度下仅需 0.37x 字节即可满足最坏情况合同;在平均误差合同下仅需 0.22x。解码在单 CPU 核上运行,且无需重新训练即可泛化到训练中未见过的物种。
对比解读
相对 ACL,CurveCodec 2 在相同误差合同下大幅降低存储需求,同时保持了 ACL 的最坏情况保证或平均误差水平。核心差异:
- 以对数映射中的曲线编码子轨道,闭环量化
- 率失真选择的键
- 学习熵模型对残差进行比特精确的整数推理
相比前作 CurveCodec 1,它从浮点载荷计数转为真实比特流,并提升了最坏情况表现。
行业影响
落地场景
CurveCodec 2 可作为游戏引擎、动画工具链和实时虚拟人系统的骨骼动画压缩层,适用于大规模角色动画存储与流式传输。
- 游戏开发:在任意骨架结构下直接替换 ACL 压缩,减少包体与运行时内存。
- 虚拟人 / 数字内容平台:为社交媒体、直播、虚拟试穿等提供低带宽动画流。
- 动画生产管线:对捕捉的动画数据做有保证误差的压缩归档。
商业价值
主要收益在降本与体验提升:
- 存储与带宽成本:
0.37xACL 字节率可显著降低游戏安装包、云端动画库和 CDN 流量成本。 - 运行效率:单 CPU 核解码,适配移动端与低功耗设备,延长设备续航或降低服务器算力需求。
- 资产可扩展性:骨架无关且无需重训,支持大量异构角色,减少工程维护成本。
与现有产品 / 工作流接口
以 C++ 库形式嵌入引擎动画管道:在导入资源时生成 CurveCodec 2 码流,运行时加载解码。可配置误差合同(ACL 最坏情况或均值)确保质量达标。
具体落地用例:
- 电商虚拟试穿:客户端实时解码不同体型骨骼动画,减少 App 体积和内购加载时间。
- UGC 内容平台:允许用户上传自定义骨骼动画并以压缩格式分发,降低审核与存储成本。
整体而言,CurveCodec 2 提供了一种可验证误差、骨架无关、端侧友好的动画压缩方案,适合需要大规模角色动画交付的场景。
局限
- **无随机访问能力**:论文明确表示不支持随机帧解码。由于熵编码依赖顺序上下文预测,解码必须从头开始,这与 ACL 等传统方法支持的分段随机访问形成对比。在游戏引擎中,动画片段常需按需跳转或流式加载,因此 CurveCodec 2 在交互式回放或实时流场景下需要额外机制(如切分独立码流),增加了工程复杂度。
- **验证范围相对单一**:实验主要与 ACL 对比,虽然 ACL 是生产标准且性能已被超越,但缺少与其他学习型动画压缩方法(例如基于神经场或 VQ 的方法)的系统比较。不同应用场景可能有更合适的基线,因此难以判断该方法在所有条件下的相对优势;同时,33 个数据集的泛化测试虽广,但对极端少见骨架结构或特殊运动类型的覆盖仍可能不足。
- **未验证压缩流作为任务表示**:作者承认尚未探索压缩后的码流能否直接用于下游任务(如动作分类、运动生成等)。若下游任务仍需解压还原原始骨骼动画,则解压的计算开销和延迟可能抵消一部分压缩收益;此外,码流中的概率模型残差分布是否蕴含可迁移的运动语义也未经验证,这限制了该方法在端到端学习管线中的直接应用潜力。