学习潜在蛋白质语言用于自回归生成
自回归 transformer 在蛋白质序列与结构生成上仍相对较弱。本文研究目标表示的作用:氨基酸 token 仅编码残基身份、缺乏显式上下文语义,而 backbone 坐标在框架中需要离散表示。 为此引入两种学习到的潜在蛋白质语言。Protein Latent Language (PLL) 基于冻结的 ESM-2 encoder,将序列映射为 4,096 状态的上下文词表,每个残基对应一个 token;Structure Latent Language (SLL) 在保留解码到 backbone 坐标的同时,借助辅助序列与置信度监督适配 GCP-VQVAE Lite。随后分别用 next-token prediction 在 PLL 与 SLL token 上预训练自回归 transformer,得到 PLLM 与 SLLM。 在匹配的下游序列训练下,PLLM 的拟合 compute-scaling 指数为 0.038,而氨基酸自回归模型为 0.020。无条件生成中,PLLM 将低于启发式 1.5-bit 残基组成熵阈值的样本比例相对氨基酸模型降低 54%。序列到结构预测中,用 SLL 替换原 GCP-VQVAE Lite tokenizer 使最佳验证 perplexity 在匹配训练下降低 34%;对长蛋白,latent-token 采样比基于 MSA 的 AlphaFold2 快约 1,000 倍。backbone 生成中,SLLM 在多样性与新颖性上与其他生成模型相比具优势。 此外还观察到早期迹象:利用 SLLM 的内部 token 置信度进行推理时采样,可在单个解码样本之外提升序列到结构预测质量。这些结果将学习到的潜在蛋白质语言定位为自回归 transformer 扩展与推理时采样的有前景基础。
论文精读
TL;DR 提出 PLL 与 SLL 两种学习到的蛋白质潜在语言,将序列/结构映射为上下文 token 后用自回归 Transformer 建模,在生成质量、结构预测与采样速度上显著优于氨基酸级模型。
问题
问题背景
蛋白质生成是 AI for Science 的关键方向,自回归 Transformer 在语言、图像等离散 token 模态上已展现强 scaling 能力,但在蛋白质序列与结构生成上仍相对薄弱。
现有方法局限
- 基于氨基酸 token 的序列生成模型仅编码残基身份,缺乏上下文语义,导致模型难以捕获残基间的结构约束与功能相关性。
- 结构生成需要离散化骨干坐标,现有 VQ-VAE 类方法(如 GCP-VQVAE Lite)在压缩与重建质量之间存在瓶颈,且 tokenizer 训练缺乏序列与置信度监督,限制了后续自回归模型的上限。
- 自回归模型在蛋白质上的计算扩展效率低:氨基酸模型的 fitted scaling exponent 仅 0.020,远低于同规模语言模型的预期,意味着增加算力难以带来生成质量显著提升。
- 序列到结构预测常依赖 MSA 搜索(如 AlphaFold2),对长蛋白速度慢,且单次解码样本缺乏不确定性估计。
为什么这个问题难/重要
技术挑战在于:蛋白质序列空间庞大且结构-序列关系高度非线性,长程依赖突出;离散 latent 表示需要在信息保留与可生成性之间精确平衡。业界关注药物设计、酶工程等场景,需要快速、多样且高质量的候选蛋白,但现有方法要么速度太慢,要么生成多样性不足或质量不稳定,阻碍了生成模型的实际落地。
行业类比
类似 NLP 中从 word-level tokenization 演进到 subword/contextual tokenization 显著提升语言模型的 scaling 效率与生成质量,蛋白质生成也需要更富语义的 token 表示来释放自回归 Transformer 的潜力。
核心洞察
- **目标表征是自回归蛋白生成的核心瓶颈,学习到的潜在语言能显著提升 scaling 效率。** 相比于传统氨基酸残基 token(缺乏上下文语义)或直接离散化连续坐标,PLL 利用 ESM-2 嵌入聚类得到 4,096 状态上下文 token,每残基一 token,使自回归模型在相同数据与参数规模下 compute-scaling exponent 从 0.020 提升至 0.038,且无条件生成低熵样本比例降低 54%。这表明离散潜在空间能更高效地编码蛋白质序列分布,为后续模型尺度扩展提供更陡峭的性能增益。
- **SLL 统一序列与结构表征,并利用 token 置信度支持 inference-time 采样,显著提升预测质量与速度。** 在 GCP-VQVAE Lite 基础上加入辅助序列监督和置信度监督,保留解码到 backbone 坐标的能力,使自回归生成与序列到结构预测共享同一潜在空间。在 matched training 下,SLL 将 sequence-to-structure 的 validation perplexity 降低 34%;对于长蛋白,latent token 采样比基于 MSA 的 AlphaFold2 快约 1000 倍。同时,SLLM 的内部 token 置信度可用于候选选择,比单次解码样本获得更好的结构预测质量,这种统一表征与置信度驱动机制在现有生成模型中较为稀缺。
方法
输入
- 序列输入:原始氨基酸序列。
- 结构输入:蛋白质骨干坐标(N、Cα、C、O 原子)。
关键模块
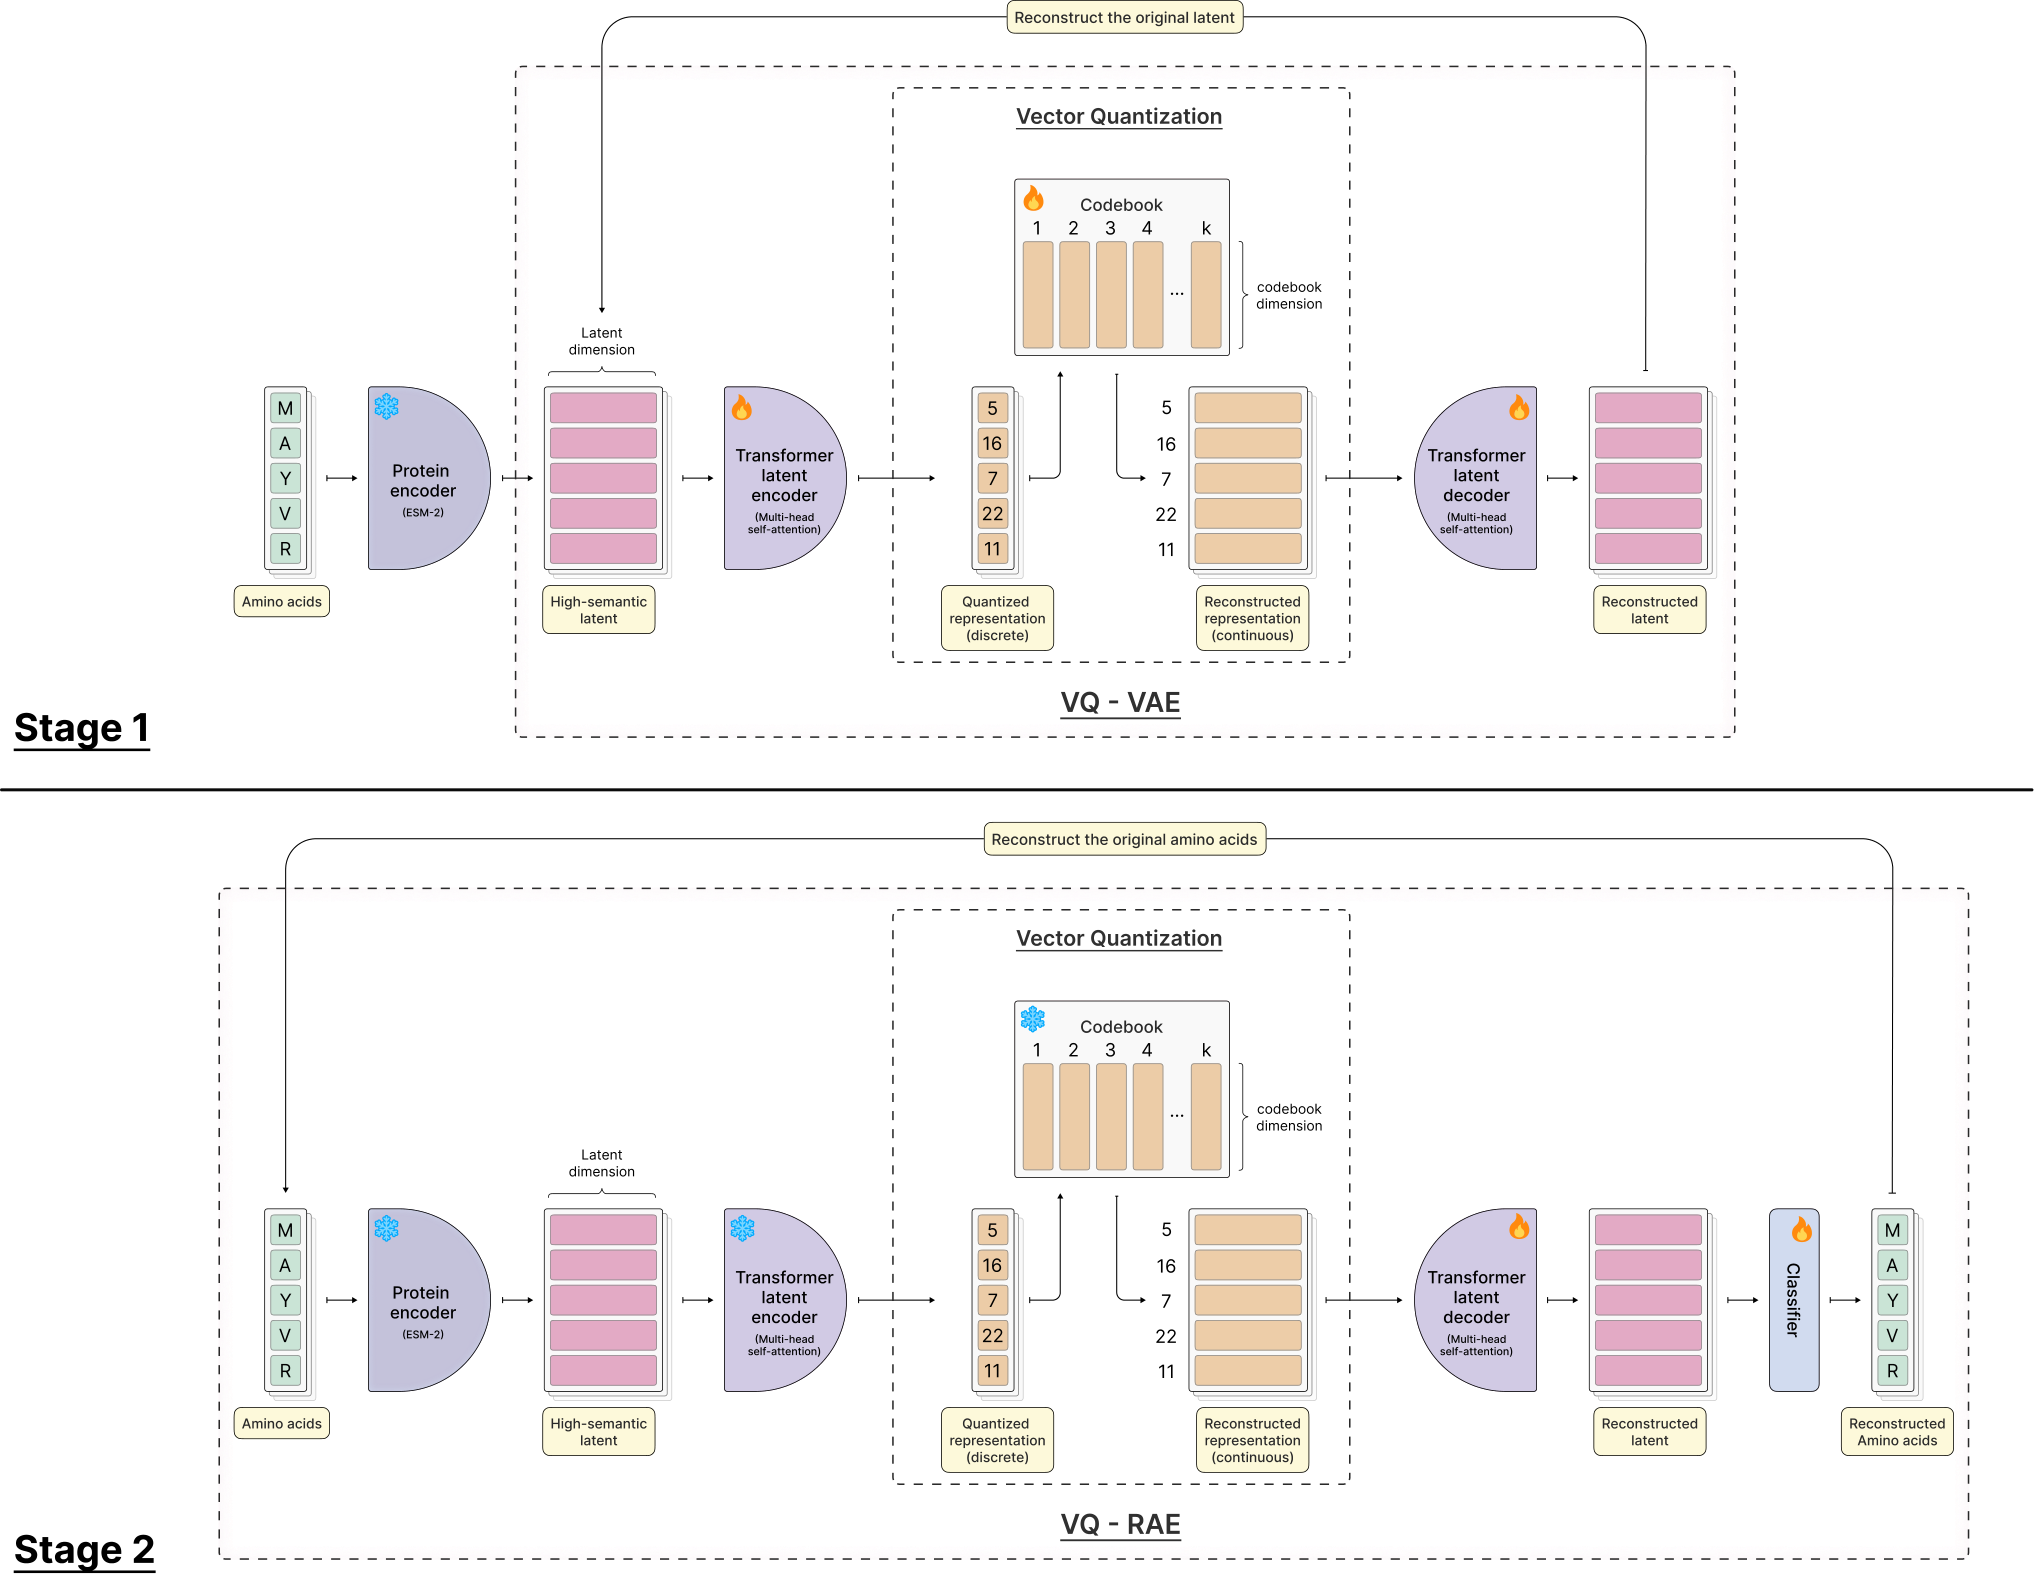
- Protein Latent Language (PLL):使用冻结的 ESM-2 编码器,对每个残基产生上下文表示;再经可训练的离散化头(向量量化),映射到大小为 4096 的码本,每个残基对应一个离散 token,序列长度不变。
- Structure Latent Language (SLL):基于 GCP-VQVAE Lite 的编码-量化-解码架构,将骨干坐标离散化为 token;额外添加序列预测头和置信度估计头,训练损失包含结构重构、序列分类与置信度校准。
- 自回归模型(PLLM / SLLM):采用标准 Transformer decoder-only 架构,分别在 PLL 或 SLL token 序列上进行 next-token prediction,获得 PLLM 和 SLLM。
输出与推理
- PLLM 无条件生成 latent token 序列,通过 PLL 解码器还原为氨基酸序列。
- SLLM 生成结构 token 序列,通过 SLL 解码器还原为骨干坐标;序列到结构预测时,先用 SLL tokenizer 编码输入序列,再让 SLLM 续写结构 token。
- 推理阶段利用 token 置信度进行候选采样,提升结构预测质量。
与直接使用氨基酸 token 或连续结构坐标的方法不同,本工作通过显式学习的上下文 latent token 替代原始符号/坐标,使自回归 Transformer 的 next-token prediction 更聚焦于结构语义,从而显著改善 scaling 行为与生成多样性。
实验
实验设计
论文围绕潜在蛋白语言(PLL 与 SLL)展开,核心是探究目标表示对自回归 transformer 生成能力的影响。PLL 利用冻结的 ESM-2 编码器将蛋白质序列离散化为 4096 状态上下文 token,每一残基对应一个 token;SLL 则改编 GCP-VQVAE Lite,加入辅助序列与置信度监督,保留解码到骨架坐标的能力。两者分别预训练自回归模型 PLLM 与 SLLM,并在序列生成、序列到结构预测、骨架生成等任务上与基于氨基酸 token 的基线模型对比。
关键发现
- 缩放效率:在匹配下游序列训练下,PLLM 的拟合计算缩放指数为 0.038,显著高于氨基酸模型的 0.020,表明潜在语言能更高效地将算力转化为生成质量提升。
- 序列生成质量:无条件生成中,PLLM 将低于启发式 1.5-bit 残基组成熵阈值的样本比例降低了 54%,说明生成的序列具有更好的组成合理性。
- 结构 token 优势:用 SLL 替换原始 GCP-VQVAE Lite tokenizer 后,序列到结构预测的最佳验证困惑度降低 34%,证明引入序列与置信度监督能学习到更具信息量的结构离散表示。
- 推理速度:对于长蛋白,潜在 token 采样比基于 MSA 的 AlphaFold2 快约 1000 倍,且不牺牲多样性,为高通量结构生成提供了现实路径。
- 推理时置信度采样:利用 SLLM 内部 token 置信度进行候选选择,可进一步提升序列到结构预测质量,展示了潜在 token 附带的不确定性信息价值。
对比解读
相较于传统氨基酸 token,PLL 的每个 token 携带了来自 ESM-2 的上下文语义,从“字母”升级为“词”,因此自回归建模时信息密度更高,缩放曲线更陡。SLL 相比原始 VQ-VAE 仅依赖结构重构损失,通过显式加入序列一致性与置信度监督,缓解了离散瓶颈处的信息丢失,使 token 更有利于下游预测。速度优势来源于彻底绕开 MSA 搜索,直接对潜在序列自回归采样,这对需要快速探索蛋白空间的场景(如定向进化或 de novo 设计)具有工程价值。当前工作仍处于早期,但已清晰显示学习潜在蛋白语言是自回归 transformer 在蛋白质生成领域 scaling 的可行基座。
行业影响
落地场景
蛋白质序列生成 与 骨架结构生成 可直接用于药物发现、酶工程、合成生物学等场景。例如,生物技术公司可将 PLLM 嵌入蛋白设计平台,快速生成多样且具有合理理化性质的候选序列;SLLM 可生成新型折叠骨架,辅助基于结构的抗体或酶设计。
商业价值
- 降本:采样速度比 MSA-based AlphaFold2 快约 1000 倍,大幅降低大规模生成的算力成本;无需多序列比对即可进行结构预测,缩短迭代周期。
- 增效:更好的 scaling 行为(PLLM 指数 0.038 vs 0.020)意味着随算力投入性能提升更显著,适合长期资源规划。
- 体验提升:可学习的离散 latent space 支持条件生成与置信度筛选,减少无效候选。
与现有工作流集成
- Tokenizer 层替换:SLL 可作为现有 protein structure tokenizer 的替代,接入自回归框架,降低 perplexity。
- 生成接口:PLLM/SLLM 可作为独立服务,通过 API 提供序列或结构生成,与 Rosetta、PyRosetta、OpenFold 等工具配合。
- 置信度采样:利用内部 token confidence 进行候选筛选,可作为后处理步骤接入实验设计管道。
具体 use case:某酶工程企业使用 PLLM 生成突变体库,通过 ESM-2 编码表征筛选,减少湿实验通量;某抗体设计平台使用 SLLM 生成 CDR 区域骨架,再用物理模拟软件优化,加速先导物发现。
局限
- 论文在 scaling law 实验中仅使用了相对较小的模型规模与有限计算预算,拟合的 compute-scaling exponent(PLLM 0.038 vs 氨基酸模型 0.020)可能无法可靠外推到更大参数和更多数据。作者也承认,当前 latent token 的离散化质量(尤其是 SLL 的 VQ-VAE 重建精度)会限制生成结构的分辨率与合理性,导致 backbone 生成在局部几何细节上仍落后于基于物理模拟或扩散模型的方法。
- PLL 建立在 frozen ESM-2 编码器之上,其 contextual 语义受限于 ESM-2 的预训练任务(掩码语言建模),缺乏对蛋白质折叠和功能的显式建模,因此序列生成中的长程结构约束可能表达不足。SLL 虽然加入了序列与置信度监督,但离散化过程中的信息瓶颈使结构 token 与真实 backbone 坐标之间存在不可忽略的重构误差,这会影响序列到结构预测的准确性和生成结构的可设计性。
- 与结构生成领域的 RFdiffusion、FrameFlow 等连续扩散模型相比,SLLM 在无条件 backbone 生成上虽然 diversity 和 novelty 指标占优,但在结构合理性指标(如设计成功率、pLDDT、scTM)上并未展示显著优势,且缺少对多链或复杂折叠类型的系统性评估。序列生成方面,与直接微调蛋白质语言模型(如 ProGen2)或条件生成模型相比,PLLM 的样本质量和可控性仍缺乏充分对比实验,尤其在功能特性和可表达性上验证不足。