LMBuild:评估 LLM Agents 生成可建造且功能性的结构
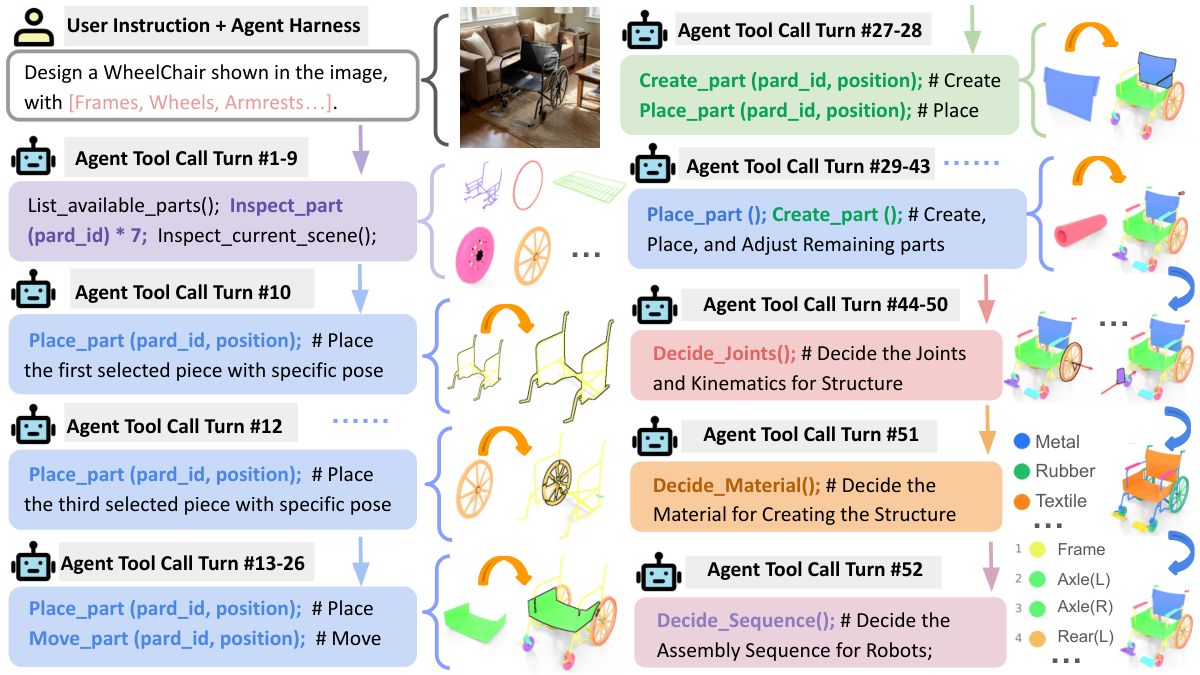
基于 LLM 的 agents 已能生成复杂 3D 结构,有望重塑物理世界中物体的设计与实现方式。然而,生成优雅的几何形状与生成可被建造、并能履行预期功能的物体有本质区别。现有评测大多关注几何质量,却忽视了物理可实现性。我们提出 LMBuild,一个用于评测 LLM agents 生成可建造且功能性结构的 benchmark。LMBuild 将生成物体表示为装配式结构,包含部件分解、连接方式、材料与装配序列。为支持可复现评测,我们提供统一框架,包括: 1. 一个交互式环境,agents 可用工具检索、创建并放置组件以构建物体; 2. 一个精选 benchmark,对既有 CAD 数据集进行改造,并用 Wikipedia 知识进行增强; 3. 一个评测框架,覆盖结构稳健性、功能可供性、设计质量与物理可实现性。 对 30 个系统的评测揭示了若干有趣发现:(a) 稳健性与对齐已不再是前沿闭源模型的主要瓶颈,而功能可供性与物理可操作性仍然困难得多;(b) 更强的模型能更有效地创建新组件,较弱的模型则倾向于依赖检索;(c) 提供功能规格可显著提升部件完整性、运动学表现与物理可操作性。这些结果表明,生成真实世界结构需要对功能可供性、力学机制以及新组件的设计与创造进行更深入的推理。我们期待 LMBuild 能为衡量进展、并推动面向可建造且功能性结构生成 agents 的研究提供基础。
论文精读
TL;DR **LMBuild** 是一个评估 LLM 智能体生成可建造、功能结构的基准,涵盖部件分解、关节与装配序列;实验发现前沿模型在结构合理性与视觉对齐上已非瓶颈,但 **功能可供性** 与 **物理可操作性** 仍存显著差距。
问题
问题背景:当前 LLM 智能体已能生成复杂 3D 结构,有望改变物理世界中对象的设计与实现方式,领域焦点逐渐从美观几何转向可构建性与功能性。
现有方法局限:主流评估基准(如 ShapeNet 上的生成指标)主要衡量几何质量,如 Chamfer Distance、FID 或视觉相似度,忽略物理可实现性:结构是否稳定、部件能否装配、关节能否运动、材料是否支撑载荷。生成结果通常是单一网格,缺少部件分解、连接件信息、装配序列和运动学约束。此外,现有工作没有提供交互式构建环境,无法评估智能体在检索、创建、放置部件以及多轮迭代修改中的实际能力。数据集仅提供几何模型,不含功能说明或物理知识,导致评估与真实制造脱节。
为什么这个问题难/重要:生成可构建且功能性的结构要求模型同时推理功能可供性(functional affordance)、力学稳定性、运动学可行性以及新颖部件设计。模型需要跟踪场景状态,理解部件间的空间与物理关系,并在工具交互中迭代改进。这对闭源前沿模型仍是显著挑战:论文实验表明,结构合理性和视觉对齐不再是瓶颈,但功能可供性和物理可操作性差距较大;强模型倾向创建新部件,弱模型则依赖检索。该方向与产品设计、机器人操作、数字制造等应用直接相关,业界需要能落地的生成结果,而非仅视觉相似。
行业类比:就像自动驾驶仿真需要车辆模型具备正确的碰撞体、运动学约束和可装配性才能用于功能验证,生成式 CAD 也必须从“看起来像”走向“装得上、动得了、用得了”。
核心洞察
- LMBuild 将 LLM agent 的 3D 生成评估从几何质量扩展到物理可建造性(part decomposition、joints、materials、装配序列),揭示前沿模型在结构健全和视觉对齐上已非瓶颈,但功能可负担性和物理可操作性差距依然巨大。与以往仅关注视觉相似度或网格质量的评测不同,该基准引入交互式环境与层次化指标,推动研究从“生成美观结构”转向“生成可建造、可使用的真实物体”,为工程落地提供更贴近实际的评测标尺。
- 实验发现强弱模型在零件获取策略上明显分化:强模型更偏好创建新组件,弱模型则依赖检索;且显式提供功能规格能显著改善 part completeness、运动学和物理可操作性。这一结果提示 agent 系统设计中,工具使用偏好与任务提示方式直接影响生成质量——对能力较弱模型,明确的功能描述比隐含目标更能约束其输出满足实际装配需求,也为后续提示工程和工具策略优化提供了实证依据。
方法
LMBuild 方法详解
输入:给定自然语言任务描述(如“设计一个可折叠的椅子”),可选包含细粒度功能规格(如关节运动范围、承重要求)。
关键模块:
交互式生成环境
- 代理通过工具执行部件检索(从预置库中查询标准件)或部件创建(调用 CAD 生成新几何体),再将部件装配为完整结构。
- 支持多轮迭代修訂:代理可检查当前装配状态并修改部件、关节或序列。
- 环境返回场景状态(部件位姿、连接关系等),用于闭环反馈。
基准数据构建
- 复用现有 CAD 数据集(如 PartNet、ShapeNet),结合 Wikipedia 知识补充功能描述与物理约束。
- 数据选择策略包括:源感知与多样性采样、语义概念接地与视觉验证、运动学覆盖与核心集构建,以及基于证据的声明提取与验证,确保任务真实、可验证。
分层评估框架
- 覆盖四个维度:结构健全性(插入可行性、中间支撑稳定性)、功能 affordance(能力规格、人体工学几何、动态运动可行性)、设计质量(感知/程序化分解质量、结构对齐)、物理实现(滚动能力等)。
- 每个维度下设置可自动计算或模型评测的指标,并校准聚合分数。
输出:代理生成的装配结构以及各维度的量化得分,用于横向比较不同 LLM/VLM 系统的能力。
与同类方法差异:LMBuild 首次将评估从“能否生成好看几何”拓展到“能否生成可建造、可运行的真实物件”,显式建模部件分解、关节、材料与装配序列,并强调物理可操作性而非仅外观相似度。
实验
实验设计
在 LMBuild 基准上评估 30 个系统,涵盖闭源 LLM(如 GPT-4、Claude 3)、开源 VLM/LLM 及领域特化生成系统。每个系统在交互式环境中通过多轮对话使用工具完成部件检索、创建与放置,最终生成可装配结构。评估采用层次化框架,测量 结构合理性、视觉对齐、功能可供性、物理可实现性 等维度。
关键发现
- 前沿闭源模型在结构合理性与视觉对齐上已非瓶颈,但功能可供性和物理可操作性得分显著更低,成为最大能力缺口。
- 更强模型更倾向创建新部件,而较弱模型更多依赖检索现有部件,反映两者在创新与理解深度上的差异。
- 提供显式功能规格说明能大幅提升部件完整性、运动学正确性和物理可操作性;相比之下,迭代修订仅带来适度收益。
与基线对比解读
与传统 3D 生成评估仅关注几何质量不同,LMBuild 强调功能与可建造性,揭示出即使强大模型在抽象几何生成上已接近饱和,但在将结构与实际功能需求结合时仍显不足。闭源与开源模型间的差距主要体现在部件创建能力和场景状态跟踪上,开源模型存在“部件创建差距”和状态跟踪困难。这些结果指出,未来研究应聚焦于功能性推理、力学理解和新部件设计,而非单纯优化几何相似度。
行业影响
落地场景
LMBuild 评估的“可建造且功能性结构生成”能力可直接用于 智能 CAD/CAE、电商商品 3D 展示、机器人数字孪生 与 游戏/工业仿真资产生成。例如:
- 产品设计阶段,LLM 智能体根据自然语言需求自动生成包含零件分解、关节约束、材料属性与装配序列的完整结构,替代部分人工建模。
- 电商平台(家具、机械件)可由用户照片或文本描述生成可旋转、可拆解的 3D 商品模型,支持 AR 预览。
- 企业培训系统中,自动生成设备拆解/维护模型,并验证动态运动可行性,降低内容制作门槛。
商业价值
核心价值在 降本 与 体验提升 两条线:
- 降本:减少 CAD 工程师手工建模和装配验证时间;自动生成 BOM、装配工序及运动学约束,缩短设计迭代周期。
- 体验提升:电商或内容平台提供可交互拆解视图,降低用户理解成本,减少退货率;工业软件中嵌入 AI 生成模块可形成差异化订阅收入。
- LMBuild 的评估框架本身可作为 模型选型与回归测试基准,帮助团队快速判断 LLM 在功能性结构生成上的成熟度,避免盲目投入生产。
与现有产品/工作流的接口
LMBuild 输出的结构化表示(零件、关节、序列)可映射到主流工程格式:
- 与 CAD 工具(FreeCAD、SolidWorks API)对接,通过 JSON 驱动参数化建模。
- 与仿真器(Isaac Sim、Gazebo)或游戏引擎(Unity/Unreal)集成,自动生成 URDF/SDF 或 glTF 资产。
- 与 PLM/PDM 系统结合,将生成结果转为物料清单与装配说明书;同时用 LMBuild 环境做 CI 回归,监测模型迭代是否引入功能退化。
具体落地 use case
- 电商家具 3D 配置器:用户上传房间照片或输入“可升降办公桌,带抽屉”,LLM 智能体检索/创建零件并装配成可动模型,用户实时查看抽屉开合、桌腿调节,提升购买转化。
- 工业设备维护培训:需要拆装训练的复杂设备(如泵阀),自动生成带正确关节约束和拆装顺序的交互式数字孪生,培训内容制作时间从数天降至小时级。
局限
- **模拟环境与真实制造仍有差距**:LMBuild 的交互环境基于部件级装配模拟,虽引入了插入性、支撑稳定性等物理约束,但未考虑材料属性(如强度、弹性模量)、制造公差、动态负载、疲劳寿命等真实世界因素。数据集由现有 CAD 模型(如 PartNet)重新标注而来,对象类别和复杂度受限于原始数据分布,且 Wikipedia 补充的知识可能不完整或存在偏差,导致评估结论向特定对象类型倾斜,难以直接推广到任意结构或实际生产场景。
- **评估指标依赖启发式规则,缺乏全物理仿真**:结构稳定性、功能可行性和物理可操作性等关键指标主要基于程序化检查(如接触检测、关节运动范围判断),而非有限元分析或高保真物理引擎模拟。例如,中间支撑与稳定性评估可能只检查静态几何接触,未验证受力后的变形或破坏;功能性评估局限于几种离散运动类型(转动、滚动等),对复杂机构(如多自由度联动、能量转换)覆盖不足。因此分数可能高估或低估真实可构建性,需要后续与真实物理测试或工程仿真工具交叉验证。
- **与工程级装配验证工具相比仍有简化**:现有 3D 生成评估基准多关注几何相似度或视觉质量,LMBuild 开创性地引入物理可实现性维度,但其评估框架与专业 CAD 软件内置的装配验证(如干涉检查、运动仿真)、或通用物理引擎(如 PyBullet、MuJoCo)相比,在精度和广度上仍较简化。此外,基准没有包含真实制造结果作为对照,无法直接用于制造可行性认证。未来需结合更精细的物理仿真、实机验证或专家人工评估,以增强结论的工程可信度。