PerturBot: 用扰动训练打破视觉-语言-动作模型中的捷径先验
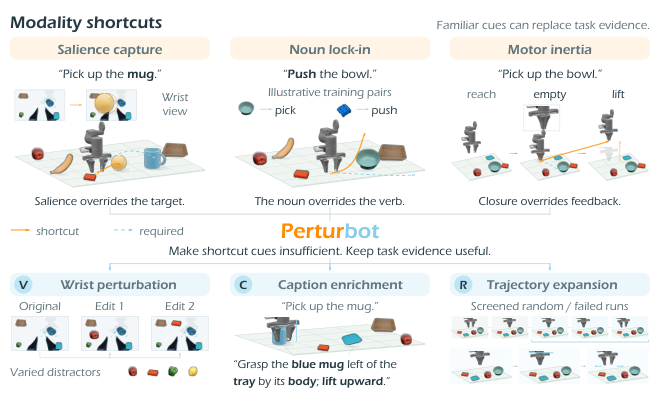
视觉-语言-动作(VLA)策略能完成复杂任务,却常忽略本应决定其动作的证据:握在腕部相机附近的物体会顶替指令目标。语言与动作呈现相同模式——熟悉的名词即使动词改变仍会触发训练时配对的操作,夹爪空抓也可能照样抬起。作者称这类依赖为 模态捷径(modality shortcuts):成功演示中的规律性让视觉、词汇或运动线索足以预测专家动作,而无需底层决策所需的任务证据;同类型演示再多可提升成功率,却让捷径原封不动。 为此提出 PerturBot ,让任务相关证据更易使用、捷径不再充分,具体包括: 1. 施加任务保持的腕部视角扰动; 2. 用含决策信息的描述丰富指令; 3. 加入随机与失败轨迹片段,并按其中实际行为重新标注。 它通过改变"被扩展的内容"来补充规模扩展,且不改变推理过程。 同时提出 GroundingFscore ,一种离线评分,用于诊断策略对模态捷径的依赖程度。任务成功率表明策略是否提升, GroundingFscore 则揭示扩展是否健康——依赖任务证据而非捷径。二者共同构成训练与评估框架,在保持对任务相关证据响应的同时,将 VLA 决策与捷径先验解耦。
论文精读
TL;DR PerturBot 通过任务保持的腕部扰动、指令增强与失败轨迹重标注,打破 VLA 模型的视觉/语言/动作捷径;GroundFscore 离线诊断捷径依赖,让策略在扩展时更依赖任务证据而非表面相关性,且推理保持不变。
问题
问题背景
VLA 策略在机器人操作中已能完成复杂任务,但可能忽略决定动作的核心证据,转而依赖训练数据中的表面相关。当前领域关注如何让策略真正理解任务语义,而非记忆捷径。
现有方法局限
主流做法是扩大演示数据的规模和多样性,但论文指出,更多同质演示只会提升任务成功率,而不破坏捷径。因为捷径本身就是“成功演示的规律”:例如手腕相机附近物体替代目标、熟悉名词触发固定操作、空抓后仍抬升。单纯数据扩充无法区分因果证据与相关噪声。同时,现有评估只看任务成功率,缺少离线指标来诊断捷径依赖程度,导致“成功率提升但策略不健康”的问题被掩盖。
为什么这个问题难/重要
多模态输入(视觉、语言、动作)高度耦合,捷径可能来自任何单一模态,破坏跨模态的真实因果绑定。要在不牺牲任务成功率的前提下消除捷径,需要设计训练干预与诊断指标,这比单纯加数据更困难。业界关注点在于机器人策略的泛化与可靠性:一个依赖捷径的模型可能在分布外场景下突然失效,造成严重安全风险。
行业类比
类似于大语言模型中学到“位置编码偏差”导致长上下文推理依赖无关位置,而不是内容本身。
核心洞察
- PerturBot 的核心洞察是 VLA 策略会学习跨模态捷径,且单纯增加演示数据无法消除这些捷径,必须通过针对性数据扰动来打破。已有工作往往只关注任务成功率的提升,而 PerturBot 定义了视觉、语言、动作三类模态捷径,并证明更多相似数据会让捷径更牢固。其独特之处在于不修改模型结构或推理过程,而是通过任务保持的手腕视角扰动、指令增强和失败片段重标记,从数据分布层面让捷径失效,同时保持任务证据可用,这与 scaling 范式互补,强调改变“缩放什么”比单纯缩放数据量更重要。
- GroundFscore 是首个离线诊断 VLA 捷径依赖程度的指标,将评估从结果导向提升到决策依据导向。传统任务成功率只能反映策略是否完成任务,无法揭示它是否依赖了正确证据。GroundFscore 通过量化策略对任务相关证据的使用程度,填补了“成功但不健康”的评估空白,与任务成功率形成互补的双指标框架。这对实际工程中避免伪泛化、挑选稳健模型至关重要。
方法
输入
Perturbot 的训练输入为视觉-语言-动作(VLA)演示数据,其中包含成功轨迹及额外采集的随机运动、失败执行记录。这些数据中普遍存在 modality shortcuts:腕部相机内物体位置、名词与动作的固定搭配、夹爪闭合后即抬起的运动惯性等,都可能成为模型预测的捷径,而非真实任务依据。
关键模块
- 任务保持的手腕视角扰动:对腕部相机图像施加不改变任务语义的扰动(如遮挡、平移或噪声),迫使模型不能依赖近距离物体位置,必须融合更全局的视觉证据。
- 决策相关标题增强:在原始语言指令中追加与动作决策直接相关的描述(如目标物体、操作动词),提升语言模态的任务相关信号,抑制名词锁定等词汇捷径。
- 随机与失败轨迹段重标注:从随机运动和失败执行片段中切取轨迹段,按其实际行为重新标注(如“抓空后抬起”标记为“未抓取便抬起”)。模型通过学习这些反例,学会不能仅凭运动模式预测成功动作。
三者共同使捷径不再单独成立,同时任务相关证据更易被利用。训练后策略保持原架构,推理无新增计算。
输出与评估
输出为降低捷径依赖的 VLA 策略,并配套 GroundFscore 离线指标,量化策略对模态捷径的依赖程度,与任务成功率形成互补诊断。
跟同类方法的差异点
与单纯增加同质成功演示的 scaling 思路不同,Perturbot 通过主动注入多样化扰动、决策相关标注和失败反例,改变被缩放的数据分布,在提升成功率的同时从根源上削弱捷径先验。
实验
实验设计
在 General Pick and Place 与 RoboTwin 2.0 辅助轨迹上评估。训练阶段引入三类干预:腕部视角扰动、决策相关 caption 增强、随机/失败轨迹 relabel。同时提出 GroundFscore 作为离线诊断指标。
关键发现
- PerturBot 能提升任务成功率,同时降低策略对 modality shortcuts 的依赖;
- 单纯增加同质演示数据可能提升成功率,但 GroundFscore 显示 shortcut 依赖依旧;
- GroundFscore 离线度量可区分“靠任务证据”与“靠捷径先验”的决策。
与基线对比
对比 plain scaling:PerturBot 改变被扩展的数据分布,而不是仅扩大规模;推理阶段无额外计算开销。GroundFscore 补充了成功率无法反映的策略健康度,提供训练-评估一体框架。
行业影响
落地场景
PerturBot 适用于机器人操作与具身智能产品,例如仓储物流机器人、工业装配机械臂、家庭服务机器人。在电商仓储分拣、制造业上下料、医疗辅助操作等场景中,可减少模型对视觉、语言、动作捷径的依赖,提升复杂指令下的执行准确率。
商业价值
通过打破模态捷径,模型在新环境、新指令、新物体组合下表现更稳健,直接降低错误操作率和人工干预成本。GroundFscore 提供离线健康度评估,可在部署前诊断策略是否依赖捷径,避免线上事故。对机器人解决方案商而言,能显著提升任务成功率与泛化性,减少重复数据收集与标注开销。
与现有产品 / 工作流的接口
PerturBot 的训练增强策略可嵌入现有模仿学习管线,无需改动推理架构。具体集成点包括:
- 数据层:加入 wrist-view 扰动、失败轨迹重标注与随机运动片段
- 指令层:使用决策相关 caption 增强指令
- 评估层:用
GroundFscore监控模型是否健康缩放,与success rate配合
适合与 OpenVLA、RT 系列等 VLA 模型及 RoboTwin、LIBERO 等基准协同。
具体落地 use case
- 电商仓储分拣:AGV 或机械臂分拣货物时,相机视角中物体遮挡、常见名词触发错误操作等问题可被缓解,提升履约准确率。
- 医疗机器人辅助操作:通过
GroundFscore诊断策略是否基于实际任务证据而非无关视觉/运动提示,确保动作安全合规。
PerturBot 提供了可直接复用的训练与评估框架,适合作为机器人数据飞轮中的质量增强模块。
局限
- - **数据收集成本与依赖**:PerturBot 需要引入大量随机运动和失败轨迹(例如 200 段随机运动 + 200 段失败执行),并对这些片段进行重新标记。在真实机器人场景中,获取足够的失败样本可能既昂贵又难以标准化,尤其是对于复杂技能或稀有失败模式。此外,失败轨迹的采集可能引入安全风险和额外人力成本,这使得该方法在实际部署中的扩展性受到限制,尤其对于资源有限的团队。
- - **实验覆盖范围与泛化性**:论文实验集中在 General Pick and Place 和 RoboTwin 2.0 等任务,可能主要基于仿真或受限的真实平台。虽然展示了跨技能的一定泛化能力,但尚未在更广泛的任务类别(如长程操作、接触丰富任务、多智能体协作)或不同 VLA 基础模型(如 OpenVLA, RT-2 等)上验证 PerturBot 的有效性。其收益是否随模型规模和任务多样性持续保持,仍需进一步研究。
- - **GroundFscore 指标的局限性**:GroundFscore 作为离线诊断指标,能够一定程度反映模型对捷径的依赖,但它可能依赖于特定的数据构造和评估协议,难以直接迁移到其他领域或未标注数据。此外,该指标与真实部署性能之间的相关性尚未充分验证,可能存在“指标提升但实际成功率不升”的风险。未来需要更多实证研究来建立指标与下游任务表现的稳固联系。