Periscope: 将冻结语言模型扩展至其上下文窗口之外
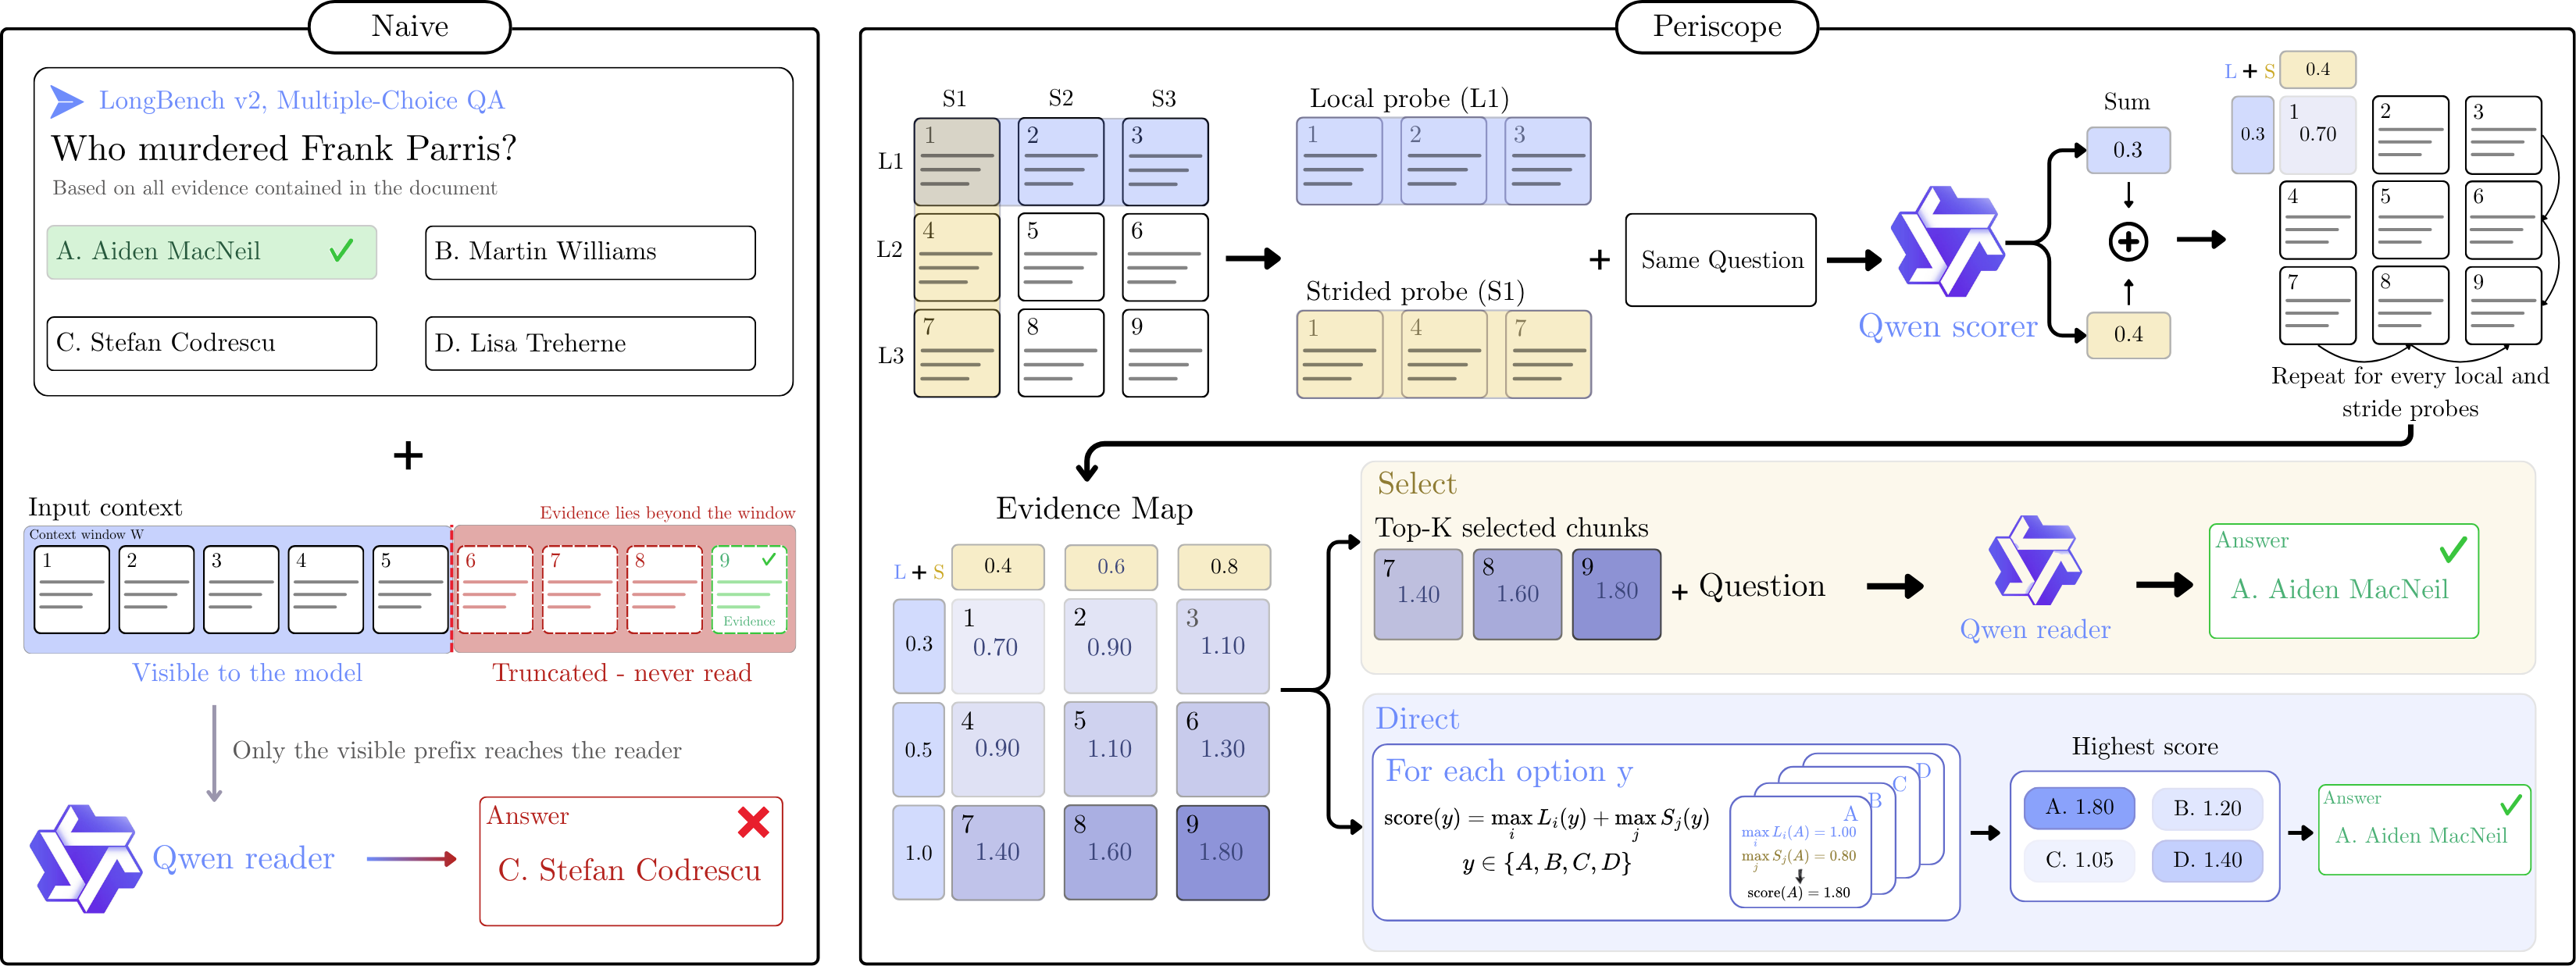
语言模型在一次二次复杂度的前向传播中读完长文本,读到上下文窗口 就停下,甚至在抵达窗口之前,精度便随长度下降。我们追问:当决策只落在有限集合上(哪篇文档相关、哪个选项被支持、哪段文字是证据)时,这次读取能否被因式分解? Periscope 是一种免训练的推理方法。它把一段文本的 N 个 chunk 排布在 K×K 网格上,其中 K = ⌈√N⌉,然后向冻结模型提出同一个问题,分别针对 K 个由连续 chunk 构成的局部 span 和 K 个采样全文的跨步 span,并在单个 token 上读取每个答案的对数几率。每个答案取其局部与跨步中的最优得分;用这两个 span 为每个 chunk 打分,就能零额外开销地得到一张证据图,其峰值即答案背后的 chunk。每次探测只涉及 s·c 个 token(文本长 s、chunk 大小 c),因此 W token 的窗口以 s^1.5 的代价覆盖 W²/c 个 token。这张图取代了长读取。 在 LongBench v2 上,只读取证据图排名最高的 K 个 chunk(约 9k token),即可匹配同一模型在 32k 到 1M token 各窗口下的最佳读取;在 InfiniteBench(中位上下文 150k token)上,它比最佳窗口读取领先 5 个点。同一张图在 BRIGHT 的长文档语料上取得了六种方法中最高的 NDCG@10。 每次调用只缓存一次探测,因此 27B 模型可在单张 80GB GPU 上读取 4.5M token 的上下文,而单次完整前向需要 296GB 缓存。长读取所需的 GPU,只要能装下模型,而不必装下文本。
论文精读
TL;DR Periscope 用局部与跨步探针为长文本分块打分并生成证据图,让冻结语言模型无需训练即可处理远超上下文窗口的文本,在 LongBench v2 等基准上以极低显存达到或超越窗口读取效果。
问题
问题背景
当前大语言模型(LLM)的长上下文能力成为竞争焦点,模型上下文窗口从 128K 扩展到 1M 甚至更长,以支撑长文档问答、多跳推理、证据定位等任务。
现有方法局限
- 注意力二次复杂度:标准 self-attention 的计算与 KV cache 内存随输入长度 O(n²) 增长,1M token 的单次 forward 可能需要数百 GB 显存,难以在单卡部署。
- 窗口内性能退化:即使输入未超过窗口,模型在长文本上的准确率仍随长度下降,存在“有效上下文”远小于宣称窗口的现象。
- 训练或架构修改成本高:现有扩展上下文方法(位置编码外推、稀疏注意力、检索增强)要么需要额外训练,要么改变模型结构,无法直接复用已冻结模型;检索式方法还会丢失跨块依赖关系。
- 内存瓶颈:单次长读入需要缓存全部中间激活,GPU 显存成为硬约束,无法按需扩展。
为什么这个问题难/重要
长上下文任务要求模型同时把握全局结构和局部细节,但注意力机制很难在计算可行性与信息完整性之间取得平衡。业界需要训练无关、即插即用的推理方案,避免重新训练大模型的高昂成本,同时能在现有硬件上处理超长文本。该问题的解决直接影响 RAG、长文档问答、法律/金融文本分析等场景的落地。
行业类比
类比于在数万页技术手册中快速定位合规条款:不是从头到尾逐页精读,而是先扫描目录和索引,再对候选页做精读——用低成本筛选替代高成本全量阅读。
核心洞察
- Periscope 的核心洞见是将长文本决策因子化为“局部连续块探测 + 跨步全局采样探测”的组合评分,而非直接建模整个上下文。与扩展上下文窗口(如 LongLoRA、YaRN)或检索增强(RAG)不同,它完全训练自由,通过将 N 块排列在 sqrt(N)×sqrt(N) 网格上,以 O(N^1.5) 成本获得每个答案的最优局部/跨步对数几率,从而在基准上匹敌甚至超越直接长读。该方法的独特性在于利用有限答案集合的性质,将“读长文”转化为“多尺度问短片段”,避免了长距离注意力退化,同时保持全局信息覆盖。
- Periscope 引入的“证据图”机制使其在决策之外天然提供块级定位能力。通过对每个文本块计算其局部和跨步得分,峰值块即回答的证据所在,这使得模型不仅能给出答案,还能指出依据。与现有长上下文模型仅输出答案不同,也与需要独立训练检索器的 RAG 系统不同,Periscope 的评分过程直接生成可解释的块重要性排序,且该排序在 BRIGHT 长文档检索上取得了六种方法中最佳的 NDCG@10。这种“推理即检索”的特性将长文本推理的瓶颈从 GPU 显存转移到模型本身,使 27B 模型处理 4.5M tokens 仅需一张 80GB GPU。
方法
输入与分块
Periscope 接收长文本和一个有限答案集的问题(如文档相关性判断、选项支持判断)。将文本切分为 N 个等长 chunk(块),块大小 c 可配置。随后构建一个 K×K 的网格,其中 K = ceil(sqrt(N))。网格的每一行对应一组局部跨度(local span),由连续块组成,数量为 K;每一列对应一组步幅跨度(strided span),从全文中按固定步长采样块,数量也为 K。每个跨度覆盖约 sqrt(sc) 个 token,其中 s 为原文 token 总数。
局部与步幅探测
对于每个跨度,Periscope 向冻结语言模型发出同一个问题,要求模型在一个 token 上输出每个候选答案的 log-odds(对数几率)。这一步相当于对每个答案进行轻量级打分,而不需要生成完整句子。每个答案分别记录其在局部跨度和步幅跨度上的最佳得分。由于局部跨度连续、步幅跨度全局,两种视角互补地捕捉局部证据和全局上下文。
证据图与最终输出
将每个 chunk 对应的局部跨度得分和步幅跨度得分相加,构成一张证据图(evidence map),图上峰值位置即为该答案最相关的 chunk。模型最终选择在证据图中得分最高的答案作为输出,并同时给出该答案的证据 chunk 位置。整个流程无需训练,只依赖预训练模型的内部判断。
与同类方法的差异点
与直接扩展上下文窗口、分块递归或者检索增强生成等方法不同,Periscope 通过二维网格分解将长文本的推理成本从二次方降低到 s^1.5 量级,并且以证据图的形式显式定位关键信息,避免了对全文的二次注意力计算或外部检索器的依赖。
实验
实验设计
Periscope 在三个长上下文基准上验证:LongBench v2(多任务问答)、InfiniteBench(中位上下文 150k tokens)、BRIGHT(长文档检索)。对比基线包括同一模型在不同窗口大小(32k 至 1M tokens)下的标准窗口读取,以及其他五种检索方法。评估指标涵盖任务准确率、检索 NDCG@10 与内存消耗。
关键发现
- LongBench v2:仅读取地图排名最高的 K 个 chunk,共 9k tokens,即匹配同一模型在 32k 到 1M 窗口下最佳窗口读取的准确率。
- InfiniteBench:Periscope 领先最佳窗口读取 +5 points。
- BRIGHT:证据地图在六种方法中取得最佳 NDCG@10。
- 内存效率:27B 模型在单张 80GB GPU 上可处理 4.5M token 上下文,而单次前向需要 296GB cache。
与基线对比解读
与传统窗口读取相比,Periscope 用 K 次局部与跨步探针代替一次性长上下文前向,将注意力成本从二次方降为 s^{1.5} 量级。该方法无需训练,通过因子化读取将超长文本决策分解为有限答案集上的评分,突破了上下文窗口限制,同时大幅降低显存需求,使超长文档处理不再受限于 GPU 显存容量。
行业影响
落地场景
Periscope 可嵌入长文档问答、证据检索、合规审计等产品。例如:
- 金融研报分析:对数百页 PDF 自动回答“哪份文件支持该投资结论”,并定位证据段落。
- 法律合同审阅:从超长合同中提取关键条款的支持证据,无需切分导致上下文断裂。
- 电商商品内容理解:处理商品详情页的长图文描述,增强搜索与推荐的相关性。
商业价值
- 降本:单张 80GB GPU 可处理 4.5M token 上下文,对比单次 forward 需 296GB 缓存,硬件成本下降约 3-4 倍;推理时仅缓存一个 probe,节省显存。
- 增收/体验:LongBench v2、InfiniteBench 上匹配或超越最佳窗口读取,长文档任务准确率提升 5 点,减少用户手动翻阅时间,增强付费意愿。
与现有工作流的接口
- 作为无训练插件直接接入现有 LLM API 或本地推理框架,不改动模型权重,无需 fine-tuning。
- 输出 evidence map 可对接现有检索系统(如向量数据库)的粗排后精排,或作为 RAG 的 reranker。
- 与 vLLM、LMDeploy 等推理框架集成,只需实现 probe 生成与分数聚合模块,成本低。
具体用例
- 企业知识库问答:一家跨国法律科技公司使用 Periscope 处理千万级合同库,用户问“某条款在哪些文档中出现”,系统输出答案并高亮证据 chunk,减少律师复核时间。
- 在线教育平台:长视频课程逐字稿问答,学生提问“讲师在哪个时间点解释过这个概念”,Periscope 直接从百万 token 转录稿定位证据区间。
局限
- 适用任务范围有限。该方法仅适用于候选答案集有限的决策场景,如多项选择、证据定位、文档相关性排序等,通过比较不同答案的 log-odds 完成判断。对于开放域生成、自由形式问答或需要输出任意文本的任务,Periscope 无法直接应用,因为其推理机制依赖于预先定义的答案空间,无法生成未在候选集中的内容。这限制了其在真实世界对话系统或创意生成等场景中的使用。
- 推理延迟与超参数敏感性。虽然单次 probe 的序列长度较短,但每个问题需要执行 K 个局部 span 和 K 个 strided span 的前向传递,总计算量约为 O(s^{1.5}),对于中等长度文本,其延迟可能高于直接读取完整上下文的朴素方法。此外,chunk 大小 c 和网格维度 K 是人工设定的超参数,论文未系统分析其对性能的影响,实际部署时需要针对不同任务和文本长度进行调优,增加了工程成本。
- 跨 chunk 依赖捕获能力存疑。Periscope 通过局部和 strided span 组合来近似全文信息,但 strided span 的采样可能遗漏关键的跨段落推理线索,尤其对于需要多跳关联或全局一致性的复杂任务(如法律条文交叉引用、长文档逻辑推理),证据图的峰值不一定对应真实答案依据。论文仅在部分基准上验证了证据定位的准确性,未与具备原生长上下文能力的模型(如使用稀疏注意力或状态空间模型的架构)在更广泛的任务上进行系统对比。