一个 AI token 值多少?野生 AI 生成网页文本的 scaling laws
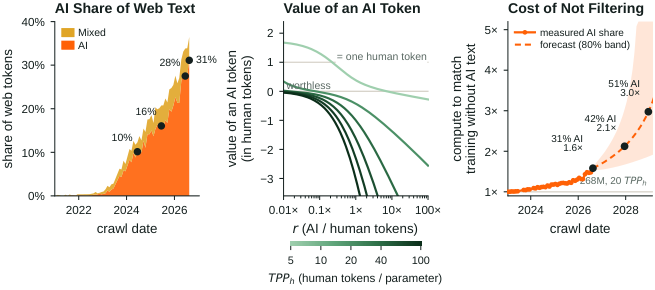
网页文本是预训练数据的主体,且越来越多由 AI 生成。经 FineWeb 质量过滤后,2026 年 6 月的网络数据中有 27.5% 的 token 被 Pangram 判为 AI 生成,8 月升至 31.1%。这类野生 AI 文本来自众多模型、面向人类读者、未加标注地进入预训练语料,不同于合成数据或模型坍缩场景。 我们预训练了 800 个语言模型,调节加入的 AI token 与人类 token 比例,并对人类文本和 AI 文本上的留出损失分别拟合 scaling law: - 数据匮乏的模型加入 AI token 起初可降低人类文本损失,但收益很快饱和并反转为损害; - 人类文本预算充足的模型上,AI token 几乎立即抬高损失,等量新鲜人类 token 则持续降低损失; - Hoffman et al. (2022) 等 scaling law 无法预测该行为。 我们提出新的 scaling law,分离收益项与损害项,允许 AI token 的价值变号,并在无 AI 文本时退化回 Chinchilla。在小模型上拟合后,它可预测最多 3.6 倍 大模型的留出人类文本损失,在所有 AI 比例下误差比现有最佳定律低 41%。 建议:目标为人类文本时过滤 AI 文本;扩充数据集前先重复人类文本;分别报告人类与 AI 文本的验证损失——目标为 AI 文本时 AI 文本仍有价值。发布 WildAI (83B token,带 AI/主题/格式标注)及全部模型与代码:https://github.com/pangramlabs/WildAI。
论文精读
TL;DR 该论文用 800 个预训练模型量化了网络爬取数据中混入 AI 生成文本的价值:AI token 对降低人类文本损失先有益、后随比例与数据预算反转成害,并提出可区分收益与损害的新 scaling law,预测误差比现有最佳低 41%。
问题
问题背景
随着生成式模型大规模部署,互联网文本中 AI 生成内容的占比正在快速上升。预训练数据从以人类书写为主转向人机混合,如何量化并应对这些未标注的“野生”AI 文本对语言模型训练的影响,成为数据工程和缩放定律研究的新焦点。
现有方法局限
传统缩放定律(如 Hoffmann et al. 2022 的 Chinchilla)假设训练数据为独立同分布的人类文本,无法刻画混合 AI 文本后损失的非单调变化:初期有益,随后迅速转为有害。针对合成数据或模型崩溃的研究通常局限于单一模型自生成数据,与真实 web 中多模型、面向人类读者、未标注的 AI 文本分布存在显著差异。此外,常用质量过滤器(如 FineWeb)难以区分 AI 与人类文本,论文实测发现 AI 文本更易通过过滤,导致污染加剧。现有方法既无法预测 AI token 边际价值由正转负的临界点,也缺少基于缩放定律的过滤或重复策略。
为什么这个问题难/重要
AI 文本与人类文本在风格、信息密度、潜在偏见上存在系统性差异,且训练目标不同价值不同:对预测人类文本有害的 token 可能对预测 AI 文本仍有价值。数据稀缺时 AI token 提供额外多样性有益,但数据充足时引入分布偏移和重复模式损害人类文本性能。预训练数据规模巨大,人工标注或过滤成本高昂,必须依赖自动检测和缩放定律指导。业界关注训练数据质量、数据飞轮效应以及模型在人类文本上的退化风险,该问题直接关系到模型能力上限与安全性。
行业类比
类似于推荐系统中低质机器生成内容与用户原创内容混杂,平台必须区分来源以优化内容质量;大模型预训练同样需要评估 AI 生成数据的边际价值,避免数据污染导致性能下降。
核心洞察
- 野生 AI 文本首次被纳入 scaling law 框架,揭示其价值非线性且会逆转。与合成数据或模型坍缩研究不同,该工作采集的是互联网上多模型生成的、面向人类读者的未标注 AI 文本,并通过 800 个预训练实验拟合出 benefit 与 harm 分离的 **新 scaling law**。这一角度弥补了现有数据混合 scaling law 无法处理 AI token 由益转害的缺陷,对真实网页数据治理有直接借鉴。
- AI token 的价值取决于训练预算与目标域,这推翻了单一数据价值假设。在数据匮乏时添加 AI token 可先降人类文本损失,但饱和后反转为害;在充足人类数据预算下,AI token 几乎立即提升损失,而等量人类 token 持续下降。这一发现解释了为何简单沿用 **Chinchilla** 或重复 scaling law 均会误判,并支持工程上过滤 AI 文本、重复人类数据、分开验证损失的策略。
方法
输入
从 Common Crawl 等来源抓取网页文本,先应用 FineWeb 质量过滤,再用 Pangram 检测器 对每个文档标记 AI 生成概率,得到带标签的人类文本与 AI 文本两类语料。统计过滤前后 AI 占比(如 27.5% 升至 31.1%),并据此构造不同混合比例的预训练数据。
关键模块
数据混合与训练配置
固定模型架构与 tokenizer,训练 800 个语言模型,参数量覆盖多个量级。每个模型使用特定的人类 token 预算(D_h),并在此基础上按不同比例加入 AI token(D_a),形成从纯人类到高 AI 占比的完整谱系。评估与观测
在 held-out 集上分别计算 human text loss 和 AI text loss。实验发现:低人类预算下,少量 AI token 能降低 human loss,但增益快速饱和并转为有害;高人类预算下,AI token 几乎立即增加 loss,而同等数量的新鲜人类 token 仍持续降低 loss。新 scaling law 设计
传统 Chinchilla 定律L = E + A/N^α + B/D^β无法解释该非单调行为。作者提出双效应 scaling law:在 Chinchilla 基础上加入两项——收益项(描述 AI token 在数据匮乏时的信息补充作用)和损害项(描述 AI token 带来的分布偏移或噪声干扰)。两项均显式依赖人类预算与 AI 比例,使得 AI token 的边际价值可随训练状态改变符号;当D_a = 0时,公式退化为标准 Chinchilla。模型选择与外推验证
在小模型上拟合新定律参数,外推到 3.6 倍大的模型,与 Hoffman et al. (2022)、Shukor et al. (2025) 等现有定律对比,在全部 AI 比例上预测 held-out human loss 的误差降低 41%。
输出
得到可预测任意 AI 比例影响的 scaling law,同时发布 WildAI 数据集(83B tokens,含 AI/主题/格式标签)、全部 800 个模型权重及代码。核心结论:目标为人类文本时应过滤 AI 文本;数据匮乏时 AI token 有短时正向价值,但总体不宜替代新鲜人类数据;验证损失需区分 human / AI 分别报告。
与同类方法的差异点:现有数据混合 scaling law 大多假设各域数据可线性叠加或仅面向合成数据,本工作首次对“野生”AI 网页文本建立显式的收益饱和与损害增长双项模型,并通过海量实验验证了跨模型规模的可外推性。
实验
实验设计
作者收集 2026 年 6 月与 8 月的网页文本,经 FineWeb 质量过滤后用 Pangram 标注 AI 生成 token,构建不同 AI/human 比例的训练数据。随后训练 800 个语言模型,变化添加的 AI token 比例,并在 human 与 AI 生成文本的 held-out 集上评估 loss,拟合 scaling laws。
关键发现
- 在 human 文本 充足时,添加 AI token 几乎立即提高 held-out human loss;但在数据饥饿场景,少量 AI token 可降低 loss,饱和后转为有害。
- 现有 scaling law(如 Hoffmann et al., 2022)无法预测该 sign change;新提出的 scaling law 引入独立的 benefit 与 harm 项,在无 AI 文本时退化为 Chinchilla。
- AI token 对 AI 目标文本仍具价值;建议当目标为 human 文本时过滤 AI 文本,重复 human 文本优于添加 AI 生成 web 文本。
与基线对比
新定律在较小模型上拟合后,预测大至 3.6 倍模型时误差较最佳现有定律降低 41%,证明 wild AI text 的双重效应需单独建模。该结果提示实际训练中应分别报告 human 与 AI 文本的验证 loss,并谨慎评估 AI 数据价值。
行业影响
落地场景
本文对预训练数据管道与AI 检测服务有直接应用。内容平台在构建训练语料时,可在 FineWeb 质量过滤后追加 AI 文本检测 步骤,自动剔除或标记 wild AI text。例如,电商平台用户评论与商品描述中混杂 AI 生成内容,若不过滤会降低下游搜索与推荐模型的泛化能力;新闻聚合平台训练生成模型时,过滤 AI 文本可减少事实偏差与“AI 味”。独立的 AI 占比监控 API 也可作为产品,为模型训练方提供实时数据健康度报告。
商业价值
- 降本:避免低效 AI token 浪费训练算力。论文证明在充足人类数据预算下,添加 AI token 会提高 held-out human loss,过滤可直接减少无效训练支出。
- 模型质量提升:对以人类文本为目标的模型,过滤 AI 文本能保持生成自然度与事实一致性,改善用户体验。
- 数据策略优化:指导何时重复人类数据优于扩展 AI 数据,帮助团队更精准地分配数据采购与标注预算。
与现有工作流集成
- 将 Pangram 检测器 作为可选过滤器接入现有数据清洗流水线,输出
AI_score标签,便于后续采样或加权。 - 训练框架支持分离验证集:同时监控
human_text_loss与AI_text_loss,一旦出现交叉趋势即可触发数据策略调整。 - 直接使用 WildAI 数据集作为负样本或基准,评估模型对 AI 文本的鲁棒性;发布方可将该数据集集成到数据质量看板中。
局限
- - **标签噪声**:论文依赖 Pangram 与 EditLens 对 web 文本进行 AI 生成标注,但这些检测器本身存在误判风险;尽管作者在附录中分析了 pre-ChatGPT 文本的误报率,但残余的标签噪声仍可能使 scaling law 拟合产生偏差。特别是对于风格接近 AI 的人类文本(如模板化、学术腔),误判可能更严重,导致对 AI 文本价值的估计不准确。此外,数据仅来自 2026 年 6-8 月的快照,AI 生成文本的特征会随模型迭代快速变化,时间泛化性存疑。
- - **模型规模与预算限制**:所有实验基于 800 个相对较小的模型(具体参数范围论文未在摘录中详述),受限于计算资源,训练 token 预算(human budget)可能远低于真实大模型预训练规模。虽然作者展示了 scaling law 外推到 3.6 倍大模型上的预测能力,但并未直接训练大规模模型验证,外推的可靠性仍待检验。此外,数据混合中 AI token 比例变化范围、重复策略等实验设置可能与实际 web 数据分布存在差异,削弱了结论的直接可迁移性。
- - **评估指标单一**:论文主要关注 held-out loss(human 与 AI text 上的损失),虽然附录提到下游指标,但核心结论基于损失变化。然而,预训练模型的实际价值更体现在下游任务表现(如推理、知识、指令遵循)上;损失下降与下游性能并不总是正相关,尤其是当模型在 AI 文本上过拟合时可能损失很低但生成质量变差。论文建议“分开报告验证损失”,但未能系统评估过滤或添加 AI 文本对下游任务的实际影响,这使得“AI token 价值”的结论对产品决策的指导有限。