MemLife: 长期第一人称视频记忆的整理与推理
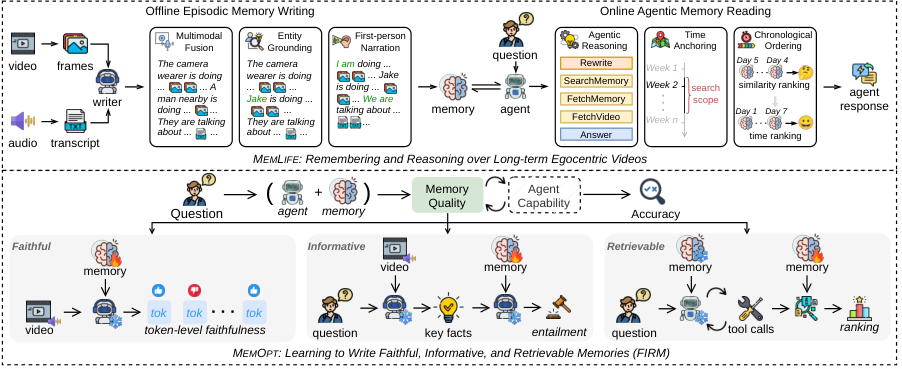
长期第一人称(egocentric)视频让个性化 AI 助手能够推理用户的日常生活。然而,当视频历史累积到跨越数月乃至数年的数百小时规模时,为每次查询重新处理原始片段在计算上难以承受。 记忆系统(Memory systems) 通过将视频压缩为文本表示提供了可扩展的替代方案,但在实际基准上常常失效:要么记忆未能保留关键证据,要么检索器在持续增长的搜索空间中因检索竞争 而无法定位相关条目。 为此,我们提出 MemLife,一个多模态记忆系统:它构建以实体为锚点的第一人称文本剧集,并通过时间索引的智能体阅读器(agentic reader) 进行检索。无需训练、也无需在查询时访问视频,MemLife 在四个 长时程基准 上比最强的免训练基线提升 4.6--12.0%。 为进一步提升记忆质量,我们提出 MemOpt,一个强化学习 框架,用于优化记忆写入器(memory writer),使其产出忠实、信息丰富且可检索的记忆。MemOpt 在不同视频与问题分布上稳定提升 MemLife 达 2.7--5.0%,且增益可泛化到不同的写入器与阅读器骨干网络以及不同记忆系统。
论文精读
TL;DR MemLife 将长期第一人称视频压缩为实体接地文本记忆,并用时间索引 agentic reader 检索,无需训练即超越最强 baseline 4.6-12.0%;MemOpt 强化学习进一步优化记忆质量,提升 2.7-5.0%。
问题
问题背景:长期 egocentric video 为个性化 AI 助手提供了理解日常生活的数据基础,但视频历史往往累积至数百小时、跨越数月乃至数年,对每个查询重新处理原始视频的计算成本不可接受。
现有方法局限:记忆系统通过将视频压缩为文本表示来缓解扩展性问题,但现有方案在实用基准上普遍失败,原因可归结为两类:一是记忆写入阶段损失关键证据,文本摘要过度简化或遗漏重要交互细节;二是检索阶段面临检索竞争(retrieval competition)——随着记忆库增长,相似条目增多,标准 top-k 检索或向量相似度排序难以在时间跨度大、实体混合的场景中准确定位相关记忆。此外,常见压缩方法忽视时间顺序和实体关联,导致检索到条目后缺乏足够上下文完成推理。
为什么难/重要:核心挑战在于压缩率与保真度的矛盾,同时检索器必须兼顾时间敏感性与可扩展性。业界关注持续升温,因为 AR 眼镜、可穿戴设备等持续产生第一人称视频流,若要支持“我上周三在会议室和谁讨论了什么”这类自然查询,就必须有可靠的长期记忆层,而不是每次调用多模态模型处理原始视频。
行业类比:这一挑战类似于企业知识库 RAG 系统中的长期记忆管理——不是简单存储更多文档,而是需要结构化、可回溯且抗检索干扰的记忆表示。
核心洞察
- MemLife 将长期自我中心视频记忆构建为实体基础的、第一人称文本片段(episodes),并通过时间索引的 agentic reader 进行检索。这直接针对长期视频记忆中的两个痛点:记忆压缩导致关键证据丢失,以及检索空间增大引发的检索竞争。与常见的全局向量相似度检索不同,时间索引和 agentic reader 允许系统按时间顺序定位相关片段并迭代推理,在不访问原始视频的条件下保持证据完整,为工程实现提供了一种计算高效且可扩展的记忆架构。
- MemOpt 采用强化学习优化记忆写入器,显式将“可检索性”作为奖励信号,训练写入器生成忠实、信息丰富且易于被读取器找到的记忆。传统记忆系统通常只优化信息压缩质量(如摘要准确性),但未考虑下游检索难度。MemOpt 通过可检索性追踪与回放,使记忆在写入时就考虑读取器的检索行为,从而在无需训练读取器或查询时视频访问的前提下提升整体 QA 性能,训练与推理解耦的设计具有实际部署价值。
- MemLife 在四个长时基准上相对最强无训练基线提升 4.6–12.0%,MemOpt 进一步带来 2.7–5.0% 的稳定增益,且跨不同 writer/reader 骨干和记忆系统泛化。这表明其方法不依赖特定模型能力,而是系统层面的创新。对工程团队而言,可以灵活替换底层 LLM/VLM 而保持记忆质量提升,降低技术栈锁定风险。
方法
输入
- 长期以自我为中心的视频流(egocentric video),时长可从数百小时到跨年。
核心模块
记忆写入器(Memory Writer):将原始视频压缩为 实体基础的、第一人称文本片段(entity-grounded, first-person text episodes)。具体地,系统识别视频中的关键实体(人物、物品、地点),并以第一人称视角生成结构化叙事,保留证据细节。写入过程不依赖查询,一次性构建。
记忆读取器(Memory Reader):采用 时间索引的 agentic reader,在查询时动态检索相关记忆。读取器以时间作为索引结构,通过多步代理行为(agentic)逐步缩小搜索范围,缓解大规模记忆库中的 检索竞争(retrieval competition),提升定位精度。读取器无需访问原始视频,仅基于文本记忆回答问题。
MemOpt 训练框架:通过 强化学习 优化记忆写入器,奖励信号同时衡量记忆的 忠实性(faithful,与视频内容一致)、信息量(informative,包含足够证据)和 可检索性(retrievable,便于读取器定位)。训练使用离线收集的检索轨迹,结合 token 级别的组相对目标(group-relative objective)进行策略更新。
输出
- 系统输出对用户查询的答案,推理过程基于检索到的记忆文本,全程无需访问原始视频。
与同类方法的差异
- 与将视频压缩为通用摘要或简单文本字幕的方法不同,MemLife 通过实体基础的第一人称片段保留细粒度证据,并用时间索引的 agentic reader 避免单一稠密向量检索中的检索竞争;MemOpt 进一步以 RL 显式优化记忆的可检索性,而非仅关注压缩质量。
实验
实验设计
在 四个长时域基准 上评估 MemLife 与 免训练基线 的性能。评估不涉及查询时视频访问,仅使用预构建的文本记忆。进一步地,通过 MemOpt 强化学习框架优化 memory writer,并在不同视频与问题分布上检验泛化性。
关键发现
- MemLife 较最强免训练基线提升 +4.6~12.0%(跨四个基准)。
- 引入 MemOpt 后,MemLife 再提升 +2.7~5.0%,且增益在多种 writer/reader 骨干和记忆系统上均保持一致。
- 该方法无需训练或查询时视频访问,说明记忆质量与检索机制是主要瓶颈。
与基线对比解读
免训练基线通常直接对原始视频或简单文本摘要进行推理,面临证据丢失或检索竞争问题。MemLife 通过实体锚定的第一人称文本片段和时间索引的 agentic reader 缓解了这两点;MemOpt 则进一步用强化学习优化记忆的忠实性、信息量与可检索性,从而在长时域任务上获得稳定增益。这表明针对记忆系统的协同优化比单纯扩大模型或重放视频更具可扩展性。
行业影响
落地场景
MemLife 可直接用于个性化 AI 助理:智能眼镜 / 可穿戴设备连续录制第一人称视频,系统将其压缩为实体锚定的文本片段,支撑“我上周把钥匙放在哪儿了?”“昨天会议上谁提过 XX?”等查询。企业场景中,可用于现场服务记录:工程师佩戴摄像头,AI 按时间索引回放维修步骤;或用于医疗康复监测,追踪患者日常活动。
商业价值
核心降本:将数百小时视频预处理为可检索文本记忆,避免每次查询重扫原始视频,降低推理算力成本;MemOpt 强化学习优化记忆质量,提升检索命中率,减少人工回看。同时提升体验:毫秒级时间索引检索让 AI 助理具备长期记忆,增强用户粘性,支撑订阅制服务。
与现有产品/工作流集成
MemLife 可嵌入现有视频存储 + LLM 对话栈:视频经视频理解模型生成文本片段,存入带时间索引的向量数据库,agentic reader 按时间窗口检索。无需训练、无 query-time 视频访问,可快速封装为 API 或库,与现有 RAG 管道、企业知识库、设备端助手结合。
局限
- **MemOpt 训练开销较大**:训练过程需要收集 retrievability trace 并 replay,涉及强化学习优化,计算资源和时间成本较高。虽然论文提供了效率分析,但在更大规模视频库(如数万小时)上的可扩展性仍不明确,可能限制实际部署。此外,训练稳定性依赖于奖励设计,附录 G 中的 reward dynamics 显示波动,实际调参需要额外工程投入。
- **文本记忆可能丢失视觉细节**:MemLife 将视频压缩为实体基础的第一人称文本片段,虽然便于检索与推理,但可能丢失外观、空间关系、非实体动作等视觉信息。对于需要细粒度视觉识别(如区分相似物品)或视觉推理(如理解遮挡、动作细节)的查询,性能可能受限。与端到端视频问答模型相比,检索式文本记忆存在信息瓶颈。
- **读取器训练未充分探索**:论文附录 H 讨论了 memory reader training,但 MemOpt 仅优化写入器,读取器保持固定策略。在检索竞争严重的场景下,固定读取器可能无法充分利用记忆内容,限制系统上限。此外,MemLife 依赖时间索引的 agentic reader,其推理过程可能带来额外延迟,大规模实时应用中的效率需要进一步验证。