Looped Mixture of Experts 的 Scaling Laws
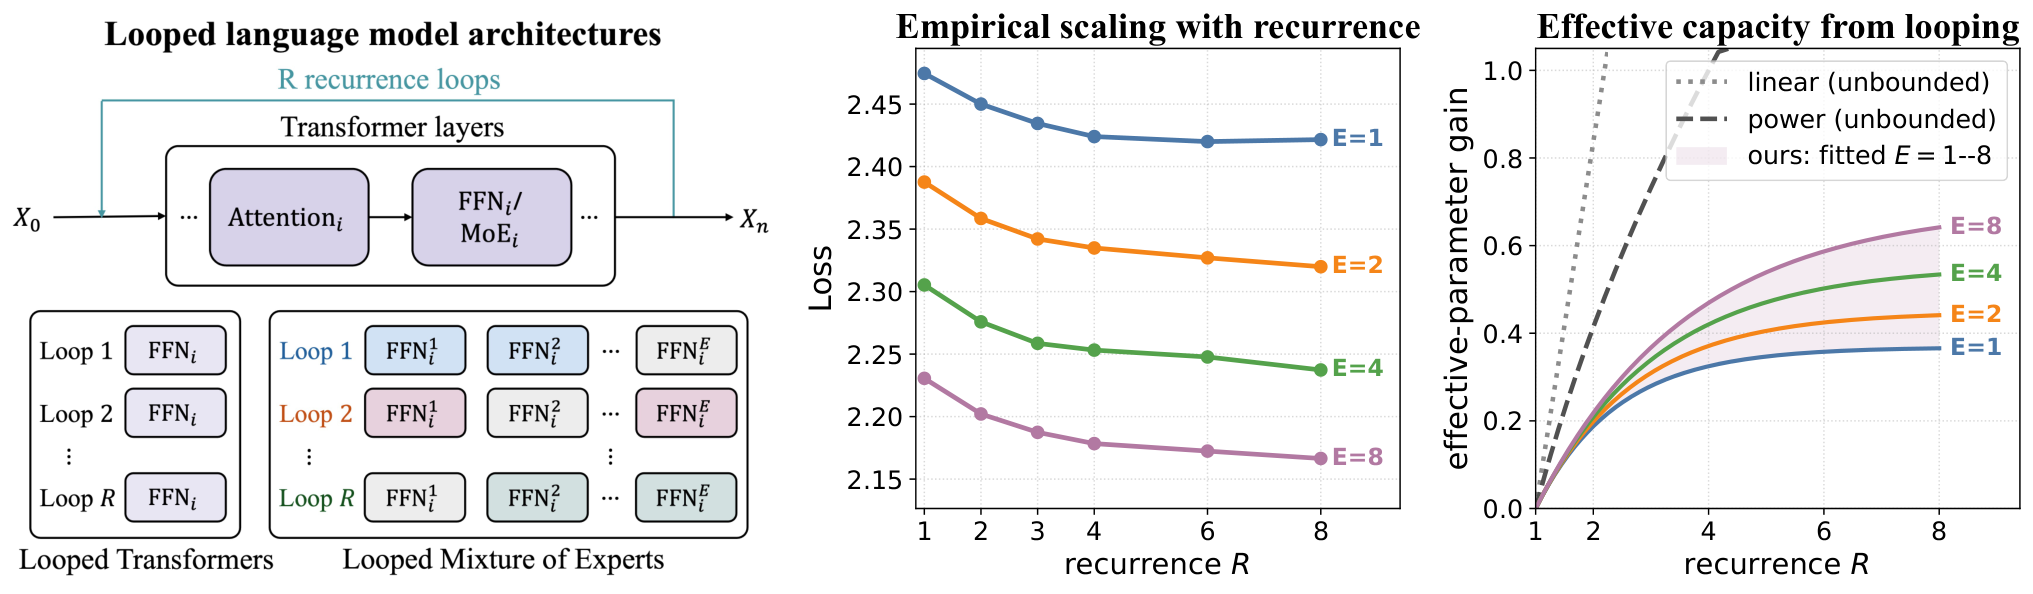
Looped transformer 与 Mixture-of-Experts (MoE) 为高效扩展提供了互补路径:循环在固定参数量下提升计算深度,MoE 稀疏性在固定激活计算下扩展总容量。但已有 scaling laws 只孤立地建模循环或稀疏性。 本文提出 Loop Scaling Laws,首次将循环与稀疏性和模型规模、数据量联合建模。其核心是一个有界的、稀疏性条件的循环映射,刻画循环带来的有效参数增益,以及稀疏性如何抬高该增益。该定律对 looped 模型的 held-out loss 预测比既有方案更准,并能把标准 dense 与 MoE scaling laws 作为特例回收。除预测外,拟合出的定律还为在算力与显存约束下设计 looped MoE 提供了有原则的基础。 下游评测显示两轴互补:稀疏性带来约 3x 激活参数效率,循环在推理上带来约 2x 总参数效率,联合扩展进一步推进性能前沿。在 trillion-token 规模、匹配训练计算量时,采用 law-derived recurrence 的 looped MoE 在推理基准上匹敌约 2x 大的非 looped MoE,并可通过循环实现 test-time scaling。
论文精读
TL;DR 提出 Loop Scaling Laws,首次将循环深度与 MoE 稀疏纳入统一 scaling law,精确预测 looped MoE 损失并指导资源约束下的模型设计;实测稀疏带来约 3x 激活参数效率、循环约 2x 总参数效率。
问题
问题背景 当前高效 scaling 研究聚焦于两种正交途径:Looped Transformer 通过参数共享增加计算深度,Mixture-of-Experts (MoE) 通过稀疏激活扩展总容量,两者被视为互补的高效 scaling 路线。
现有方法局限 现有 scaling laws 只单独建模 recurrence 或 sparsity,尚未覆盖两者的联合效应。具体表现为:
- 循环模型的有效参数增益假设与稀疏度无关,忽略了 MoE 路由对循环路径的影响;
- MoE scaling laws 假设固定稀疏激活模式,未纳入循环带来的额外计算深度;
- 缺乏联合参数化形式,无法在 compute 与 memory 约束下同时优化 recurrence 和 sparsity。 因此,设计 looped MoE 模型时只能依赖启发式搜索,难以预测最优配置。
为什么这个问题难/重要 技术上,循环次数与稀疏度存在非线性耦合:增加循环会放大路由决策的偏差,改变稀疏度又会影响每次循环的容量,两者的交互难以用简单叠加建模。同时,实际系统同时受 FLOPs 和参数存储限制,需要平衡 active parameters 与 total parameters,而现有 scaling law 无法给出联合优化指导。该问题受到业界高度关注,因为 looped MoE 在推理和训练成本上具有显著优势,但失准的预测会浪费大量算力。
行业类比 这类似于在自适应推理系统中,需要同时调节参数复用次数与专家激活比例,如同云计算中根据负载动态分配资源,没有容量预测模型就无法合理规划。
核心洞察
- 首次将循环(recurrence)与稀疏性(sparsity)纳入统一缩放定律框架,通过有界的、以稀疏性为条件的循环映射刻画循环带来的有效参数增益。该映射揭示了稀疏性如何提升循环的增益上限,使定律能同时还原标准稠密模型、MoE 及循环模型的缩放规律,且预测精度优于以往孤立建模的方法。这一联合视角突破了分别研究循环或稀疏性的局限,为量化两种效率机制的互补放大效应提供了理论基础。
- 拟合得到的 Loop Scaling Laws 不仅用于预测损失,还能直接指导资源约束下的架构设计:在给定计算或内存预算时,可解析推导最优的循环次数与稀疏度组合,例如计算最优循环(固定稀疏度)或内存最优稀疏度(固定循环),甚至联合优化。这超越了传统缩放定律仅作为事后分析或外推工具的定位,使超参数搜索具备可解释的优化目标,从根本上降低大规模模型设计的试错成本。
方法
核心方法:联合循环与稀疏性的 Scaling Law
输入:模型规模、训练数据量、循环次数、专家稀疏度(专家总数与每次激活的专家数)。
关键模块:
- 有界循环映射:针对 dense 模型,引入一个 bounded recurrence mapping,将循环次数映射为有效参数增益。该映射设计为有上界,避免循环次数无限增加时有效容量无限制增长,符合实际观察到的饱和现象。
- 稀疏条件循环映射:针对 MoE 模型,定义 sparsity-conditional 的映射,显式建模稀疏度如何提升循环带来的有效容量增益——稀疏度越高,循环能解锁的总参数量越大,增益越显著。
- 联合 scaling law 公式:将上述增益与模型规模、数据量结合,形成统一的 loss 预测函数。该函数可退化为标准 dense scaling law(无循环或循环增益为 1)和标准 MoE scaling law(无循环)。
输出:给定配置下 held-out loss 的预测值,用于指导资源约束下最优循环次数与稀疏度的选择。
与同类方法的差异:这是首个同时参数化 recurrence 与 sparsity 的 scaling law,而之前工作仅单独建模其中一维。
实验
实验设计
作者在多个模型规模、循环次数 r 和稀疏度水平上训练 looped MoE 模型,拟合 Loop Scaling Laws。下游在推理基准上评估,并设置匹配计算量的对比实验(含万亿 token 规模)。基线包括标准 dense、非循环 MoE 以及单独建模循环或稀疏的既有 scaling laws。
关键发现
- Loop Scaling Laws 对 held-out loss 的预测精度优于先前只单独建模循环或稀疏的 scaling laws,并能退化为标准 dense / MoE scaling laws。
- 稀疏性带来约 3x 活跃参数效率提升;循环在推理任务上带来约 2x 总参数效率提升;两者联合进一步推进性能前沿。
- 在匹配训练计算量下,由 scaling law 推导的 looped MoE 在推理基准上达到约 2x 参数量非循环 MoE 的水平,并支持测试时通过循环扩展。
与基线对比与工程启示
相比分别处理循环与稀疏的既有方法,Loop Scaling Laws 首次实现联合建模,为资源约束下的模型设计给出可量化的最优选择依据。工程上,若内存受限可优先提高稀疏度,若算力受限则可通过循环提升有效深度而不增加参数存储;联合优化可同时挤压两个维度的冗余。该工作把 scaling law 从拟合工具推进到实际模型配置的设计工具。
行业影响
落地场景
循环 MoE 可直接应用于大规模语言模型推理服务、长上下文处理与推理密集型 Agent。典型产品包括云端 LLM API、企业级知识助手、代码生成工具及多步推理系统。对于需在固定延迟预算下最大化性能的场景,如实时对话、搜索结果摘要,循环结构可显著提升参数利用率。
商业价值
核心收益来自降本增效:
- 降本:MoE 稀疏激活减少 FLOPs,循环提升深度而不增加参数存储,整体推理成本下降约 2-3 倍(论文揭示稀疏约 3x active-parameter 效率,循环约 2x total-parameter 效率)。
- 体验提升:test-time scaling 允许按需增加推理步数,在不重新训练的情况下提升复杂任务表现,尤其利好按 token 计费的 API 商业模式。
- 增收:同等硬件可服务更多并发请求,或更高定价的推理增强服务。
与现有工作流的接口
Loop Scaling Laws 可作为模型设计阶段的规划工具,输入目标算力与内存约束,输出最优循环次数与稀疏度组合。工程上:
- 训练侧:直接嵌入现有 MoE 训练框架(如 Megatron、DeepSpeed),无需新算子;
- 推理侧:循环层可复用既有 attention / FFN 模块,与 vLLM、TensorRT-LLM 等推理引擎兼容;
- 调优侧:拟合的 scaling law 可指导超参搜索,减少试错成本。
具体落地 use case
- 电商搜索与推荐 LLM:在商品描述生成、用户意图理解等场景,用循环 MoE 替代稠密模型,在相同推理成本下支持更长的上下文与更复杂的推理链,提升转化率。
- 金融文档分析:处理财报、合同等长文档,循环结构允许模型对关键段落多次迭代,提高信息抽取精度;MoE 稀疏性保证 p99 延迟可控,满足实时风控要求。
局限
- 论文在 **trillion-token** 规模验证了 looped MoE 的收益,但模型参数量级仍局限于中等规模(文中未明确超标度到千亿参数)。这可能导致拟合的 **Loop Scaling Laws** 在更大模型上出现系统性偏差,因为 recurrence 与 sparsity 的交互效应可能随模型容量变化。此外,下游实验主要集中在 **reasoning benchmarks**,对知识密集型、多语言或长上下文任务缺乏验证,限制了结论的普适性。
- 所提出的 **bounded, sparsity-conditional recurrence mapping** 基于若干简化假设,例如将 recurrence 的有效参数增益视为可分离的指数函数。实际 looped transformer 中的参数共享模式、expert 路由动态以及训练过程中的稳定性问题,都可能破坏这些假设。论文未讨论该 scaling law 对非均匀层循环、动态循环次数或细粒度 MoE(如 expert-choice routing)的扩展性,因此其适用范围可能较窄。
- 与已有工作对比不够充分。虽然声称优于 prior alternatives,但未与最新的 **MoE scaling laws**(如 unified scaling law for MoE)进行系统性定量比较,也未分析不同 sparsity 模式(如 fine-grained MoE vs. standard top-k)下拟合系数的稳定性。此外,论文未开源实验配置或代码(仅 arxiv preprint),降低了结果的可复现性和社区验证的可能。