我有一条流:让自监督学习在连续视频上奏效
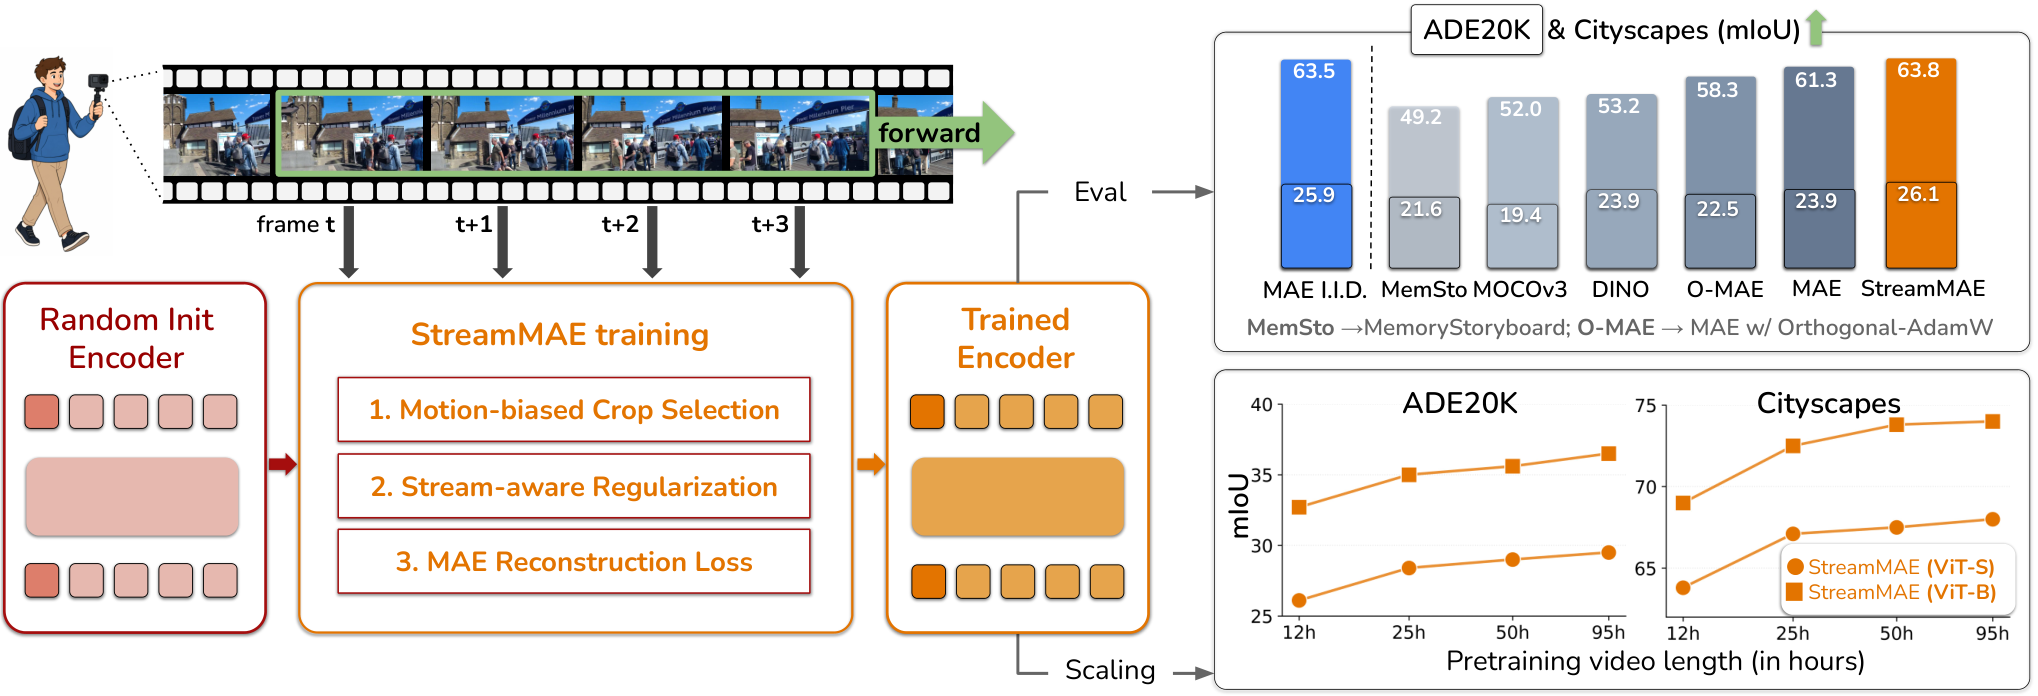
自监督学习从婴幼儿视觉发展中获得灵感,但标准训练流程与之相去甚远:图像被独立采样,并在各 epoch 间全局打乱。本文研究 连续视频流 这一设定:帧按时间顺序被消费,采用严格的 滑动窗口 batch,不做全局重排,也没有多 epoch 回放。 为此,作者构建了 WT++:一个 95 小时的都市步行导览视频数据集,用于流式预训练。结合全面的评测套件,他们发现对比学习与蒸馏类方法在该设定下表现吃力,MAE 更为稳健,但仍不及标准的 i.i.d. 预训练。分析表明,连续 batch 的滑动窗口消费所带来的 高 batch 间相似度 并不能解释这一差距;真正的挑战在于 高 batch 内相似度:每个 batch 内的帧近乎重复。 针对这一点,作者提出 StreamMAE:保留 MAE 的核心重构目标,同时改造输入管线,引入 流感知正则化 与 运动偏置的裁剪选择。实验显示: - StreamMAE 超越各类流式基线; - 追平在同一视频数据上训练的 i.i.d. MAE; - 与 ImageNet 预训练的 MAE 相比仍具竞争力; - 当预训练流从 12 小时扩展到 95 小时时,性能呈正向扩展。
论文精读
TL;DR 论文研究连续视频流上的自监督学习,发现瓶颈是滑动窗口批内近重复帧而非批间相似性;提出 StreamMAE,用流感知正则化和运动偏置裁剪,使流式预训练追平 i.i.d. MAE 并随数据量正扩展。
问题
问题背景
自监督视觉表征学习当前关注如何摆脱大规模标注数据依赖,但其标准训练流程假设数据 i.i.d. 采样与全局打乱,与真实世界连续观察存在本质差异。
现有方法局限
- 对比学习(SimCLR、MoCo)依赖跨批次负样本多样性,但流式滑动窗口内帧高度相似,导致负样本难以区分,易发生表征塌缩;
- 蒸馏方法(BYOL、DINO)通常需要全局批量统计或长期温度平均,流式场景下统计分布非平稳,动量编码器更新滞后;
- MAE 虽对噪声更鲁棒,但其随机掩码重建在近重复帧上容易退化为简单复制,且标准随机裁剪未利用运动信息,无法有效缓解批次内冗余。
为什么难/重要
连续视频流本质上是时间相关、非平稳分布的:相邻帧共享大量低级特征,但长期场景漂移(光照、视角)使得在线学习必须同时处理局部冗余和全局分布变化。工程上无法缓存全部数据做全局重排,且学习器必须在不回放历史数据的约束下逐步更新。这直接关系到自动驾驶、机器人、可穿戴设备的持续感知模型训练,业界越来越关注从数据流中在线自监督学习,而非离线预训练。
行业类比
类似自动驾驶数据闭环:车辆实时采集的视频流以时间顺序到达,模型需要在线吸收新场景,而重新训练整个模型或全局打乱数据代价过高,因此流式自监督学习成为在线更新表征的关键路径。
核心洞察
- 批内相似度是流式自监督的主要瓶颈:论文通过对比实验发现,滑动窗口导致的批间高相似度并非性能下降主因,而是单批内帧近乎重复导致模型难以学到有效表征。这一发现与以往聚焦批间去相关或经验重放的流式学习方法不同,StreamMAE 指出批内冗余才是需要优先解决的核心矛盾。
- MAE 的重建目标天然适合流式高相似输入:对比学习和蒸馏方法依赖负样本或教师模型,在批内近重复帧上易发生表征坍缩或教师退化;而 MAE 的掩码重建任务在输入高度相似时仍能提供有效学习信号。StreamMAE 进一步通过流感知正则化和运动偏置裁剪增强输入多样性,使流式 MAE 匹配 i.i.d. 性能,证明框架选择与输入管道适配同样关键。
- 长时连续视频流为自监督提供更现实的测试床:WT++ 数据集包含 95 小时城市步行视频,严格按时间顺序消费,无多 epoch 重放。与现有图像数据集或短视频剪辑不同,它反映真实智能体连续感知场景,评测结果揭示传统 SSL 方法的鲁棒性边界,为在线学习、机器人学习提供基准。
方法
StreamMAE 以连续视频流为输入,遵循严格的 滑动窗口批处理:帧按时间顺序依次进入当前批次,无全局洗牌、无跨 epoch 回放。整体流程为:
输入与批构造
- 从视频流中按时间顺序采样帧,形成批次;每个批次内的帧在时间上接近,具有高 intra-batch similarity(帧近乎重复),这是流式预训练的核心难点。
关键模块
- MAE 重建目标:沿用 Masked Autoencoder 的遮罩重建任务,对输入帧随机 mask 大部分 patch,编码器仅处理可见 patch,轻量解码器重建被遮罩的 patch,以像素级重建损失优化。
- Stream-aware regularization:针对同一批次内帧间高度相似导致梯度冗余的问题,引入流感知正则化(具体形式可能是特征去相关或批次内对比正则),鼓励编码器产出更多样化的表征,缓解冗余更新。
- Motion-biased crop selection:利用视频帧间的运动信息,优先裁剪包含运动前景或显著变化的区域,替代 MAE 中随机的裁剪策略,增加单个样本内的有效信息变化,减少静态背景的重复。
输出
- 训练完成后,编码器作为通用视觉骨干,直接用于下游分类、分割和深度估计等任务,无需再在流式数据上微调。
与同类方法的差异:现有流式自监督方法多直接套用 i.i.d. 设计的对比学习或蒸馏目标,但 StreamMAE 识别出 intra-batch similarity 为核心瓶颈,通过 流感知正则化 和 运动偏置裁剪 对输入管道和优化目标进行专门适配,使 MAE 在严格流式设置下性能接近 i.i.d. 预训练。
实验
实验设计
论文构建 WT++ 数据集(95 小时城市步行视频),设计严格流式预训练协议:按时间顺序消费帧,使用滑动窗口批次,无全局重排、无多轮重放。在流式设置下对比了对比式(如 MoCo-v3)、蒸馏式(如 DINO)和 MAE 等方法,并通过相似度分析分离批内与批间影响。提出 StreamMAE,在 MAE 重建目标基础上引入流感知正则化和运动偏置裁剪,针对高批内相似度改进输入管线。
关键发现
- 对比式和蒸馏式方法在流式预训练下性能显著下降,表明对 i.i.d. 假设敏感。
- MAE 在流式设置下较稳健,但仍低于 i.i.d. 预训练,差距主要源于高批内相似度(帧近似重复),而非批间相似度。
- StreamMAE 通过正则化与运动偏置裁剪有效缓解批内冗余,性能超过流式基线,匹配同视频数据上的 i.i.d. MAE,并与 ImageNet 预训练 MAE 竞争。
- 预训练流从 12 小时扩展到 95 小时,StreamMAE 性能正向提升,显示可扩展性。
基线对比解读
StreamMAE 的核心贡献在于识别并解决流式训练中真正的瓶颈:批内相似度。与流式 MAE 相比,它通过运动偏置裁剪选择时空上更多样的帧,降低批内冗余;流感知正则化则可能稳定优化过程。与 i.i.d. MAE 相比,StreamMAE 在相同数据上匹配性能,证明流式预训练不牺牲表示质量,关键在于输入管线适配。与 ImageNet 预训练 MAE 相比,使用城市步行视频流即可获得竞争性能,说明自然视频流包含丰富的视觉结构,可为通用表示学习提供有效信号,这对实际部署中持续学习场景具有启示意义。
行业影响
落地场景
自动驾驶 / 机器人 与 视频监控 / 内容平台 可直接受益。车辆、机器人持续产生视频流,StreamMAE 支持在线自监督预训练,无需全局打乱与多 epoch 存储。电商直播、安防摄像头等场景可边采边训,减少数据工程成本。
商业价值
- 降本: 省去全局 shuffle、多 epoch 存储和人工清洗,降低大规模视频数据的预处理开销。
- 增效: 模型在时序连续视频上预训练后,下游检测 / 分割 / 分类任务通常更具鲁棒性,减少数据标注需求。
- 体验提升: 流式训练允许模型快速适应新环境,适合隐私受限的本地部署。
接口与集成
StreamMAE 可替换现有 MAE 预训练阶段的数据加载器,仅需滑动窗口批次 + 流式正则 + 运动偏置裁剪,输出 ViT 权重不变,直接用于下游微调。可部署在边缘设备持续学习,与现有 MLOps 管道结合,无需改动模型结构。
具体 use case:自动驾驶车队采集连续视频流,用 StreamMAE 预训练 backbone,用于车道线检测与障碍物分割;电商直播平台对实时视频流进行特征学习,用于商品识别和场景理解。
局限
- - **数据集域偏差**:WT++ 数据集仅包含 95 小时城市步行视频,场景类型较为单一(街道、建筑、行人)。StreamMAE 在更自然、多样的视频流(如室内、体育、动物行为)上的泛化能力尚未验证。流式预训练对输入分布的敏感性可能高于 i.i.d. 预训练,因为连续帧的统计特性与场景切换频率强相关。论文未提供跨域迁移实验(仅在 ImageNet 上评测下游任务),因此其实用性受限于类似的城市漫游场景。
- - **对运动信息的依赖**:StreamMAE 的关键改进之一是运动偏向裁剪(motion-biased crop),依赖光流或帧间运动估计来选取信息量高的裁剪区域。这对计算开销有额外要求,且在低运动或静止摄像头场景下运动信号微弱,可能导致裁剪策略退化为随机裁剪,从而削弱流式预训练的优势。论文未系统分析运动估计失败(如快速旋转、遮挡)时的鲁棒性。
- - **未超越 i.i.d. 基线**:尽管 StreamMAE 匹配了相同视频数据上的 i.i.d. MAE,但并未明显超越标准 i.i.d. 预训练。在流式约束(无全局重排、单次通过)下,信息获取顺序固定导致的内在偏差可能仍需更根本的解决方案。论文未探讨结合重放缓冲区或课程学习等机制,未来工作需进一步缩小与离线预训练的差距。