移除时序捷径可改进非侵入式 Brain-to-Text
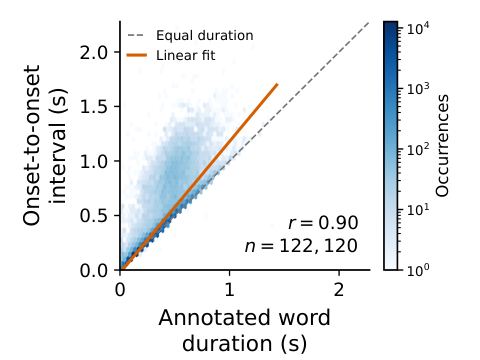
我们发现,从非侵入式脑记录中解码单词的主要改进,很大程度上无需任何脑数据即可复现。在 d'Ascoli et al. (2025) 的工作中,脑活动时间序列被切分为以每个词为起点的固定长度窗口,网络再一次性预测整句的词。相邻窗口部分重叠,隐含泄露了词间间隔;而间隔反映单词时长,不同词的时长又往往不同(the 远短于 supercalifragilisticexpialidocious),网络因此可在不依赖脑活动的情况下提升预测。该方法在 不含脑信息 的合成信号上达到 22.0% 平衡准确率,真实脑记录上为 22.3%。 为阻止网络学到这一捷径,我们做了单一而简单的改动:不再联合编码整句的所有窗口,而是各自独立处理。网络由此转而学习脑记录中的词特定信息,性能反而更好。这也让两种既有策略远比之前有效:1. 聚合同一词的多个不同神经响应的预测;2. 用预训练 LLM 作为语言先验。 在感知语音基准上,这一简单配方(SimpleB2T)在每词五次观测下取得 36.6% 词错误率,接近以往的侵入式语音解码表现(尽管条件不同)。本工作揭示了 brain-to-text 解码中的重要捷径,并表明移除它能带来简单且显著更有效的策略。
论文精读
TL;DR 发现非侵入脑到文本解码中的词持续时间泄漏捷径,可在无脑数据下复现改进;去除该捷径后,简单方法 SimpleB2T 大幅提升真实解码性能,词错误率降至 36.6%。
问题
非侵入脑到文本解码(non-invasive brain-to-text)是脑机接口(BCI)与自然语言处理交叉的前沿,目标是从 EEG/MEG 等非侵入信号重建连续语音或语言内容。
现有方法中,d'Ascoli et al. (2025) 采用联合窗口解码:将脑活动时间序列按每个词的起始点切分为固定长度窗口,相邻窗口部分重叠,再由神经网络联合预测整句词序列。这种设计隐含泄露了词间间隔,也就是词时长信息。由于不同词的时长分布差异显著(如 the 远短于长词),网络可以仅凭窗口重叠模式推断词标签,不需要真实脑活动。文章用合成信号验证:无任何神经信息的 synthetic signals 达到 22.0% balanced accuracy,仅比真实脑记录低 0.3 个百分点,说明原方法报告的性能提升主要来自该时序捷径。
这个问题之所以重要且困难,是因为它污染了基准评估,使模型学到的是时长统计而非脑-语言映射,导致后续研究可能误判进展方向。去除捷径需要将每个窗口独立处理,但这样会牺牲联合建模的上下文能力;同时非侵入信号信噪比低、词汇空间庞大,如何有效聚合同一词的多次观测、引入语言模型先验而不重新引入泄漏,是新的技术挑战。
类似语音识别中,如果模型仅靠音频时长分布就能猜出词长,即使丢弃声学特征也能得到看似合理的识别率,评估指标就会失真。
核心洞察
- 非侵入式脑机接口中,单词对齐的固定长度窗口重叠会隐式泄漏单词时长信息,使模型仅凭时长统计就能提高预测准确率,而无需依赖真实脑信号。这与以往关注信号处理或模型架构的工作不同,本研究通过构造无脑信息的合成信号对照,显式暴露了这种时间捷径,证明此前报告的性能提升主要来自数据表示层面的泄漏,而非真正的神经解码能力。该发现警示在设计解码任务时,必须审查输入表示中可能隐含的时序或标签相关信息,避免评估失真。
- 通过独立处理每个窗口这一简单修改移除时长捷径后,模型被迫学习单词特异性的神经表征,从而在真实脑信号上取得更好性能,并显著释放了多次观测聚合与 LLM 语言先验的潜力。与 baseline 方法联合编码所有窗口不同,独立处理切断了窗口之间的隐式时序关联,使模型无法利用重叠区间推断单词持续时间。这一改变不仅提升了神经解码的真实准确率,还使得聚合同一单词的多次观测和引入 LLM rescoring 带来大幅增益,表明之前这些策略的效果被捷径掩盖,真实的非侵入式语音解码在简单方法下仍有较大提升空间。
方法
输入与预处理
输入为非侵入式脑记录(如 EEG / MEG)与语音感知任务中的词对齐时间戳。每个词的神经响应被切分为固定长度窗口,窗口起点位于该词 onset。SimpleB2T 的关键改动是:每个窗口独立编码,不再像 d'Ascoli et al. (2025) 那样把句中所有窗口联合输入网络。
关键模块
- 神经编码器:轻量神经网络对单个窗口提取特征,输出词表上的概率分布。由于窗口间无重叠建模,网络无法利用相邻窗口起始点的间隔(即词时长)作为捷径,只能学习词特异的神经模式。
- 观察聚合:对同一词在多次观察(如重复呈现)下得到的预测分布进行平均或加权融合,提高信噪比。
- 语言先验重打分:将聚合后的神经概率与预训练 LLM 提供的语言模型概率结合,通过束搜索生成连贯词序列。LLM 权重可随观察次数调整。
输出
最终输出为感知语音对应的词序列或句子。在临床通信基准上,每个词 5 次观察时达到 36.6% 词错误率。
与同类方法差异:SimpleB2T 将联合编码改为逐窗口独立处理,切断了词时长泄漏,使后续聚合与 LLM 先验真正建立在神经信息之上,而不是把时序伪影当作特征。
实验
实验设计
作者复现 d'Ascoli et al. (2025) 的单词对齐解码流程:将连续语音的脑活动时间序列按每个词起始位置切分为固定长度窗口,联合编码句中所有窗口以预测全部词。相邻窗口重叠会泄露词间间隔(词时长),网络可借此作弊。作者构造不含脑信息的合成信号,发现该方法在合成信号上达到 22.0% balanced accuracy,与真实脑记录 22.3% 接近,证明性能主要来自时间泄漏。为此提出 SimpleB2T,仅将联合编码改为独立处理每个窗口,消除时长捷径;随后聚合同一词的多次观察预测,并用预训练 LLM 作为语言先验重打分。
关键发现
在感知语音基准上,SimpleB2T 在每词五次观察条件下达到 36.6% 的 WER,接近过去侵入式语音解码性能(条件不同)。去除时间捷径后,模型被迫依赖真实的词特异性脑活动,性能反而提升;聚合观察与 LLM 先验此时变得更有效。这暴露了一个隐蔽评估陷阱:重叠窗口编码无意中引入时长信息,导致模型学会“读时长”而非“读脑”。
与基线对比
d'Ascoli et al. 联合解码在真实脑数据上仅 22.3% balanced accuracy,合成信号已达 22.0%,说明提升几乎全部来自泄漏。SimpleB2T 通过独立窗口解码切断捷径,在 WER 上大幅优于基线(36.6%),且结合 LLM 先验与多次观察进一步降低错误。这证明此前方法的“改进”很大程度是伪提升,实际神经解码能力被高估;去除泄漏后,简单基线反而更有效,为非侵入式脑到文本提供了更可靠的评估方向。
行业影响
落地场景
SimpleB2T 展示的非侵入式脑到文本解码为医疗辅助沟通与下一代人机交互提供了新可能。
- 医疗辅助沟通设备:面向 ALS、脑卒中后失语等患者,基于 EEG/MEG 的实时文字输出可替代眼动仪或侵入式电极,降低使用门槛。
- 无声交互界面:AR/VR、车载系统或工业控制中,用户通过默念文本实现无手、无声输入,提升复杂环境下的交互效率。
商业价值
去除 timing shortcut 后,解码不再依赖时间泄漏,模型可从脑信号中学习真实的词级信息。
- 降本:无需侵入式手术和昂贵植入体,仅需非侵入式传感器,显著降低单用户硬件与服务成本。
- 体验提升:WER 降至 36.6%(五次观察),结合预训练 LLM 作为语言先验后进一步优化,接近早期侵入式性能,使脑到文本从实验室走向可用产品。
- 技术复用:独立的窗口编码策略与聚合观测简单易实现,减少了对复杂时序模型和超大数据集的需求,缩短研发周期。
与现有产品 / 工作流的接口
SimpleB2T 可作为现有 BCI 流水线中的解码器插件:
- 在
MNE-Python等预处理工具输出的事件相关窗口上,直接替换原联合编码模块为独立编码。 - 接入预测聚合层(多次观测投票)与开放 LLM API(如 GPT 系列)做
beam search重打分。 - 对于已有医疗沟通软件,可通过标准通信协议(如 TCP/IP 或 Lab Streaming Layer)将解码文本流送入现有 UI。
具体 use case:
- 电商 / 内容平台无障碍交互:为运动障碍用户提供脑控搜索与评论输入,减少对键盘、语音的依赖,拓展平台可访问性合规市场。
- 企业服务中的实时会议记录:多说话人场景下,结合语音识别与脑信号去抖,提升嘈杂环境中的转录准确率,尤其适合远程会议与工业现场。
局限
- 论文主要针对**单词对齐解码**场景,但实际脑-文本接口中单词边界往往未知,需要额外分割步骤。重叠窗口泄漏时间信息的假设依赖于已知起始位置,而真实系统需联合处理分割与识别,捷径可能以不同形式出现。此外,实验基于**感知语音**(受试者听语音),而临床更有价值的是**默读/想象语音**,信号统计差异可能影响结论迁移。
- SimpleB2T 在基准上 WER 36.6% 仍需**五次观测**同一单词进行聚合,依赖重复刺激,限制了实时会话场景。与侵入式方法相比,信息传输率仍然较低,距实用化距离明显。论文未评估连续长句上的累积错误,实际应用中错误可能随句子长度放大。
- 实验仅覆盖**英语**,词长与语音时长关系具有语言特异性,该捷径在不同语言(如音节计时语言)中强度可能不同。同时,数据集来自少数受试者,个体差异对结果稳健性的影响未被充分探讨。方法假设**固定长度窗口**,对其他预处理流程的泛化性尚待验证。