Mid-Harness: 在 Model 与 Harness 之间扩展动作以服务 Terminal Agents
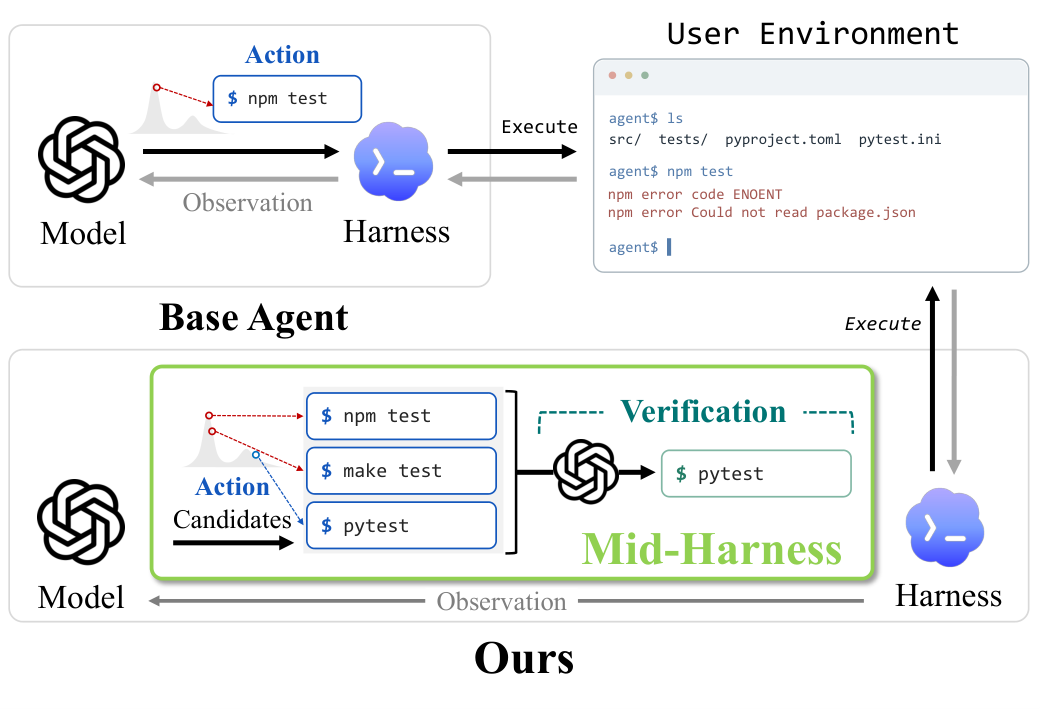
Terminal agents 依赖随机性的模型生成来行动,但能生成有用动作并不等于能可靠执行:一个糟糕的命令(如错误的 package 安装)会改变环境从而妨碍后续进展,即便模型本可给出更好的替代方案。 我们研究在 model-harness 边界分配 test-time compute 能否提升动作可靠性与轨迹成功率,以及这种分配为何有效。为此提出 Mid-Harness,在转发单个动作执行前对候选动作进行采样与验证,同时保持 generator 与 harness 不变。 使用 TMAX-9B generator 时,弱验证下增加动作采样收益甚微,而强 verifier 能从同一 generator 中挖掘出有用替代方案:在 TerminalBench-Lite 上,GPT-5.6 Sol verifier 将 Pass@1 从 base agent 的 50.00% 提至 68.03%(8 个采样动作)。当 TMAX-9B 自身充当 verifier 时,pairwise verification 在评估的机制中表现最佳。将强 verifier 的响应蒸馏回 TMAX-9B 可进一步提分,且不改变 action generator。 在 TerminalBench-Lite 上,结合 action 与 trajectory scaling 比单纯生成更多轨迹更省 token、成功率更高;Mid-Harness 在其他模型、benchmark 与 harness 上同样有效。这些发现表明 action scaling 是 terminal agents 中 test-time compute scaling 的一个有前景方向。
论文精读
TL;DR Mid-Harness 在 terminal agent 的模型与执行 harness 之间插入候选动作采样与验证,保持生成器和环境不变,用强 verifier 过滤动作,显著提升成功率(如 TerminalBench-Lite 上 Pass@1 从 50% 升至 68%)。
问题
问题背景
终端智能体(terminal agents)领域当前关注如何利用 test-time compute 提高任务成功率,常见做法如 轨迹采样(trajectory scaling)和 奖励模型(reward model)选优。
现有方法局限
- 动作执行缺乏验证:模型生成动作后直接由 harness 执行,即使有多个候选,也只选第一个可运行(first-runnable)或随机,导致错误 action 污染环境。
- 弱验证无法利用采样多样性:用同一模型或简单规则验证,采样更多 actions 收益有限;弱 verifier 无法区分有用候选,甚至可能引入噪声。
- 轨迹级缩放成本高:采样多条完整轨迹(如 best-of-N)token 开销大,且中间动作的不可逆错误会被整条轨迹继承,降低整体成功率。
为什么难 / 重要
- 终端动作具有不可逆副作用:错误安装包、修改文件系统后,环境状态无法回滚,后续动作只能基于破坏后的状态,这与文本生成中 token 级可纠正不同。
- 验证与生成的权衡:动作候选通常多样化,但有效验证需要通用能力或环境反馈,且额外验证本身消耗推理成本,如何在动作级与轨迹级分配 test-time compute 是开放问题。
- 业界关注点:Agent 可靠性 > 单点准确率,token 效率直接影响部署成本,动作级验证可能成为 test-time scaling 的新方向。
行业类比
类似 代码生成辅助工具:对模型生成的代码先做静态检查 / 单元测试再执行,避免直接运行造成 CI 环境破坏;Mid-Harness 相当于在终端 agent 里引入这一“预执行护栏”。
核心洞察
- 动作缩放(action scaling)作为 test-time compute 的新维度:在模型与 harness 之间采样多个候选动作并验证,只执行最优一个。与轨迹缩放不同,它聚焦单个动作的可靠性,避免错误命令污染环境状态。该方法不修改生成器和 harness,具有即插即用性,为终端代理的 test-time scaling 开辟了正交方向。
- 验证器质量是动作缩放有效性的前提:使用 TMAX-9B 作为弱验证器时,增加采样数量几乎无收益;而用 GPT-5.6 Sol 作为强验证器,Pass@1 从 50.00% 提升至 68.03%(8 个候选动作)。这揭示 test-time compute 在动作层级的分配必须与验证能力匹配,否则单纯增加候选只会浪费计算。
- 验证器蒸馏实现低成本动作缩放:将 GPT-5.6 Sol 的验证行为蒸馏到 TMAX-9B,并采用 pairwise verification,可在不改变动作生成器的前提下进一步提升 Pass@1。结合动作缩放与轨迹缩放,达到更高成功率且估计 token 成本更低,为生产环境部署提供了可行路径。
方法
输入与整体流程
Mid-Harness 在终端智能体的模型生成 与 harness 执行 之间插入动作验证层。其输入为当前任务状态(历史命令、环境输出、错误信息等),输出为单个经验证的动作 交给 harness 执行。流程为:
- 候选动作采样:固定生成器(如
TMAX-9B)对当前状态采样 N 个候选动作。 - 验证机制筛选:通过验证器评估候选动作,选择最可靠的一个。
- 执行与回退:若所有候选均被判为无效,则回退到第一个可运行动作,避免中断轨迹。
关键模块:验证机制
论文评估了三种验证机制:
- Listwise verification:一次性比较所有候选动作,输出相对排序或最优选择。
- Pointwise verification:对每个候选动作独立打分,取最高分。
- Pairwise verification:两两对比候选动作,按胜率或边际加权汇总,论文显示在
TMAX-9B自验证时效果最好。
此外,蒸馏 将 GPT-5.6 Sol 这类强验证器的决策行为迁移到 TMAX-9B,保持生成器不变,进一步提升 Pass@1。
工程启示
Mid-Harness 不修改生成器与 harness,以“验证即插拔”方式扩展推理时计算。其与轨迹扩展(trajectory scaling)正交:在动作粒度先筛选再执行,可比单纯并行采样多条轨迹获得更优的成本-成功率权衡。对工程实践,这意味着可以在不重新训练 agent 的情况下,通过外部强验证器直接提升现有系统稳定性;若担心验证器推理成本,可离线蒸馏到小模型,在线使用轻量验证。
与同类方法(如仅增加轨迹采样或重训练生成器)的差异在于:Mid-Harness 将测试时计算集中在模型- harness 边界的动作选择环节,解耦生成与验证,同时与现有 trajectory scaling 可叠加。
实验
实验设计:论文在终端 agent 环境中引入 Mid-Harness,在模型生成动作与 harness 执行之间插入采样-验证层,测试动作级别扩展。评估覆盖 TerminalBench-Lite、Terminal-Bench 2.1、SWE-bench Verified Mini、FeatureBench-Mini,以 Pass@1 为主要指标。基座动作生成器使用 TMAX-9B,对比无验证、listwise/pointwise/pairwise 验证机制;同时用 GPT-5.6 Sol 作为强验证器建立上界,并测试将其决策蒸馏回 TMAX-9B 的效果。
关键发现:在 TerminalBench-Lite 上,GPT-5.6 Sol 验证器在 8 个候选动作下将 Pass@1 从 50.00% 提升至 68.03%,证实动作级扩展的有效性。弱验证下增加候选数收益甚微;TMAX-9B 自身作验证器时 pairwise 验证最优。将强验证器蒸馏进 TMAX-9B 后进一步缩小差距,且无需修改动作生成器。组合动作扩展与轨迹扩展在更低估计 token 成本下达到更高成功率;方法在 4B-27B 的不同生成器、多个基准及不同 harness 上均表现一致增益。
与基线对比解读:传统 test-time scaling 主要在轨迹级采样多条完整路径,成本高且错误易累积;Mid-Harness 在单轨迹内每步采样并验证动作,将计算聚焦于高信息密度的决策点。实验说明单纯增加候选数而不提升验证能力无益,实效来自强验证器对候选动作的筛选。这一边界计算不改变 generator 即可利用其已有能力,为模块化部署提供低成本可靠性提升。不过 pairwise 验证引入较大解码开销,后续需优化验证效率或蒸馏轻量验证器。
行业影响
落地场景
Mid-Harness 主要适用于终端代理 类产品,如自动化运维、代码执行、CI/CD 自动修复、云资源管理等。在命令执行前采样多个候选动作并验证,可显著降低错误命令(如错误包安装、错误配置变更)造成的环境破坏。典型场景:云服务商提供的自动化运维助手、代码托管平台的自动修复机器人、企业内部的脚本执行代理。
商业价值
在动作生成与执行之间增加验证层,直接提升任务成功率(Pass@1 从 50% 升至 68.03%),减少因失败重试带来的 token 消耗和人工介入。结合轨迹缩放时,以更低估计 token 成本达到同等成功率,优化推理预算。对用户而言,代理可靠性提升增强信任,支撑按成功计费或 SLA 承诺。
与现有工作流集成
Mid-Harness 作为中间层,保持生成器和 harness 不变,可无缝接入 LangChain、AutoGen 等代理框架。实现方式是在 executor 前插入一个 verifier 节点:采样 N 个动作 -> 验证器选择最佳 -> 执行。验证器可外接强模型 API(如 GPT-5.6)或蒸馏到本地小模型,成本可控。
具体用例:1) 云数据库迁移代理:执行 ALTER 或数据迁移命令前采样多个候选,用 pairwise 验证避免破坏性操作;2) CI 失败自动修复:代理生成修复命令,Mid-Harness 采样并验证,选择最可能通过测试的命令,减少循环迭代。
局限
- **动作级验证的算力成本与延迟较高。** Mid-Harness 在每一步都需要从生成器采样多个候选动作,并通过验证器逐一评估;尤其是 **pairwise verification** 的 O(n²) 比较开销,论文明确指出其“增加了可观的解码成本”。对于交互式终端环境,每步额外 token 消耗与等待时间可能部分抵消减少错误命令带来的收益,在低预算或低延迟部署场景中应用受限。
- **依赖外部强验证器的性能上限。** 当使用 **TMAX-9B** 自身作为验证器时,即便最优的 pairwise verification,Pass@1 提升也有限;只有接入 **GPT-5.6 Sol** 等 frontier 验证器才带来显著增益。虽然蒸馏能缩小差距,但蒸馏后的验证器仍受限于教师模型的覆盖范围与训练数据的分布偏移,在无法访问强验证器 API 或缺少高质量验证标注时,方法效果明显下降。
- **未充分建模动作验证的长期后果。** Mid-Harness 主要基于当前状态下的动作可行性或语义正确性做选择,重点在“生成一个可执行的动作”,但没有显式评估该动作对后续轨迹状态的长期回报。某些动作短期看似合理,但会引入环境依赖冲突或锁定不利路径;验证器若只用即时标准(如是否可运行、是否符合指令)可能无法识别这类陷阱。与轨迹级 planning 或 process reward model 的联合优化仍不充分。