SpatialCORE: 大型 Vision-Language 模型中置信度感知的 grounded 空间推理
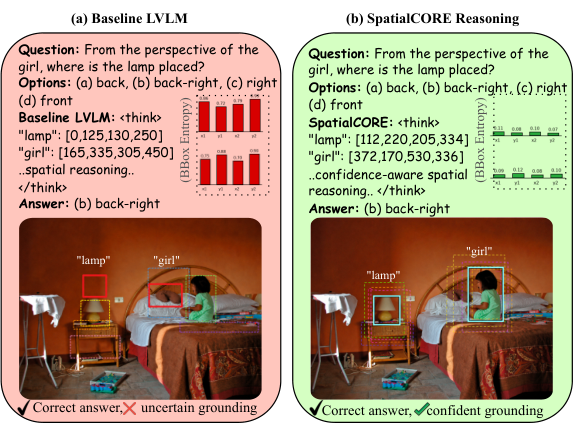
Large Vision-Language Models (LVLMs) 在视觉感知任务上进展显著,但空间推理 仍是持续短板,尤其是需要基于视觉空间进行推理的问题。近期方法引入生成式 grounding,让模型在推理轨迹中预测任务相关物体的边界框或掩码。但这类方法通常只优化最终答案正确性,即使模型并未从高置信度定位 的物体出发推理,正确答案仍会获得奖励。 为此,我们提出 SpatialCORE(Spatially COnfident REasoning),一个后训练框架,将模型对自身生成 grounding 的置信度 转化为空间推理的学习信号。其核心思想是强化既准确又置信的 grounding,鼓励模型从高置信度定位的任务相关物体出发进行推理。具体而言,SpatialCORE 通过自调节空间奖励 按每个预测边界框的坐标 token 置信度加权其匹配质量,并用答案门控 将 grounding 优化与最终答案正确性绑定。 SpatialCORE 在多个基准上取得了开源模型与专用空间推理模型中的最优结果,并能在零样本 设定下有效迁移到未见的数据分布。源代码已开源于 https://github.com/rafiibnsultan/SpatialCORE。
论文精读
TL;DR SpatialCORE 将 LVLM 对生成 grounding 的置信度转化为空间推理学习信号,通过自调节空间奖励鼓励模型基于自信且准确的定位推理,在多个基准上达到开源 SOTA 并具备零样本迁移能力。
问题
问题背景
当前 LVLMs 在视觉感知任务上表现优异,但 空间推理 (spatial reasoning) 仍是公认短板,尤其在需要理解物体间相对位置或空间关系的问题上。
现有方法局限
近期工作尝试在推理轨迹中引入 生成式 grounding,即预测任务相关物体的边界框、掩码等定位输出。然而,这些方法通常只以 最终答案正确性 作为优化目标。这带来一个关键缺陷:即使模型没有从置信度高的定位结果出发进行推理,只要最终答案碰巧正确,就会被奖励。例如,模型可能依赖语言先验或随机猜测答对,但生成的边界框却偏离目标或置信度极低。结果是 grounding 信号与答案之间缺乏强约束,模型无法学到“先自信定位、再推理”的因果链条。
为什么这个问题难/重要
空间推理的难点在于:仅靠答案正确性无法区分“grounding 正确且自信”和“grounding 错误但答案正确”这两种轨迹。需要设计更细粒度的奖励信号,将定位质量、置信度与答案正确性耦合。同时,直接优化定位置信度容易导致模型过度自信或奖励 hacking(例如输出高置信度但位置错误的框)。业界对空间推理的关注持续升温,因为 具身智能、机器人操作、AR/VR、自动驾驶 等场景都要求模型不仅能给出答案,还要提供可信的空间证据。缺乏置信度感知的 grounding 训练,模型在实际部署中难以被信任。
行业类比
类似自动驾驶的感知模块:如果检测框位置不准或置信度虚高,下游规划控制将做出危险决策;因此系统必须同时优化定位精度和置信度校准,而非只关心最终驾驶行为是否正确。
核心洞察
- SpatialCORE 将模型自身对 grounding 坐标 token 的置信度作为奖励权重,构建 confidence-aware spatial reward,打破仅用最终答案正确性监督时 grounding 优化信号缺失的困局。已有方法只奖励答案正确,即使模型未可靠定位对象也可能蒙对,导致定位质量无法提升。SpatialCORE 对每个预测 bbox 的匹配分数按其坐标 token 置信度加权,使只有准确且自信的 grounding 获得高奖励,从而显式优化定位行为。工程启示:在 RLVR 或偏好优化流程中,利用 token-level confidence 作为辅助奖励信号,无需额外标注即可提升空间推理能力。
- answer gate 机制将 grounding 优化与最终答案正确性进行条件绑定,在答案错误时仍能保留正确的 grounding 信号,避免多步推理场景下中间监督被单一标量奖励淹没。传统 RLHF 中答案错误则整条轨迹奖励趋零,抑制中间定位学习。SpatialCORE 通过 gate 设计,对错误轨迹中仍置信且正确的 bbox 给予部分奖励,鼓励模型在推理失败时也维持空间感知。这为需要中间状态监督的 VLM 任务提供了一种灵活的奖励分解思路,可推广至工具调用、导航等需逐步验证的复杂推理场景。
方法
输入与任务形式
SpatialCORE 针对需要视觉空间推理的问题,输入为图像与自然语言问题,模型需生成推理过程中对任务相关对象的定位(bounding box 或其他 grounding 输出),并给出最终答案。
关键模块
Self-Regulating Spatial Reward
对每个预测的 bounding box,计算其与 pseudo-GT 的匹配质量(如 IoU),并用该 box 对应的坐标 token 置信度进行加权。匹配质量高且置信度高的 grounding 获得更高奖励,反之则低。这样奖励信号不仅反映位置准确性,也反映模型对自身定位的确定程度。Answer Gate
将空间奖励与最终答案正确性绑定:只有当最终答案正确时,grounding 奖励才被计入;答案错误时,即便 grounding 准确也降低其贡献,防止模型学会准确但无用的定位。Adaptive Reward Composition
结合格式奖励、答案奖励和上述空间奖励,动态调整权重,保持训练稳定。格式奖励确保输出结构合法;答案奖励保障最终任务准确。Policy Optimization
在 SFT 冷启动后,使用策略优化(如 PPO)根据组合奖励更新策略,使模型生成更可能获得高奖励的推理轨迹。
输出与工程启示
模型在推理时输出带 ground truth 风格的 reasoning trace,并从中得到最终答案。对实际工程的启示:利用模型 tokens 的置信度作为额外监督信号,可以低成本提升 grounding 可靠性,无需额外标注或模型;奖励 shaping 中引入“答案 gate”可避免 reward hacking。
差异点
与仅优化最终答案正确性的现有 grounded reasoning 方法不同,SpatialCORE 显式使用 模型自身对 grounding 的置信度 作为学习信号,从而抑制低置信度但偶然正确的定位,推动模型从自信且准确的空间定位出发进行推理。
实验
实验设计
论文在 OmniSpatial 和 SpatiaLab 等 spatial reasoning benchmarks 上评估 SpatialCORE,与开源及专门的空间推理模型对比。采用 post-training 强化学习框架,利用 self-regulating spatial reward 和 answer gate 优化 grounding。具体配置见原论文。
关键发现
SpatialCORE 在多个 benchmarks 上取得 state-of-the-art 结果,尤其 zero-shot 迁移到未见数据分布有效。其核心是利用模型自身 grounding 的置信度 作为学习信号,奖励准确且置信的定位,促使模型从 confidently localized 对象推理,而非偶然正确。相比仅优化 final-answer 的方法,SpatialCORE 更关注 grounding 质量。
基线对比
现有 generated grounding 方法只优化最终答案,允许正确答案即使没有可靠 grounding 也获得奖励。SpatialCORE 通过 confidence-weighted spatial reward 和 answer gate 解决此问题:只有准确且置信的 grounding 才贡献正奖励,且 answer gate 确保 grounding 优化与最终答案正确性关联。在开源和专门模型中取得 SOTA,表明该设计有效。
行业影响
落地场景
SpatialCORE 将模型对生成 grounding 的置信度纳入奖励信号,显著提升 LVLM 在空间推理任务中的可靠性与可验证性,适用于需要精确定位与关系判断的工业场景:
- 电商视觉搜索:用户提问“货架最上层右侧的蓝色商品是什么?”模型需在图像中定位目标并给出答案,错误 grounding 会直接导致错误推荐与订单流失。
- 自动驾驶感知:理解“前方车辆与本车的相对位置”等指令,需要 bounding box 准确且模型对定位结果自信,避免误判引发安全风险。
商业价值
通过强化准确且自信的 grounding,SpatialCORE 降低错误定位带来的业务损失,并提升自动化流程的吞吐与可信度:
- 降本:在内容审核、商品标注等场景中,减少因空间误判产生的人工复核与修正成本。
- 增效:机器人抓取、AR 导航等任务中,模型自信且准确的定位可减少重试与失败,提升整体自动化效率。
- 体验提升:更精准的视觉问答增强用户信任,降低客服介入率。
与现有工作流的接口
SpatialCORE 作为后训练框架,可无缝接入现有 LVLM 训练 pipeline:
- 在 SFT 后应用 RL,将
spatial_reward与常用 RLHF 奖励(如 helpfulness、safety)组合,仅需修改奖励函数。 - 利用伪 GT(pseudo-GT)生成 grounding 标签,无需大量人工标注,降低数据成本。
- 兼容开源模型(如 Qwen-VL、LLaVA),并支持零样本迁移到新数据分布,适合快速原型验证与部署。
与仅优化最终答案正确性的方法不同,SpatialCORE 通过置信度加权奖励打破梯度无关问题,确保模型真正依赖 confident grounding 进行推理,这一特性对生产环境中的可解释性和调试尤为重要。
局限
- 依赖伪真值(pseudo-GT)的质量与可靠性。SpatialCORE 的训练信号来源于模型输出 grounding 与伪真值的匹配,并根据坐标 token 置信度加权。虽然附录中报告了对 corrupted pseudo-GT 的鲁棒性,但实际部署中伪真值往往由教师模型或检测器生成,可能存在系统性偏差或漏检,这会导致置信度加权在不准确的匹配上产生误导性奖励,尤其当错误定位的坐标 token 置信度较高时,可能会强化错误的接地模式。需要更多实验验证在复杂场景或多对象遮挡下的稳定性。
- 对模型架构和推理流程有较强假设。方法要求 LVLM 能够输出结构化 grounding(如边界框坐标)并暴露每个坐标 token 的 softmax 概率作为置信度。这对自回归解码且带有特殊坐标 token 的模型适用,但对于采用其他接地表示(如掩码、关键点)或非自回归解码的 LVLM,则需要额外适配甚至无法直接使用。此外,置信度的校准质量直接影响奖励的可靠性,而论文未讨论模型在长序列空间推理中 token 概率的校准误差。
- 计算开销与实现复杂度较高。SpatialCORE 在奖励计算中需要对每个预测框进行匹配质量评估、置信度加权,并结合 answer gate 将接地优化与最终答案正确性绑定,这比仅使用最终答案奖励的 RLHF 或 DPO 更复杂。论文未报告与 baseline 相比的额外训练时间、显存占用或推理时是否保持原有速度。对于需要快速迭代或资源受限的团队,这种复杂度可能成为采用障碍。