PixelUMM:免编码器的统一图像与视频理解与生成
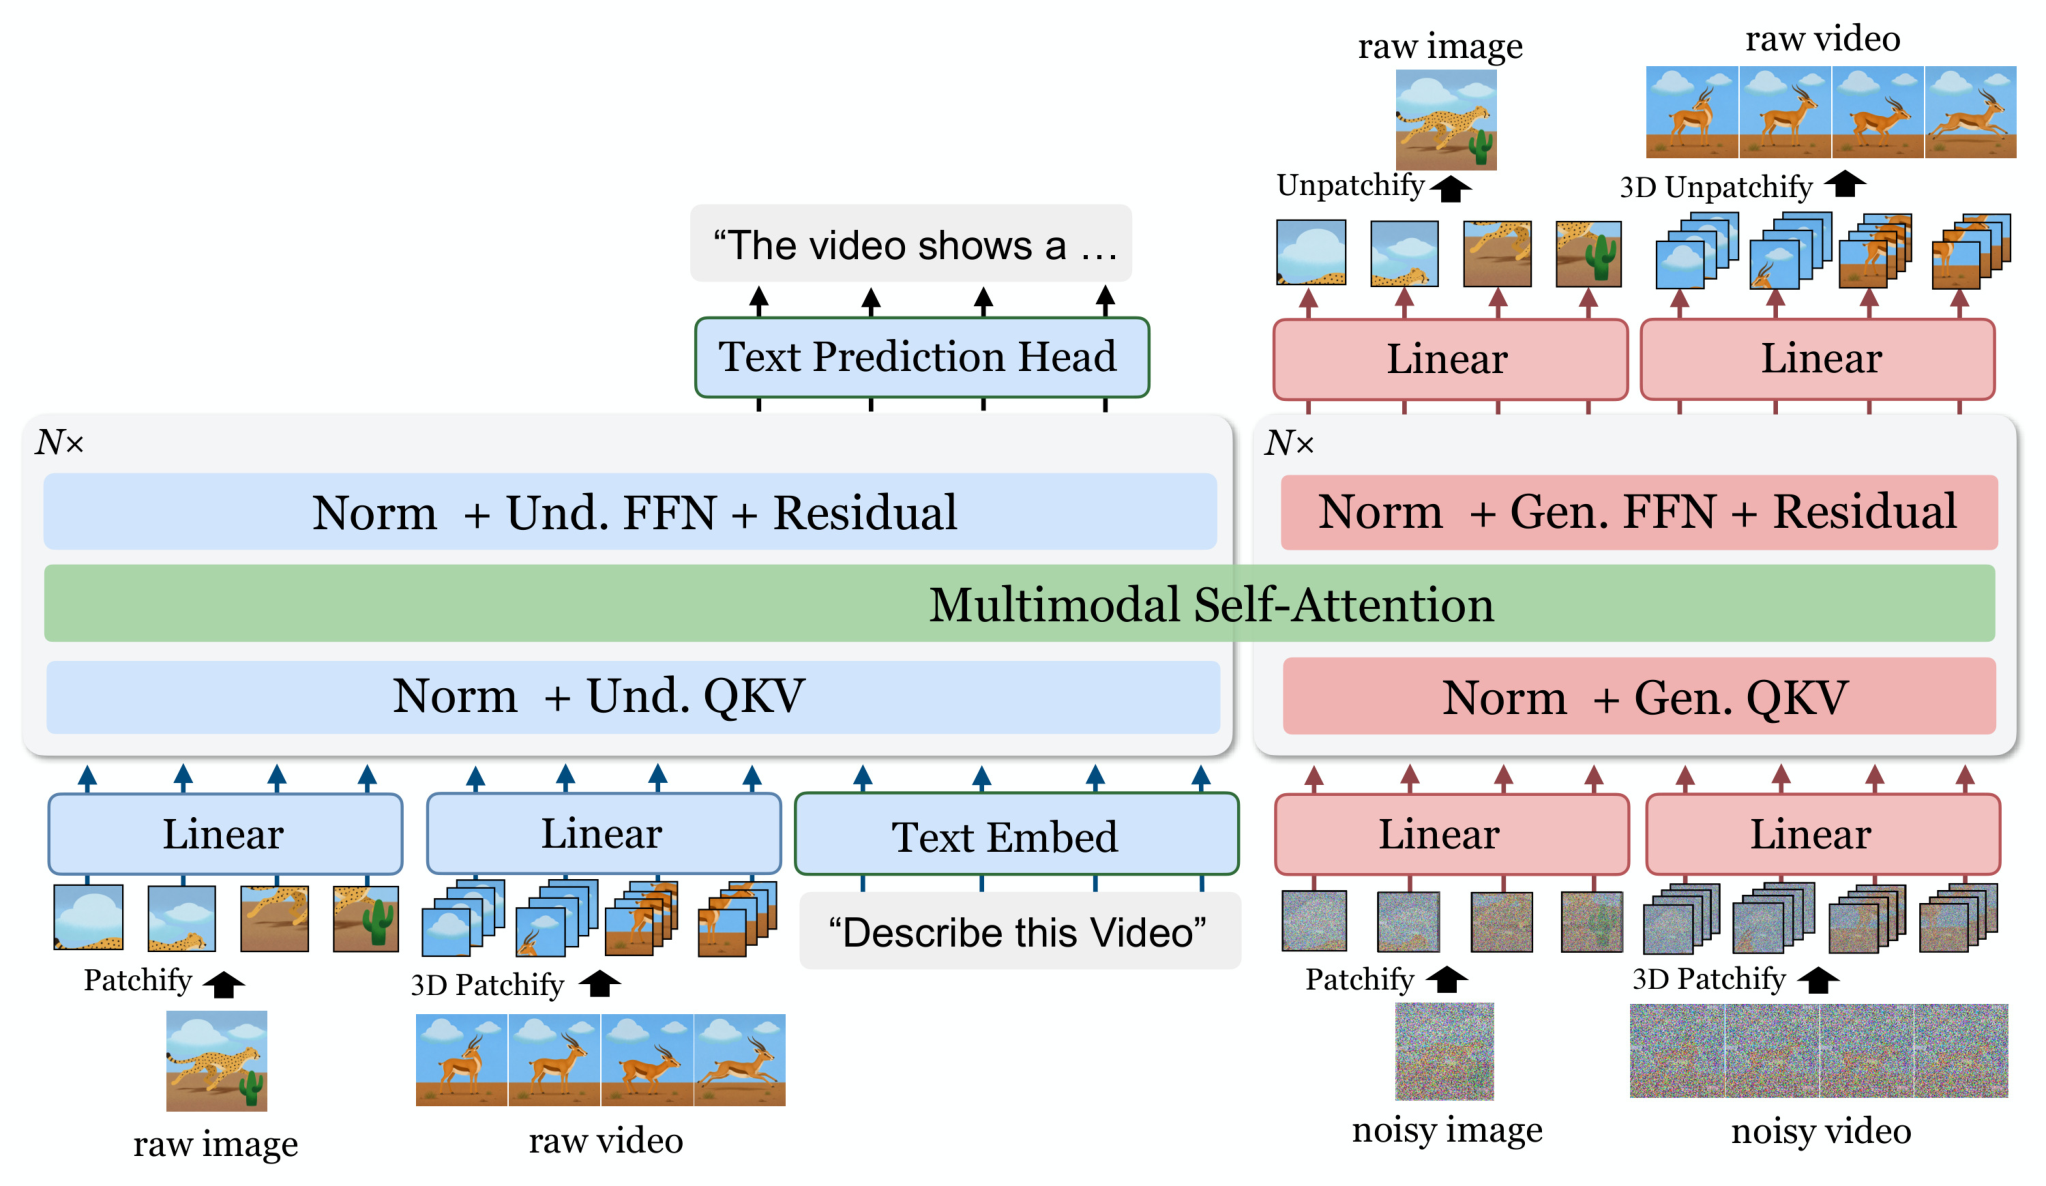
统一多模态模型(UMMs)通常为理解和生成分别使用独立的视觉表示,这会增加视觉上下文长度,并使模型难以接入已有的视觉-语言预训练流程。近期 像素空间建模 的进展提供了免编码器的替代方案,但把这一范式从图像扩展到视频并不简单:视频理解与生成采用不同的时间表示,统一的视觉接口该如何设计仍是未解之问。 为此,我们提出 PixelUMM,一个直接在像素空间中完成图像与视频理解、生成的免编码器模型。它将图像表示为空间 patch,将视频表示为时空 tubelet,通过单层线性投影把原始像素接入共享的多模态主干网络。其 Mixture-of-Transformers 架构把共享注意力与任务专属参数相结合,并将 clean-pixel 预测扩展到视频生成,同时支持自回归文本预测与像素空间 flow matching。 实验表明,PixelUMM 在图像和视频的理解与生成任务上均取得有竞争力的表现。我们还对解码器设计、时空 patch 尺寸等关键设计选择进行了实证研究,为未来像素空间的统一多模态模型提供参考。
论文精读
TL;DR PixelUMM 是无编码器的统一图像与视频理解生成模型,直接在像素空间用时空 tubelet 和 Mixture-of-Transformers 同时支持理解与生成,避免双视觉表示,并给出关键设计经验。
问题
统一多模态模型 (UMM) 旨在让单一模型同时完成视觉理解与生成,视觉表示是核心设计选择。当前主流 UMM 采用双编码器 接口:语义 ViT 用于理解,VAE 用于生成。
现有方法局限:
- 双编码器增加视觉上下文长度:需同时保留 ViT tokens 和 VAE latents,序列冗余,推理成本上升。
- 难以集成已有视觉-语言预训练管线:像 LLaVA 这类模型只接受单一视觉编码器输出,双表示需额外对齐或改造训练目标。
- 扩展到视频时,理解与生成采用不同 temporal representations:理解常用稀疏帧 + 低分辨率特征,生成则需密集时空 latent,统一接口缺失。
为什么难/重要:
- 像素空间建模可省去 VAE,但直接处理原始像素 / spatiotemporal tubelets 对计算和优化提出更高要求,训练动态不稳定。
- 视频的 patch 尺寸、解码器设计等超参高度敏感,需要大量实证研究。
- 业界对 encoder-free UMM 关注度高,但现有多限于图像;解决视频统一可显著降低视觉上下文长度与部署复杂度。
行业类比:如同摄像头模组直接输出原始 RAW 数据给单个神经网络处理,省去 ISP 和特征提取两条前置管线,降低接口延迟与系统复杂度。
核心洞察
- PixelUMM 提出 **encoder-free** 统一视觉接口,直接用单层线性投影将图像 spatial patches 和视频 spatiotemporal tubelets 映射到共享 backbone,完全消除 understanding 和 generation 之间分离的视觉编码器(如 ViT 与 VAE)。这种设计减少了视觉上下文长度,简化了模型架构,同时避免了 VAE 重建损失带来的信息瓶颈。与 BAGEL 等 dual-encoder 方法相比,PixelUMM 无需预训练语义编码器或 VAE 编码器,直接在原始像素上端到端训练,使得视觉理解和生成共享同一表征,提升了跨任务泛化能力。
- **Mixture-of-Transformers** 架构在共享 attention 参数的同时保留任务特定参数,使模型能够同时支持 autoregressive text prediction 和 pixel-space flow matching,并在视频生成中扩展 clean-pixel prediction。这种参数共享策略避免了为每个任务维护独立参数集的高昂成本,同时通过任务特定模块保留任务差异,实现了高效的多任务训练。对工程实践的启示:在统一多模态模型中,共享骨干网络与轻量任务适配层的组合是平衡性能与计算效率的有效途径,且易于扩展到新任务。
方法
方法详解
输入表示:图像被切分为空间 patches(如 16×16 像素),视频则切分为时空 tubelets(如 2×16×16),直接使用原始 RGB 像素值。每个 patch/tubelet 经过单层线性投影映射到模型隐藏维度,形成视觉 token 序列,与文本 token 序列拼接后输入统一的 Transformer 骨干。
关键模块:核心是 Mixture-of-Transformers (MoT) 架构,结合了共享的注意力层和任务特定的参数(例如理解与生成分支拥有独立的 FFN 或注意力头)。这种设计允许模型在共享视觉-语言表征的同时,针对不同任务调整计算路径。生成部分采用 像素空间流匹配(flow matching)目标,通过预测从噪声到干净像素的变换来实现图像/视频生成;文本输出则使用标准的自回归交叉熵损失。视频生成扩展了 clean-pixel prediction 到时空维度。
输出与解码:理解任务输出自回归文本;生成任务直接输出像素 patches/tubelets,可通过一个轻量解码器(如简单的线性层或转置卷积)拼接成完整图像或视频。作者还探索了不同的 decoder 设计。
与同类方法差异:相比依赖 VAE 或双编码器的统一多模态模型(如 BAGEL),PixelUMM 完全在像素空间统一视觉接口,避免了潜在空间不一致和额外编码器开销,同时验证了视频时空 patch 尺寸等设计选择。
实验
实验设计
PixelUMM 在图像与视频的理解和生成任务上进行了综合评估,覆盖图像分类/字幕、视频理解、文生图/视频等典型 benchmark。论文重点通过消融实验探索了若干关键设计选择:解码器设计、图像 patch 大小、视频时空 patch 大小、视频理解接口等,旨在验证统一像素空间表示的可行性与最优配置。模型采用 encoder-free 架构,将原始像素通过单层线性投影直接映射到共享多模态骨干网络,并利用 Mixture-of-Transformers 在共享注意力中引入任务特定参数。
关键发现
实验表明 PixelUMM 在多个任务上取得了竞争性能,证明了无需独立视觉编码器即可统一理解与生成。其核心创新在于:
- 使用空间 patch 表示图像,时空 tubelet 表示视频,统一了不同模态的视觉接口;
- clean-pixel prediction 成功扩展到视频生成,与像素空间 flow matching 相结合;
- 单层线性投影简洁地连接原始像素与 LLM 骨干,避免了传统 VAE 或 ViT 编码器带来的额外计算和表示差异。
消融研究进一步揭示 patch 尺寸、解码器类型等超参数对性能的影响,为未来像素空间 UMM 的设计提供了实证依据。
与基线对比
相较于 BAGEL 等采用双编码器接口(ViT 语义编码器 + VAE 重建潜在)的方法,PixelUMM 使用统一的像素空间表示,消除了理解与生成之间视觉特征的不一致性,并减少了视觉上下文长度。这种简化不仅降低了架构复杂度,还更好兼容现有视觉-语言预训练流程,使得模型能够直接利用海量图文/视频数据。尽管具体量化指标未在摘要中披露,但作者声称其在多个任务上达到竞争水平,暗示 encoder-free 路线在统一多模态建模中具有实际可行性。
行业影响
落地场景
PixelUMM 适用于统一多模态交互产品,如电商商品内容生成、短视频创作工具、在线教育互动课件、医疗影像辅助报告等。具体 use case:在电商场景中,商家上传产品图,模型直接生成带品牌调性的短视频广告,并同时回答用户对产品细节的问答;内容平台可为创作者提供一键式视频理解与续写功能,自动生成摘要、标签和下一帧预测。
商业价值
- 降本:无需维护 VAE 和 ViT 双编码器,减少模型参数量和训练/推理开销;像素空间直接建模省去潜在空间转换,降低延迟。
- 增收:单一模型同时赋能理解与生成,提升产品差异化;创作者工具可提高付费订阅转化。
- 体验提升:统一接口使多模态响应一致性更好,避免解码伪影。
与现有工作流集成
PixelUMM 可作为多模态 backbone 直接接入现有 LLM 服务栈。其输入输出均为序列化 token,与 Transformer 推理优化兼容。对于已有视觉编码器的系统,可替换掉预训练视觉塔,简化数据管道。支持自回归和流匹配,便于增量采用:先用于理解任务,再扩展生成。GitHub 仓库提供开源实现,便于二次开发和 benchmark。
局限
- - 像素空间直接建模虽然消除了独立视觉编码器,但图像 patches 和视频 tubelets 产生的 token 数量远高于 VAE 潜在空间或语义 token 表示,尤其对于视频,时空 tubelets 的数量随帧数、分辨率线性增长,导致计算和显存开销巨大,可能限制模型处理长视频或高分辨率内容的能力。虽然论文采用 Mixture-of-Transformers 部分缓解,但训练和推理成本仍然显著,实际部署时需要权衡 patch 大小与性能,难以兼顾效率与效果。
- - 仅使用单层线性投影将原始像素映射到共享 backbone,可能无法充分捕捉视觉语义和局部结构,尤其是对复杂场景的理解任务,与采用预训练视觉编码器(如 ViT)的方法相比,可能性能上限较低。此外,由于不依赖预训练视觉编码器,模型无法直接利用海量已有视觉-语言预训练权重,需要从零学习视觉特征,增加了数据需求和训练成本,也加大了与现有 vision-language pipeline 集成的难度。
- - 论文在多个基准上仅达到“competitive”水平,并未显著超越现有专用模型或双编码器统一模型,表明该方法在理解与生成任务的综合性能上仍有提升空间。视频生成部分基于像素空间 flow matching,相比成熟的 latent diffusion 或自回归生成,其生成质量、多样性及长视频一致性尚需更多验证;同时实验规模有限,未在大规模数据集或参数量上充分探索,结论的泛化性有待进一步加强。