软空间推理 (Soft Spatial Reasoning)
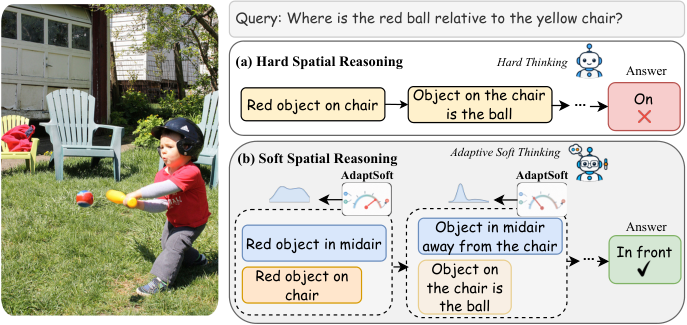
Large Vision-Language Models (LVLMs) 常通过 chain-of-thought (CoT) 完成空间推理,将中间推理编码为自回归的离散语言 token 序列。这种「硬思考」要求每一步都锁定单个 token,即使此时正确的空间解释仍不确定。这种过早的离散化(premature discretization)会让一次错误的 token 选择沿后续推理不断传播误差。 为此我们提出 Soft Spatial Reasoning,一个为 LVLMs 空间任务引入软思考的训练后框架。在每个中间推理步,LVLM 通过混合 token embedding 形成连续软状态,而非选取单个 token,使多个候选延续共同影响下一步。但合适的软度会随推理步骤变化:保留多个候选可能保住有用的空间解释,而若这些候选蕴含相互冲突的空间关系,混合反而会干扰后续推理。框架核心是 AdaptSoft,一个利用当前隐状态与预测不确定性逐步自适应调节软度的控制器。为训练 AdaptSoft,我们引入 gradient-alignment 学习目标,无需中间推理监督即可为软度控制提供步级学习信号。 在多个空间基准上,Soft Spatial Reasoning 在相同 backbone 下优于硬 CoT 与固定软度 CoT 基线,也优于多种现有 LVLMs。源码见 https://github.com/rafiibnsultan/SoftSpatialReasoning
论文精读
TL;DR 提出 Soft Spatial Reasoning,让 LVLM 在空间推理 CoT 中用连续软状态替代离散 token 选择,并通过 AdaptSoft 自适应调节 softness,避免早期离散化错误传播,超越 hard CoT 和现有 LVLM 基线。
问题
问题背景
LVLM 在空间推理任务中通常采用 链式思考 (CoT) 生成离散 token 序列,以解决视觉场景中的方向、距离、相对位置等判断。
现有方法局限
标准 硬 CoT 每一步都要从词表中选择单个 token,即使当前空间解释仍不确定。这被称为 过早离散化:一旦某个 token 选错,错误会通过自回归机制传播,后续所有推理都被迫建立在错误前提上。现有 连续 / 软思考 方法虽然保留候选 token 的 embedding 混合,但大多使用固定软度,无法根据推理步的模糊程度调整混合比例;软度过高会混合冲突的空间关系(如“左”与“右”),干扰下一步;软度过低则退化为硬 CoT,丢失备选解释。
为什么这个问题难/重要
空间推理的模糊性并非均匀分布:早期步骤可能需要保留多个方位假设,后期步骤则需要明确收敛到单一空间关系。缺少 步骤级软度控制 的模型要么鲁棒性不足,要么表达力受限。该问题直接影响视觉问答、机器人导航、自动驾驶场景理解等应用,业界对可解释且鲁棒的空间推理需求持续上升。困难在于没有中间推理步骤的显式监督,难以直接训练一个控制器判断当前步该“软”还是“硬”。
行业类比
类似自动驾驶感知模块在判断行人位置时,先并行维护多个候选边界框,再根据置信度逐步收敛到唯一轨迹,过早锁定候选框可能导致规划错误。
核心洞察
- AdaptSoft 将“软思考”的固定混合比例升级为逐步骤自适应控制。它利用当前隐藏状态与预测不确定性决定每个推理步骤混合多少个候选 token embedding,从而在保留多种空间解释与避免冲突关系干扰之间动态平衡。与固定 soft CoT 或硬 CoT 相比,这直接回应了空间推理中过早离散化导致错误传播、而过软又使矛盾空间关系混合干扰的问题。
- 用 gradient-alignment 训练软度控制器,绕过了对中间推理步骤的人工监督。AdaptSoft 不依赖标注好的 intermediate reasoning,而是让每步软度控制信号与下游策略梯度或奖励方向对齐,从而获得 step-specific 学习信号。这相比需要逐步标注或仅用最终奖励的强化学习,具备更低标注成本和更稳定的软度策略学习,使 post-training 在空间推理任务上可规模化。
方法
输入与整体流程
输入为图像与空间推理问题,LVLM 按多步 Chain-of-Thought (CoT) 生成答案。传统做法在每一步强制选择单个离散 token(hard thinking),导致过早离散化与错误传播。本方法将中间步骤替换为 Soft CoT:每一步不选单一 token,而是对候选 token 的 embedding 加权混合,形成连续 soft state,使多个候选空间解释共同影响下一步推理。
关键模块:AdaptSoft 控制器
Softness 程度不应固定:保留多候选可能保留有用解释,但若候选表达冲突空间关系,直接混合会干扰推理。因此引入 AdaptSoft 控制器,输入当前 hidden state 与预测不确定性,为每一步输出自适应的 softness 系数,控制混合的集中度。
训练与优化
训练采用 post-training 框架,分为两部分:
- LVLM 策略:使用 GRPO (Group Relative Policy Optimization) 优化,与硬 CoT 类似,以最终任务奖励为信号。
- AdaptSoft 控制器:采用 gradient-alignment learning objective,直接对齐 soft rollout 产生的梯度与硬 rollout 的梯度方向,为每个推理步骤提供局部学习信号,无需中间步骤的人工标注。
推理时,soft rollout 通过 Gumbel-reparameterized likelihood 对候选 token 的离散分布进行可微采样/近似,使整个流程可端到端训练。
与同类方法的差异
不同于固定 softness 或纯 hard CoT,本方法在每一步动态调整 softness,并通过梯度对齐直接优化控制策略,避免了手工设定 softness 或引入额外中间监督。
实验
实验设计
在 OmniSpatial、SpatiaLab、MindCube 三个空间推理基准上评估 Soft Spatial Reasoning。采用相同 backbone,对比三类基线:hard CoT、固定 soft 程度的 CoT、以及多种现有 LVLMs。训练使用 GRPO 优化 LVLM 策略,AdaptSoft 控制器通过梯度对齐目标学习逐步骤 softness,无需中间推理标签。
关键发现
- Soft Spatial Reasoning 在所有基准上均优于 hard CoT 和固定 soft CoT,且超过对比的现有 LVLMs。
- AdaptSoft 能根据当前隐藏状态与预测不确定性动态调整 softness:不确定性高时保留更多候选 token 嵌入,避免过早离散化;当候选空间关系冲突时降低 softness,防止混合干扰。
- 梯度对齐目标提供了逐步软硬程度的有效学习信号,摆脱了对中间推理监督的依赖。
与基线对比的深度解读
Hard CoT 每步强制选择单个 token,一旦早期解释错误便沿链传播;软状态则保持连续表示,允许后续步骤修正。固定 soft 方法无法区分步骤需求,可能因混合冲突候选而引入噪声。本框架的关键差异在于自适应 softness 控制:对于模糊空间场景保持多种解释,对于明确或冲突场景收敛到更确定的表示。同时,后训练方式不改变 backbone 架构,便于在现有 LVLM 上集成,为空间推理任务提供了更鲁棒的推理范式。
行业影响
落地场景
Soft Spatial Reasoning 适用于所有依赖 LVLM 进行空间关系推理的产品。典型场景包括:
- 电商视觉搜索与问答:用户上传场景图询问“左侧第二个层板上的红色手提包”,模型需要准确定位并绑定属性。
- 具身智能与自动驾驶:机器人或车辆需解析“绕过右前方的橙色锥桶”等指令,空间指代错误可能引发安全事故。
- 医学影像辅助诊断:报告生成中描述病灶位置(“右肺上叶结节”)时,空间关系错误会降低报告可信度。
商业价值
主要收益来自 准确率提升 带来的降本与体验优化。空间推理错误在 VQA 类任务中直接导致答案错误,需要人工复核或用户投诉。Soft Spatial Reasoning 在多个空间基准上优于 hard CoT 基线,可减少线上错误率;同时,AdaptSoft 按步自适应调整 softness,相比固定 soft 策略能避免冗余候选干扰,兼顾推理质量与计算效率。
与现有工作流集成
该方法作为 post-training 框架,不修改 LVLM backbone 架构,可与主流 SFT/RLHF 流程衔接。训练阶段需要实现软状态前向与 GRPO 目标,并额外训练一个轻量 AdaptSoft 控制器;推理阶段控制器依据当前隐藏状态和不确定性动态决定 softness,可封装为 Hugging Face Transformers 的自定义解码器或插件模块。工程上需要处理 token embedding 混合的显存开销,但在推理时可通过缓存或稀疏候选控制。
实际 use case 举例:电商视觉客服 中,用户上传货架照片并询问“右下角蓝色包装的饮料是什么品牌”,模型需要先正确解析空间关系再匹配属性;采用 Soft Spatial Reasoning 可降低空间定位错误率。自动驾驶数据标注质检:利用 LVLM 自动生成道路场景描述,检查“左前方车辆是否压线”等空间判断,提升标注一致性和效率。
局限
- **计算与内存开销**:Soft Spatial Reasoning 在每一步推理中混合多个候选 token 的 embedding,相比硬 CoT 需要额外存储和计算资源,尤其在长 CoT 场景下,soft state 的维度可能随候选数量增加而膨胀。论文未提供与硬 CoT 的推理延迟和显存对比,这限制了该方法在资源敏感或实时场景中的直接部署可行性。工程上需要进一步优化候选剪枝或稀疏混合策略以降低开销。
- **可解释性与调试难度**:soft state 是连续向量,无法直接映射为人类可读的中间推理步骤,这使得推理过程难以审计和调试,对于需要可验证推理的安全关键应用(如医疗、自动驾驶)存在障碍。论文没有讨论如何从 soft state 中恢复出可解释的离散推理路径,而硬 CoT 天然提供 token 级可追踪性,这一差距可能影响实际落地时的信任度。
- **泛化与超参敏感性**:实验仅在三个空间基准(OmniSpatial、SpatiaLab、MindCube)上验证,这些数据集可能偏向特定空间关系类型,模型在开放域真实图像或复杂三维空间推理上的表现尚不明确。此外,AdaptSoft 的训练依赖梯度对齐目标,候选数量、温度等超参数对最终性能的影响未做系统消融,实际部署时需要针对新任务重新调参,迁移成本较高。