利用在线蒸馏缓解 Length-Scaling Tax
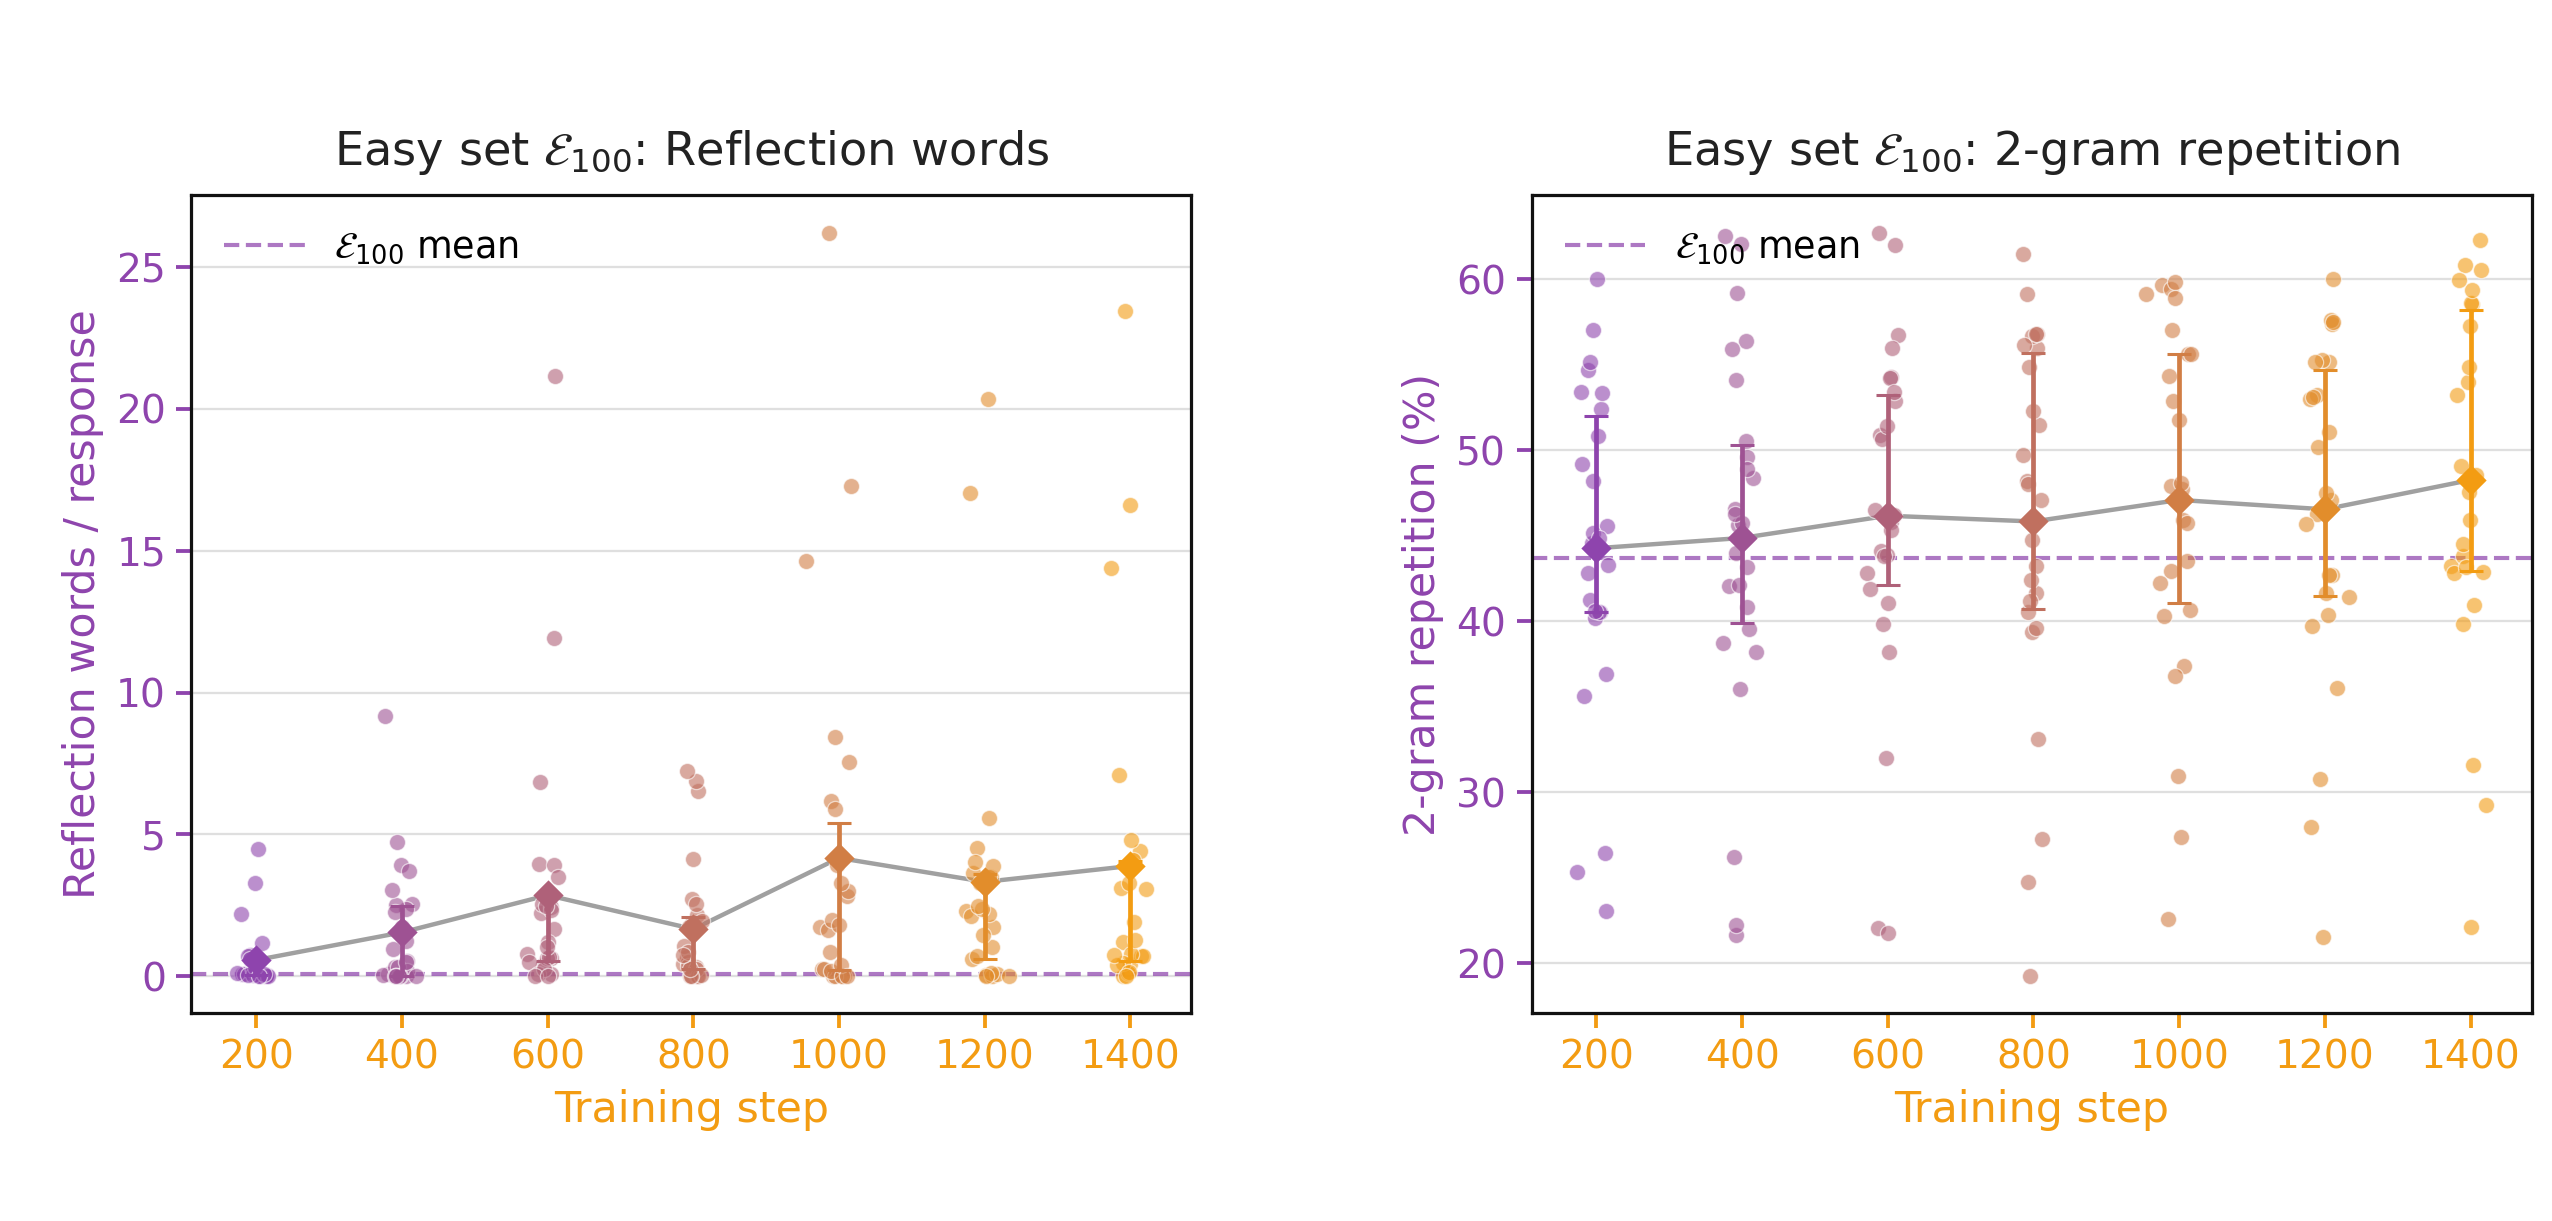
在 reinforcement-learning (RL) 后训练中,响应长度增长常被视为推理能力提升的标志,尤其在难题上;但它也可能让已经解出的问题产生不必要的冗长回答。作者将这一副作用量化为 length-scaling tax (LST):在已解查询上出现过长的响应,却没有带来与之匹配的准确率提升。 为缓解 LST,作者提出 Length Self-Distillation (LSD) 方法:将已解决的 prompt 路由到 on-policy 蒸馏,而对未解决的 prompt 保留原始 RL 目标。LSD 以在线策略的指数移动平均(EMA)作为教师模型,无需依赖任何外部模型。 实验表明,LSD 在多种变体上取得与 RL 相当甚至更好的性能,同时显著抑制简单查询上的长度增长: - 单轮推理:LST 从 19.0% 降至 -3.7% - 多轮 agentic 任务:LST 从 31.4% 降至 13.7% 这些结果说明,LSD 在 RL 后训练中既能保留简单查询上的简洁回答模式,又能支持困难查询上的高效探索。
论文精读
TL;DR 提出 Length Self-Distillation (LSD):已解决 prompt 走在线蒸馏、未解决走 RL,用 EMA 教师,使 LST 从 19% 降至 -3.7% 且保持精度。
问题
问题背景:RL post-training 的 length scaling 虽被视作推理能力提升信号,但带来 Length-Scaling Tax (LST):已解决查询上响应过度冗长,无对应精度收益。
现有方法局限:标准 RLVR(outcome-only RL)以结果正确为唯一奖励,不直接惩罚长度;在采样预算固定时,策略会偏向更长响应以提高探索覆盖率,导致长度漂移。先前缓解手段多依赖额外 KL 惩罚 或外部教师蒸馏,但 KL 约束可能同时抑制困难查询的有效探索;外部教师模型增加部署与维护成本,且离线蒸馏难以适配在线策略分布。
为什么难/重要:核心挑战在于需要在线区分查询难度,并对易/难查询施以不同目标——易查询保持简洁、难查询保留充分探索。LSD 通过路由将已解决查询送入 on-policy distillation,未解决查询保留 RL 目标;用 EMA 教师 在线蒸馏,无需外部模型。该机制需平衡路由阈值、蒸馏目标形式(如 forward/reverse KL)与 EMA 半衰期,直接关系到 LST 削减与推理性能保持。业界关注点在于降低推理 token 成本,同时不损害困难问题上的深度思考能力。
行业类比:类似在推理 API 服务中按问题难度动态分配 token 预算,避免简单查询触发过度长思考,浪费计算与延迟。
核心洞察
- LST 将 RL 后训练中的长度膨胀精确归因于已解决简单问题上的无效 token 增长。现有 RLVR 使用 outcome-only reward,只要最终答案正确,中间冗余 token 不惩罚,导致简单问题答案变长但准确率不变;LST 用 already-solved/unsolved 划分量化这一税负,发现单轮推理中 LST 达 19.0%,多轮 agentic 任务中达 31.4%。这比以往泛泛抱怨 RL 冗长更具可操作性,直接指出优化目标。
- LSD 的核心是按问题难度路由训练目标,让蒸馏与 RL 各司其职。对已解决 prompt 使用 on-policy 蒸馏向 EMA 教师收敛,保留短响应模式;对未解决 prompt 继续原始 RL 目标以探索长推理。这种路由机制跳出了“全局统一损失”的框架,避免了在简单问题上浪费 token 又能在困难问题上保持探索,与全局 KL 惩罚或离线蒸馏形成差异。
- LSD 采用在线策略的 EMA 作为自我教师,无需外部模型即可在线蒸馏。传统蒸馏依赖固定教师模型,存在 distribution shift 和额外部署成本;LSD 的 EMA 教师随策略更新,始终保持在线分布,且无外部模型依赖,实现低成本在线长度控制。此外该设计可调节 EMA half-life 控制教师滞后,平衡稳定与跟随。
方法
方法详解:Length Self-Distillation (LSD)
LSD 在 RLVR 后训练框架中引入在线路由机制,将 prompt 分为已解决与未解决两类,分别施加不同训练目标。
输入:当前在线策略对每个 prompt 的 rollout 结果,包括是否最终答对(solved/unsolved)以及生成的响应长度。
关键模块:
- 难度路由:根据 rollout 是否成功将 prompt 分为 solved 与 unsolved。已解决 prompt 通常是简单或当前策略已掌握的查询,其长度增长属于 Length-Scaling Tax (LST) 的来源;未解决 prompt 仍需通过 RL 探索更长的推理路径。
- 时间自蒸馏教师:维护在线策略的 指数移动平均 (EMA) 作为教师模型。该教师与在线策略同源,但参数更新更平滑,能保留历史简洁响应模式,无需外部模型或离线数据。
- 目标分配:对 solved prompt,使用蒸馏目标让学生策略向 EMA 教师分布对齐,抑制不必要的长度膨胀;对 unsolved prompt,保留原始 RL 目标(如基于结果的奖励优化),鼓励继续探索更长推理以获得正确解。
输出:训练后的策略模型,在困难查询上保持或提升准确率,同时在简单查询上显著缩短响应长度。
与同类方法的差异:不同于使用固定外部教师或离线蒸馏数据的方法,LSD 完全依赖在线策略自身的 EMA 作为教师,实现无需额外模型的在线蒸馏,既规避了离线数据分布偏移,又能在 RL 过程中动态适应策略变化。
实验
实验设计
实验覆盖 单轮推理 与 多轮智能体任务 两类场景,基线包括标准 RLVR 以及多种效率导向的方法。核心对比指标为长度缩放税(LST)、准确率与响应长度。
关键发现
LSD 在保持或提升准确率的同时,大幅抑制简单查询上的冗长:
- 单轮推理 LST 从 19.0% 降至 -3.7%(负值表示长度甚至低于基线)
- 多轮智能体 LST 从 31.4% 降至 13.7%
这验证了路由式蒸馏的有效性:已解决的 prompt 走 on-policy 蒸馏以保持简洁,未解决的 prompt 仍执行原始 RL 目标以促进探索。
与基线对比的深度解读
与纯 RLVR 相比,LSD 通过在线路由将长度约束施加于合适的样本,避免了全局惩罚带来的性能损失;同时使用 EMA 教师 无需外部模型,开销可控。与显式长度惩罚或 SFT 蒸馏等效率基线相比,LSD 不牺牲困难问题上的推理深度,在 LST 与准确率之间取得更优均衡。该方案对实际 RL 后训练管线友好,可直接插入现有框架。
行业影响
落地场景
- 在线推理服务:对话式 AI、代码助手、企业客服机器人,通过 LSD 抑制 easy queries 的冗长回复,降低单次请求的 token 数与延迟。
- 多轮 Agentic 任务:电商导购、金融顾问、医疗问诊等场景,保持简单问题的简洁回答,同时保留 hard queries 的深度探索能力。
商业价值
- 降本:减少 19%–31% 的 excess tokens,直接降低 API 按量计费与 GPU 推理成本。
- 体验提升:用户对常见问题获得更直接回复,减少等待与阅读负担;对复杂问题仍可享受长推理带来的准确率收益。
集成接口
- LSD 可替换现有 RLVR/PPO 训练 pipeline 的 objective:solved prompts 路由到 on-policy distillation,unsolved prompts 保留原 RL loss。
- 使用 EMA teacher 无需额外模型,可嵌入 TRL、veRL 等在线 RL 框架,仅需维护 shadow policy 与 routing logic。
- 超参数如
EMA half-life、routing threshold可作为成本/性能旋钮,无需改动推理侧模型结构。
局限
- **路由依赖准确的 solved/unsolved 判定**:LSD 的核心机制是将已解决 prompt 路由到蒸馏分支,但论文未讨论在真实推理任务中如何可靠地区分 solved 与 unsolved。在开放域生成或多轮交互中,'已解决' 的判断可能模糊(例如部分正确或需要人工反馈),这可能导致路由错误,影响蒸馏效果。论文实验使用确定性评估指标(如 exact match)判定 solved,但实际部署中这种信息往往不可得或滞后。
- **超参数敏感性与泛化风险**:LSD 引入多个关键超参数(EMA 半衰期、路由阈值、蒸馏温度等),论文通过消融展示了部分影响,但未给出跨任务的自适应策略。不同任务难度分布、模型规模或 RL 设置下,最优超参数可能显著不同。实验中仅覆盖单轮推理和多轮 agentic 两类任务,缺乏在代码生成、数学证明、长程规划等更广泛推理任务以及更大规模模型上的验证,泛化性存疑。
- **与外部蒸馏和效率基线的对比不足**:论文主要与标准 RL 基线(如 RLVR)比较,但未充分对比已有在线蒸馏方法或使用外部教师模型的蒸馏方案。此外,虽然报告了长度减少,但未直接分析在相同推理预算下的性能上限(如 pass@k 或 token 效率),也未评估减少长度是否导致某些困难问题探索不足。对 LST 的定义依赖 solved/unsolved 二元划分,可能低估了部分正确响应中的冗余。