Tacit-TTS:从自回归解码到掩码预测的高效无转写文本语音克隆
基于 自回归 语义建模的 TTS 系统在零样本语音克隆上表现强劲、表达变化丰富,但顺序解码带来显著延迟。非自回归方案生成更快,却往往依赖更严格的参考条件,例如推理时需要参考语音的转写文本。 我们提出 Tacit-TTS,一个从 IndexTTS2 蒸馏而来的高效无转写零样本语音克隆系统。模型以 掩码非自回归生成 替代自回归的文本到语义解码,引入免训练的音学长度估计,并通过 ReFlow 蒸馏加速 flow-matching 渲染器。 在两组英文和两组中文数据集上,Tacit-TTS 对 5 秒以上语句的生成速度比 IndexTTS2 快 10 倍以上,同时保持有竞争力的零样本质量。其无转写条件还支持跨语言与非词汇参考:我们用另外八种语言、婴儿咿呀声与合成乱语的参考音频验证了该能力,而依赖转写的系统在此类场景下常因 ASR 转写不可靠而退化甚至失败。
论文精读
TL;DR Tacit-TTS 将 IndexTTS2 的自回归解码替换为掩码预测,配合免训练时长估计与 ReFlow 蒸馏,实现长句 10 倍加速且质量有竞争力,并支持跨语言和非词汇参考。
问题
问题背景
当前零样本语音克隆领域,自回归语义建模系统(如 IndexTTS2)展现出强零样本克隆能力和丰富表达变化,但顺序解码带来显著延迟,难以满足实时交互需求。
现有方法局限
- 自回归系统逐 token 生成语义序列,推理速度慢;为加速而采用的非自回归替代方案(如并行解码)往往要求推理时提供参考语音的转录文本。
- 这种依赖存在两个具体问题:1) 获取参考转录需要额外 ASR 步骤,引入误差;2) 当参考语音为跨语言、婴儿咿呀声、合成无意义语音等非词汇内容时,ASR 转录不可靠甚至完全失败,导致系统性能急剧下降或无法工作。
- 因此,现有非自回归方法在提升速度的同时牺牲了参考条件的泛化性和鲁棒性。
为什么这个问题难/重要
- 核心挑战是在 非自回归解码 的并行生成范式下,保持零样本克隆的音色相似度和自然度,同时摆脱对参考转录的依赖。并行解码需要精确的长度预测,否则生成语音会截断或重复;而脱离转录意味着模型必须仅从声学信号中学习语义对齐和韵律信息。
- 业界对低延迟个性化语音生成需求强烈(如实时语音助手、配音工具),但现有方案往往在速度、质量和条件灵活性之间难以兼顾。Tacit-TTS 通过 掩码预测 和 训练无关声学长度估计 提供了一个可能的平衡点,并验证了对跨语言和非词汇参考的鲁棒性。
行业类比
类似 语音识别中的流式与非流式 的权衡:非流式模型准确但延迟高,流式模型快但牺牲一定准确率;Tacit-TTS 试图将非自回归的并行生成优势引入语音克隆,相当于在不损失太多质量的前提下,把“逐字朗读”变成“整句并行预测”,更接近实时对话场景的体验。
核心洞察
- Tacit-TTS 的核心创新在于将零样本语音克隆从自回归解码完全转换为非自回归掩码预测,同时保持 transcript-free 的参考条件。与许多非自回归 TTS 系统不同,它不要求推理时提供参考语音的转录文本,而是直接从参考音频中提取说话人身份和韵律信息。这一特性使其能够处理跨语言参考、婴儿咿呀声乃至合成乱语等非词法输入,而依赖 ASR 转录的系统在这些场景下会大幅退化甚至失败。该设计在保证生成质量的前提下,解耦了参考语音与文本对齐的约束,为实际部署中的多样化输入提供了更强的鲁棒性。
- Tacit-TTS 引入了训练无关的声学长度估计,为非自回归生成中的长度不确定性提供了实用的解决方案。传统做法通常依赖额外的长度预测模块或直接使用文本长度近似,导致模型复杂度增加或时长偏差。该方法通过融合声学音节估计和文本音节估计,在推理时动态估算目标语义 token 序列长度,无需任何训练参数。这种启发式策略不仅降低了系统复杂度,还避免了因长度预测误差累积而引发的韵律失真,是面向工程部署的效率与稳定性平衡设计。
方法
输入与整体流程
Tacit-TTS 接收 目标文本、参考语音波形(无需参考转录)以及可选的情感/说话人嵌入,直接输出克隆目标音色的语音波形。系统由两个级联模块组成:text-to-semantic generator 和 semantic-to-audio renderer。
关键模块
1. Text-to-Semantic Generator(非自回归 masked 生成)
- 用 masked non-autoregressive 替代 IndexTTS2 的自回归逐 token 解码。
- 输入文本 token 序列和参考语音的 semantic tokens(由冻结的 semantic encoder 提取)。
- 训练时对部分 semantic tokens 加 mask,模型并行预测被 mask 的位置;使用 masked-prediction loss 优化重构。
- 额外引入 residual-recovery loss,先对部分位置加 mask 生成初始预测,再对残差进行二次修正,以对齐教师模型 IndexTTS2 的语义建模分布。
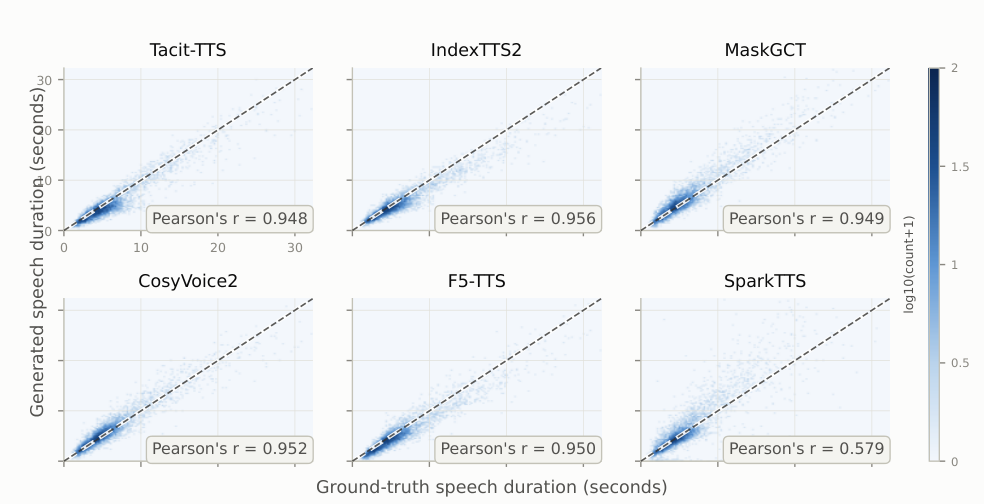
- 为控制输出时长,提出 training-free length estimation:利用参考音频的声学特征估计 acoustic syllable count,结合输入文本的 textual syllable count,直接设定生成序列长度,无需额外长度预测器。
2. Semantic-to-Audio Renderer(ReFlow 蒸馏的 flow-matching)
- 采用 flow-matching 从 semantic tokens 重建高保真 mel 频谱,再经声码器合成波形。
- 通过 ReFlow distillation 将多步常微分方程采样压缩至少量推理步数,显著降低延迟。
输出
最终输出与参考音色一致的语音波形,支持 跨语言参考 和 非词汇参考(如婴儿咿呀声、合成乱语),因为不依赖 ASR 转录。
与同类非自回归 TTS 的差异:Tacit-TTS 在保持非自回归并行解码的同时消除了推理时对参考转录的依赖,且长度估计无需训练。
实验
实验设计
论文在两个英语数据集和两个普通话数据集上评估零样本语音克隆质量与生成效率,同时设置跨语言参考(八种语言)和非词汇参考(婴儿咿呀声、合成乱语)测试,以验证 transcript-free 条件化的鲁棒性。基线包括自回归模型 IndexTTS2 及依赖参考转录的非自回归系统。
关键发现
- Tacit-TTS 在长于 5 秒的语音上生成速度比 IndexTTS2 快 10 倍以上,同时保持有竞争力的零样本质量。
- 免转录条件化使其在跨语言和非词汇参考场景下稳定工作,而依赖 ASR 转录的系统在这些情况下性能下降或失败。
对比解读
与典型非自回归替代方案不同,Tacit-TTS 不要求推理时提供参考语音的转录,消除了对 ASR 的依赖,简化了部署流水线并避免错误传播。其通过掩码预测 + ReFlow 蒸馏的路径,从自回归教师模型高效迁移能力,为低延迟语音克隆提供了工程参考。
行业影响
落地场景
Tacit-TTS 适用于需要低延迟、零样本语音克隆的产品线:实时语音助手、AI 虚拟人、有声内容生成、多语言配音工具、游戏 NPC 语音合成。尤其适合参考音频无可靠转写文本的场景,例如用户上传的短视频原声、方言片段、婴儿发声或合成音效作为音色参考。
商业价值
- 降本:非自回归掩码解码取代逐 token 自回归生成,推理延迟降低 10× 以上,同等 GPU 资源下吞吐量大幅提升,降低云端 TTS 单位成本。
- 体验提升:无需 ASR 转写参考音频,流程更短、失败点更少;支持跨语言和非词法参考,用户只需提供任意音频即可克隆音色,扩大可服务人群。
- 增收:更快的合成速度可支撑实时交互场景,如直播配音、AI 客服,为按调用量付费的 API 产品带来更高并发容量。
与现有产品/工作流的接口
Tacit-TTS 可作为 IndexTTS2 或同类自回归语义 TTS 的加速替换组件,保持语义 token 接口不变,只需将 text-to-semantic 模块替换为掩码预测器,并接入现有 flow-matching renderer。其 training-free 声学长度估计 允许直接对目标语音时长进行控制,无需额外训练。集成方式:
- 保留现有 speaker embedding / emotion conditioning 编码器;
- 将 AR 解码器切换为 Tacit-TTS 的掩码非自回归生成器;
- 用 ReFlow 蒸馏后的 renderer 替换原 flow-matching 模块,降低采样步数。
具体落地 Use Case
- 电商直播实时配音:主播或商家上传一段任意语音作为参考,系统实时生成同音色商品介绍,无需等待 ASR 转写,延迟低至可直播流式输出。
- 无障碍辅助语音生成:用婴儿发声、合成 gibberish 等非词法参考进行个性化音色克隆,为言语障碍用户定制辅助沟通设备的声音身份,解决传统系统依赖文本转写导致不可用的问题。
局限
- - **依赖教师模型上限**:Tacit-TTS 通过蒸馏 IndexTTS2 获得能力,其生成质量上限受限于教师模型。若教师在某些发音、韵律或情感表达上存在缺陷,学生模型无法超越。此外,蒸馏过程需要教师模型生成大量语义 token 作为训练目标,训练成本较高,且新数据或新语言扩展需重训教师或重新蒸馏,灵活性不足。
- - **非自回归生成局限**:masked prediction 虽大幅加速,但可能牺牲长距离韵律一致性,尤其在复杂情感或强调表达时,非自回归生成容易出现重复、停顿异常或语调单调。论文未提供与自回归教师在大规模主观听感测试上的详细差异分析,仅报告 competitive zero-shot quality,可能掩盖局部质量的下降。
- - **训练时长估计不精确**:training-free acoustic length estimation 基于音节统计或声学特征,对不同语种、语速或特殊发音(如非词汇 reference)的鲁棒性未充分验证。论文在非词汇参考上的评估主要依赖 ASR 转录不可靠的场景,但未量化 Tacit-TTS 自身时长估计错误率及其对合成语音自然度的影响,实际部署中可能需要额外校准或回退机制。