基于 Prompt Disagreement 的 Preference-Guided Adaptation 实现 Open-Vocabulary Semantic Segmentation
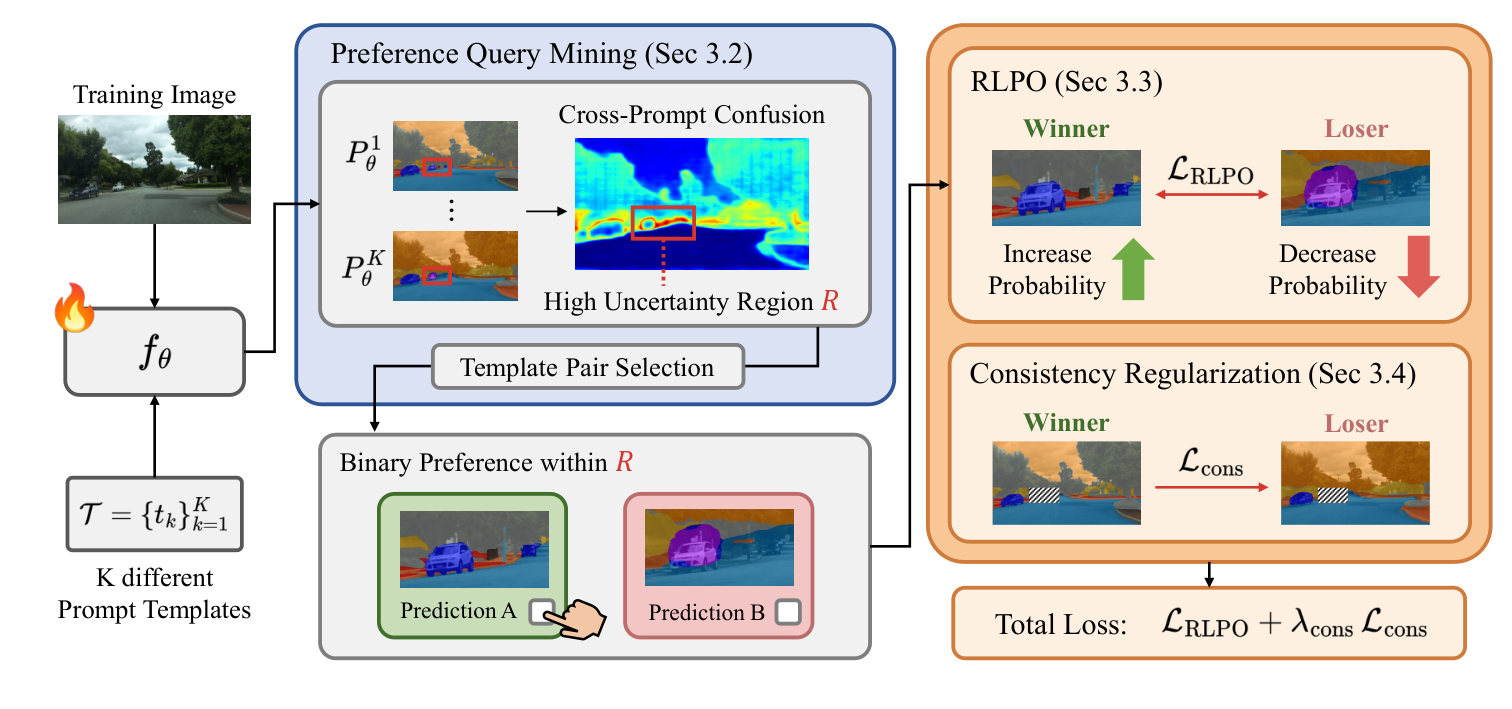
Open-vocabulary semantic segmentation(OVSS)能够在任意文本指定的词表上做像素级预测,并在常见 benchmark 上展现出良好的泛化能力。但在医学影像、遥感、工业质检等专业领域中,其性能往往明显退化,而这些领域获取稠密像素级 mask 成本高昂,且依赖领域专业知识。 为此,本文提出 preference-guided adaptation 框架,用二元偏好取代稠密 mask 监督。作者观察到,不同 prompt template 会对同一图像产生系统性的不同分割结果,并将这一现象称为 prompt disagreement,进而把它转化为一种内置的偏好监督来源。基于此,方法从跨模板不确定性高的区域中挖掘局部化偏好查询,并通过 Region-Localized Preference Optimization(RLPO)适配 OVSS 模型,同时引入一致性正则化,以稳定查询区域之外的更新。 在 MESS benchmark 上的大量实验表明,该方法在多种 OVSS backbone 上均取得一致提升,且无需任何像素级标注,在偏好存在噪声时依然有效。代码已开源于 https://github.com/blue-531/pref-ovss。
论文精读
TL;DR 利用不同 prompt 模板在同一图像上的分割分歧作为免费偏好监督,无需任何像素级标注,通过区域局部偏好优化(RLPO)适配开放词汇分割模型,在专业领域取得稳定提升。
问题
问题背景
开放词汇语义分割(OVSS)是视觉感知的前沿方向,目标是对任意文本描述进行像素级分类,在通用基准上表现优异。然而,当模型被部署到医学影像、遥感、工业检测等专业领域时,性能往往大幅下降,领域适应成为关键瓶颈。
现有方法局限
主流适应方法依赖密集像素级掩码监督,例如全量微调或 adapter 调优。但在专业领域中,逐像素标注成本极高且需要领域专家,导致标注数据稀缺。一些工作尝试使用伪标签或弱监督,但伪标签噪声大,容易造成确认偏误;无监督域适应又难以处理开放词汇的语义对齐。此外,OVSS 模型对提示模板(prompt template) 高度敏感,同一目标在不同模板下分割结果不一致,这种不一致通常被视为噪声而未被利用。
为什么这个问题难/重要
- 技术挑战:如何在没有像素级标注的条件下,从模型自身预测中提取可靠监督信号?偏好优化(如 DPO)在 LLM 对齐中有效,但分割输出是结构化像素图,定义“偏好”和局部奖励困难。
- 业界关注度:专业领域 OVSS 是自动驾驶、医疗 AI、工业质检等场景的迫切需求,减少标注依赖直接降低落地成本。利用模型内生的prompt disagreement 作为免费偏好信号,避免了额外标注,具有实际工程价值。
行业类比
类似 LLM 中用人类偏好数据替代稠密监督进行 RLHF 对齐,本工作探索用模型自身跨模板不一致性作为偏好信号,实现低成本的视觉分割领域适应。
核心洞察
- 将不同 prompt 模板产生的分割差异(prompt disagreement)视为免费偏好信号,无需像素级标注即可进行 OVSS 域适配。不同于依赖昂贵掩码的域适应方法,该方法挖掘模型自身跨模板不一致性作为监督,通过成对偏好比较间接优化分割质量,降低了对专家标注的依赖,特别适合医学、遥感等专业领域。
- 提出 Region-Localized Preference Optimization (RLPO),只在高不确定性区域进行偏好优化,并配合一致性正则化防止模型漂移。与直接应用 DPO 到整图不同,RLPO 将偏好损失限制在局部查询区域,保留其他区域稳定,同时利用跨模板 Bradley-Terry 比较来处理密集预测中的偏好建模,实现更精细、鲁棒的适配。
方法
输入与预处理
对于目标域图像,使用多个 提示模板(如 a photo of a {class})通过 OVSS 模型生成初步分割图。由于模板不同,同一图像会产生不一致的预测,称为 提示分歧(prompt disagreement)。选取跨模板预测差异大的局部区域作为候选查询区域。
偏好查询挖掘(Preference Query Mining)
在候选区域内,根据各模板的预测置信度或一致性,构造二元偏好对:将某个模板产生的分割视为“偏好”样本,另一个模板视为“非偏好”样本。偏好标签无需人工标注,完全由模板分歧自动生成。
Region-Localized Preference Optimization(RLPO)
对每个偏好查询区域,计算 区域级分数(region-level score),例如区域内像素与文本类别的平均相似度。RLPO 损失鼓励模型增加偏好模板对应的区域分数,降低非偏好模板的区域分数,形式类似 直接偏好优化(DPO)但作用在局部区域。
一致性正则化(Consistency Regularization)
为保持模型在查询区域外的预测稳定,加入一致性正则化项,约束非查询区域的输出与原始模型保持一致,避免在适应过程中性能退化。
输出
最终得到适应目标域的 OVSS 模型,可对任意文本类别进行像素级分割,无需任何像素级掩码。
与同类方法差异:该方法不依赖密集像素掩码,而是利用模型自身的 提示分歧 作为免费偏好监督信号,并结合区域局部优化和一致性约束,在无标注条件下实现有效域适应。
实验
实验设计
作者在 MESS 基准上评估了所提出的偏好引导适配框架,覆盖多个专门领域数据集(如医学影像、遥感、工业检测)。实验使用多种 OVSS 骨干模型(如基于 CLIP 的架构),并与需要像素级掩码的域适配方法、无监督/弱监督方法以及仅使用原始 OVSS 的基线进行对比。偏好监督通过 prompt disagreement 自动生成,无需人工标注。还进行了消融实验(候选生成策略、损失组件、训练图像数量)和鲁棒性分析(噪声偏好)。
关键发现
- 提出的 RLPO 结合一致性正则化,在无任何像素级标注的情况下,为所有测试骨干带来了持续一致的性能提升。
- prompt disagreement 可以有效替代人工偏好标注,其定位的偏好查询集中在高跨模板不确定性区域。
- 方法对噪声偏好具有鲁棒性,即使偏好标注有一定比例错误,性能下降有限。
- 消融实验表明:候选生成策略和两类损失组件均对最终效果有贡献;使用少量训练图像即可获得大部分增益。
与基线对比的深度解读
与依赖密集掩码的域适配方法相比,本方法完全消除了标注成本,同时达到可比的性能,显著降低了部署门槛。与已有无监督或弱监督方法相比,核心差异在于利用了 OVSS 模型自身的模板敏感特性——不同 prompt 模板会产生系统性分割分歧,将其转化为偏好信号,避免了复杂的伪标签迭代或额外辅助网络。这种 “分歧即监督” 的思路为缺少标注的专门领域 OVSS 适配提供了一种轻量、可扩展的工程路径。其训练开销主要体现在偏好查询挖掘和局部优化,论文附录中的效率分析表明可训练参数量和适配成本均保持较低水平。
行业影响
落地场景
该方法适用于开放词汇语义分割(OVSS) 的领域适配,尤其适合标注成本高、需领域专业知识的场景:
- 电商商品图处理:自动分割商品主体(服装、家具、3C 配件),无需逐像素标注即可适配新品类,实现背景替换、智能抠图。
- 医疗影像分析:病理切片或 MRI 病灶分割,医生仅需对同一图像的不同模板输出做二元偏好选择,大幅降低标注门槛。
- 遥感地物分类:针对新卫星传感器或新地理区域,利用少量偏好查询快速微调模型,避免大量像素级标注。
- 工业质检:缺陷区域分割,质检员通过比较不同模板输出提供反馈,即可完成模型适配。
商业价值
- 降本:用二元偏好反馈替代密集 mask 标注,标注成本降低一个数量级,尤其适合需要领域专家的场景(如医疗、遥感)。
- 增效:模型在新领域上线周期从周级缩短到天级,大幅提升迭代速度。
- 体验提升:可嵌入产品形成“用户反馈优化”闭环,持续提升分割精度,增强用户粘性。
与现有产品/工作流的接口
- 该方法以轻量 adapter 形式插入现有 OVSS 模型(如 CAT-Seg、OVSeg),训练时仅更新 adapter,主干冻结,部署资源开销小。
- 偏好查询可通过众包平台或专家标注接口收集,与现有 active learning 管道无缝结合。
- 开源代码(GitHub)可直接集成到 MLOps 管道,作为领域自适应模块,适用于已有分割服务但需快速扩展新领域的团队。
局限
- **Prompt Disagreement** 的质量高度依赖于模板集合的多样性与设计。方法将不同 prompt 模板产生的分割差异作为偏好信号,但若模板集合缺乏足够的语义覆盖或存在系统性偏差,可能导致偏好信号稀疏或误导,尤其在基础模型对某些类别本身置信度很低时,跨模板不确定性不足以反映真实错误。论文未系统分析模板数量、设计原则对性能的影响,也未讨论模板数量增加带来的计算开销与收益权衡,这限制了方法在资源受限或模板设计困难场景下的实用性。
- **偏好 oracle** 的构建依赖启发式规则(如模板投票或 CLIP score),虽然作者验证了其与人类偏好的一致性,但该验证可能集中于 near-tie queries(论文中提及噪声集中于此),真实用户偏好噪声往往更复杂且非均匀。此外,偏好信号本质上仍是模型自身的预测(自监督),缺乏外部真实标签校准,在极端域偏移或类别混淆严重时,可能产生错误偏好并导致负迁移。方法对完全错误偏好的鲁棒性尚未充分论证,可能影响其在高度不可靠场景中的应用。
- 实验范围主要限于 **MESS benchmark**,覆盖医疗、遥感、工业等专门领域,但这些数据集仍属自然图像或类似模态,尚未在更极端的域(如病理切片、雷达图像、3D 点云)上验证。方法需要为每个新域构建合适的 prompt 模板集合,这仍然依赖一定的人工设计,限制了全自动适应的扩展性。与现有的无监督域适应或测试时适应方法相比,论文未直接对比,不清楚在更一般设置下的相对优势,因此其泛化边界仍需进一步探索。