几何作为地址:为长时程相机控制视频生成将注意力路由至视觉记忆
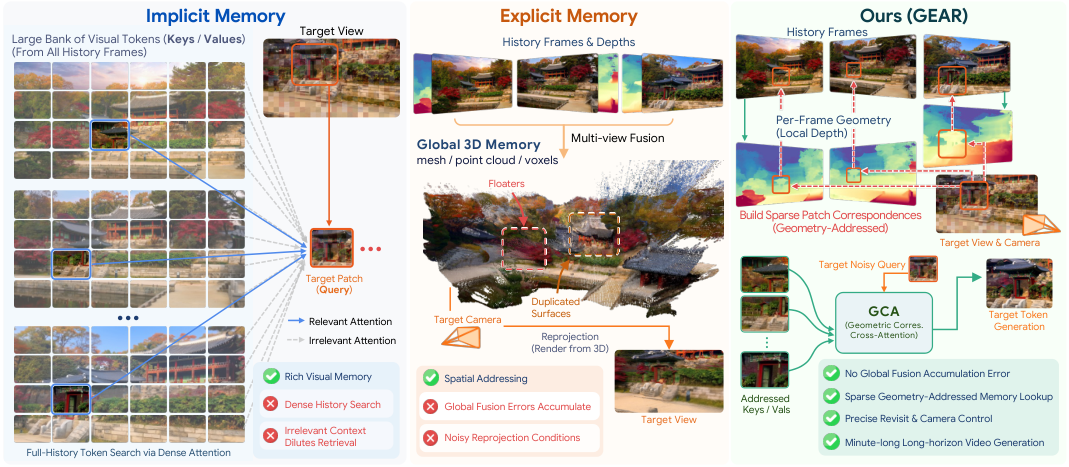
长时程相机控制视频生成 需要从不断增长的视觉历史中恢复此前观测到的内容。现有方法要么隐式搜索历史上下文,要么将其重建为持久化的 3D 记忆,因而面临记忆访问低效或几何误差累积的问题。 我们的核心洞见是:几何无需解释场景,它只需决定视觉记忆应当从何处读取,而由注意力决定应当恢复什么。基于此,我们提出 GEAR,一个 Geometry-Enabled Attention Routing 框架,将几何用作视觉记忆的显式 token 级地址。GEAR 不把历史观测融合为持久化的全局 3D 表示,而是将其保留为 frame latents,仅用逐帧几何建立与目标视角的 token 级对应关系,从而避免全局融合带来的持续误差累积。 在这些对应关系的引导下,Geometric Correspondence Attention(GCA) 在去噪过程中选择性地将几何匹配的历史特征注入带噪的目标 patch。我们进一步引入 Invisible Octree 来累积可见性证据,拒绝几何上合理但实际被遮挡的对应关系。 大量实验表明,GEAR 达到了当前最优的视觉质量、精确的相机控制与重访一致性,可沿挑战性轨迹生成分钟级长视频。
论文精读
TL;DR GEAR 让几何只充当视觉记忆的寻址地址,通过注意力按 token 级对应关系路由历史特征,显著提升长时相机控制视频生成的连贯性与一致性,避免全局 3D 融合的累积误差。
问题
问题背景
长时程相机控制视频生成需要模型在生成新帧时,能够从持续增长的视觉历史中恢复先前观察到的内容,以保证视角回访时的一致性。
现有方法局限
- 隐式历史搜索:利用注意力机制在历史帧中隐式检索相似特征,但随历史长度增加,内存访问复杂度显著上升,且缺乏显式几何约束,容易检索到空间上不相关的 token,导致生成内容漂移。
- 持久 3D 记忆重建:将历史观测融合为全局 3D 表示(如 NeRF 或 3D Gaussian),虽提供显式几何,但全局融合会累积每帧重建误差,尤其在长轨迹下误差不可逆地放大;同时更新全局模型代价高,难以适应动态场景或遮挡。
技术难点与重要性
难点在于 重访一致性:当相机重新回到之前经过的区域,模型必须稳定恢复相同场景内容,否则会出现纹理突变或结构错乱。这要求记忆访问既高效又空间精确。此外,任意相机轨迹引入大量遮挡和视角变化,单纯依赖 3D 重建会因深度估计不准确而失败,而单纯依赖注意力则无法保证空间对应。业界对分钟级可控视频生成需求强烈,覆盖自动驾驶仿真、AR/VR 内容创作、电影预演等应用,但现有方案在效率和精度上均未达标。
行业类比
类似 RAG 系统 用索引地址快速定位外部知识库,几何在此扮演“地址”角色,注意力则负责“读取内容”,二者解耦使得视觉记忆访问可扩展且鲁棒。
核心洞察
- **几何作为地址而非场景解释**。传统方法要么隐式搜索历史上下文,要么将观察融合为持久全局 3D 表示;前者内存访问效率低,后者几何误差会累积并损害生成质量。GEAR 的关键洞察是几何只需决定从何处读取视觉记忆,由注意力决定恢复什么内容。这一解耦将几何精度要求从“场景重建级”降低到“对应关系级”,允许历史观察保留为帧级 latent,仅用每帧几何建立 token 级对应,避免了全局融合的误差累积,同时保证高效的内存访问。
- **显式几何对应注意力与可见性过滤**。GEAR 使用 **Geometric Correspondence Attention (GCA)** 根据几何引导的 token 级对应,将历史帧特征选择性注入当前去噪 patch。相比隐式搜索或稠密历史注意力,稀疏对应注意力显著降低计算量;同时引入 **Invisible Octree** 累积可见性证据,拒绝几何上看似合理但被遮挡的对应,提升记忆注入准确性。该设计使得长时程生成中历史信息的复用更加鲁棒,支持分钟级视频生成,并配合退化历史增强训练进一步提高对历史质量变化的容忍度。
方法
方法概述
GEAR 将历史视觉记忆组织为逐帧潜在表示(frame latents),并以逐 token 的几何地址引导注意力路由:输入包括当前目标视角的噪声 patch、历史帧 latent 及对应相机几何。
关键模块
Geometry-Addressed Patch Memory
对每个历史帧,通过深度反投影与网格连接建立局部几何锚点,再借助目标帧与历史帧的相机位姿将锚点投影到目标视图,形成 token 级对应关系;同时维护多源 patch 对应缓存,加速检索。Visibility-Aware Correspondence
通过不可见八叉树 Invisible Octree累积可见性证据,判断哪些几何对应在当前目标视角下被遮挡,提前剔除不可靠对应。Geometric Correspondence Attention (GCA)
在去噪过程中,GCA 以稀疏对应注意力方式,仅从几何匹配的历史 token 中读取特征,再通过轻量残差注入将历史特征融合到目标 patch 的中间表示。几何只决定“在哪里读”,注意力权重决定“恢复什么”。训练与推理
训练时引入历史退化增强提升鲁棒性;长时推理采用关键帧历史检索与流式记忆更新,避免内存无界增长。
与隐式注意力搜索或全局 3D 融合不同,GEAR 不将历史压缩为持久全局表示,而是保留离散帧 latent,仅用几何建立 token 级地址,从而规避全局融合带来的累积几何误差。
实验
实验设计
论文构建了一个面向长时相机控制视频生成的评测框架,重点考察视觉质量、相机控制精度以及重访一致性。实验采用隐式历史搜索和显式 3D 记忆重建两类基线进行对比,同时加入基于几何的对应方法和全局融合 3D 记忆方法作为参考。消融研究覆盖核心组件:
- 移除 Geometric Correspondence Attention (GCA) 的变体
- 使用 Dense History Attention 替代稀疏对应的变体
- 移除 Invisible Octree 的变体
- 移除 Degraded-History Augmentation 的变体
- 对 correspondence 施加扰动以测试鲁棒性
关键发现
GEAR 在长轨迹视频生成中取得 state-of-the-art 的视觉质量与相机控制精度,并能在挑战性轨迹上生成分钟级视频。通过将几何作为显式 token 级内存地址,模型避免了全局 3D 融合带来的误差累积,同时实现了高效的内存访问。消融实验表明:
- GCA 对几何匹配历史特征的注入至关重要,缺失会导致重访区域细节丢失。
- Invisible Octree 有效剔除被遮挡的对应,减少错误特征注入。
- Degraded-History Augmentation 显著提升模型对历史帧质量退化的鲁棒性。
与基线的深度对比
相比隐式搜索方法,GEAR 的显式几何寻址避免了在整个历史序列上的注意力扫描,推理效率更高,且内存占用量不随历史长度线性膨胀。相比全局 3D 重建方法,GEAR 不构建持久化全局表示,从而规避了长序列中的几何漂移问题。这一设计使 GEAR 在长时、可回访的相机轨迹上展现出明显的一致性优势,而基线方法通常在重访时出现纹理模糊或结构扭曲。
行业影响
落地场景
GEAR 的长时程相机可控视频生成能力,可直接用于需要精确视角控制与长期场景一致性的场景:
- 电商产品展示:为商品自动生成多角度、环绕式的长视频,替代传统多机位拍摄,支持自定义相机轨迹。
- 自动驾驶仿真:根据真实采集的驾驶数据,生成不同相机路径的长距离街景视频,扩充训练数据。
- 虚拟制片与预演:导演可自由设计相机运动,生成分钟级连贯预览,降低实拍成本。
商业价值
- 降本:避免昂贵的 3D 重建与人工逐帧修正;几何仅作为寻址信号,不依赖全局融合,减少误差累积带来的后期修复。
- 体验提升:消除长视频中的闪烁与不一致,提升用户对生成内容的信任度,适用于高价值内容生产。
- 增收:为视频生成平台提供差异化能力,支持按镜头复杂度收费,或作为专业工具订阅模块。
集成接口
GEAR 可作为现有扩散视频生成管线的附加模块:
- 输入 RGB 历史帧 + 对应深度/相机位姿(可由现成 SLAM 或深度估计器获得)。
- 在 denoising 过程中,用 Geometric Correspondence Attention (GCA) 替换或增强部分 cross-attention,实现稀疏历史记忆注入。
- Invisible Octree 可部署为轻量级外挂,负责可见性过滤,与现有 VAE、Flow-Matching 训练目标兼容。
- 推理时采用流式更新,可与自回归视频生成框架(如基于 DiT 的模型)无缝衔接。
局限
- **几何精度依赖**:GEAR 依赖逐帧几何(如深度估计)建立 token 级对应,但几何噪声会直接导致错误对应;虽然 **Invisible Octree** 能过滤遮挡,但无法修正几何漂移。在动态场景或纹理稀疏区域,深度误差可能引发历史特征注入错误,而论文未讨论几何源的质量控制或在线优化策略。相比隐式搜索方法,对几何质量更敏感,实际部署需额外引入深度先验或鲁棒估计,增加系统复杂度。
- **内存与索引开销随序列增长**:保留全部历史帧 latents 作为视觉记忆,在分钟级视频中 token 数量线性增加;**GCA** 的稀疏对应注意力虽降低了计算,但 **Invisible Octree** 累积与多源 patch 缓存仍带来存储和索引开销。论文未给出超长序列下的内存上限或记忆淘汰策略,可能限制在受限设备上的应用。
- **实验覆盖与对比局限**:实验主要针对结构化相机轨迹,可能未充分测试快速旋转、复杂遮挡或大规模场景;与最新的全局 3D 记忆方法对比不够全面。训练时的 degraded-history 增强可能掩盖某些真实退化,泛化到任意相机路径和更高分辨率有待验证。