模型内部信息何时有用?探索表征工程在 LLM 安全中的作用
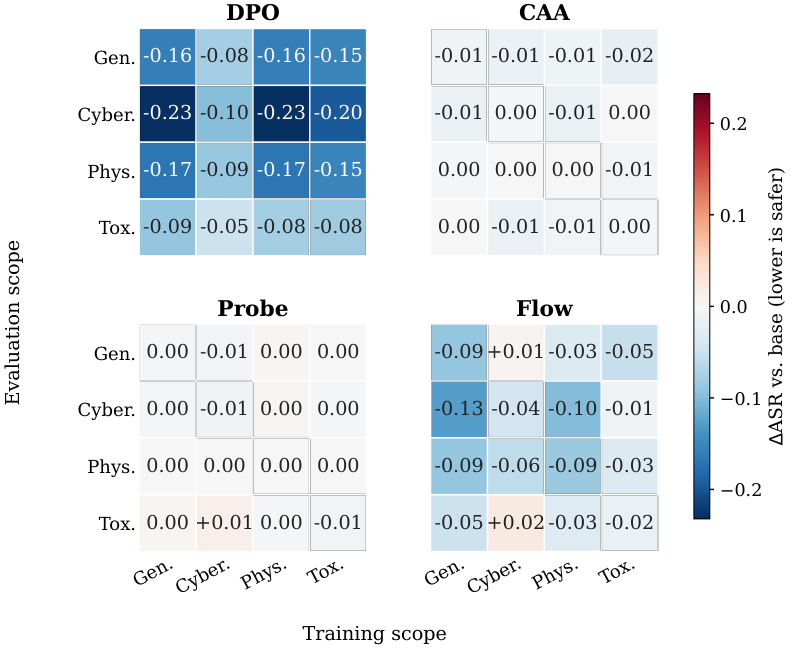
可靠的 AI 防护需要两类机制:减少不安全行为的控制机制,以及在交互中检测安全风险的监测机制。已有的行为层面防护包括优化模型输出的对齐方法和评估交互文本的文本监测器。表征工程(representation engineering)则读取或修改模型内部状态,但由于评估设置不同,这些方法的相对优势仍不清楚。本文在两条赛道上进行匹配评估。 在安全控制方面,我们比较行为对齐方法 DPO 与三种表征引导(representation steering)方法,考察鲁棒性、实用性和粒度。DPO 提供最强的整体控制,且通常随训练数据增加而改善,但其安全性可能在后续良性微调后退化。表征引导主要在低数据场景下具有竞争力,尤其是在高质量对比数据下。 在安全监测方面,我们比较表征探针(representation probes)与微调及开放权重文本监测器,考察全响应检测、早期检测和计算成本。专用文本监测器达到最高的整体检测准确率,而表征探针以显著更低的边际成本保持竞争力。 最后,监测器引导的干预 能恢复 DPO 在良性微调后丧失的大部分安全性,且几乎不增加过度拒答。总体而言,表征工程通常不能替代行为层面防护,但在特定条件下具有实用优势,并可提供互补的安全收益。
论文精读
TL;DR 本文系统对比了表示工程与行为护栏在 LLM 安全中的控制与监测能力,发现表示操控在低数据控制、表示探针在低成本监测上具备独特优势,并能互补行为方法提升整体安全性。
问题
问题背景
当前 LLM 安全研究关注两类机制:安全控制(降低不安全行为)与安全监控(检测交互中的安全风险)。行为层面方法(如 DPO 对齐、文本分类器)已广泛应用,但表示工程(representation engineering)直接读取或修改模型内部状态,其相对优劣尚未系统评估。
现有方法局限
行为对齐方法(如 DPO 训练稳定性好、数据规模收益明显,但在后续良性微调后安全性可能显著退化;文本监控器(如 Qwen3Guard 检测精度高,但边际计算成本较高。表示工程方法中,表示操控(representation steering)在低数据、高质量对比数据场景下才展现竞争力,且易受攻击形式和良性微调影响;表示探针(representation probes)成本低,但全响应检测精度普遍不如专用文本监控器。此外,两类方法传统上在不同设置下评估,缺乏匹配基准,导致结论不可直接比较。
为什么这个问题难/重要
难点在于:安全控制需同时平衡 鲁棒性(抗越狱)、实用性(不过度拒答、保持能力)与 粒度(跨范围迁移);安全监控则涉及全响应检测、早期检测与计算成本。业界对 LLM 部署中的实时安全防护需求迫切,而表示工程若能在低数据或低成本场景提供补充甚至替代,将显著降低安全基础设施开销。但模型内部状态的语义仍不透明,且不同架构、训练阶段的表现差异大,导致工程选型困难。
行业类比
类似自动驾驶中同时依赖行为克隆与内部状态监控——行为对齐 如驾驶策略优化,表示探针 如传感器故障检测;单独使用都可能漏报,组合才能提升整体安全性。
核心洞察
- 本文通过匹配评估范式,将 DPO 与三种表示控制方法在相同鲁棒性、实用性与粒度设置下直接比较,表明表示工程无法整体替代行为对齐,但在低数据且高质量对比数据条件下可保持竞争力。该角度独特在于此前工作通常各自为政,评估指标、攻击集和模型不一致,导致无法直接比较。本文统一变量,使“何时模型内部状态有帮助”成为可回答的经验问题,而非模糊的偏好。
- 监控-控制集成揭示了表示探针的另一互补价值:即使行为对齐在良性微调后安全性退化,通过表示探针或文本监控的检测信号触发干预,可以恢复大部分安全性,且额外过度拒绝有限。不同之处在于以往安全研究通常分别优化控制或监控,本文展示了将内部状态检测转化为控制回路的可能性,为实际部署中应对微调后的安全漂移提供了新思路。
- 表示探针在计算成本上的优势被量化:尽管专用文本监控在全响应检测和流式检测上准确率最高,但原生表示探针的边际计算成本低得多,适合实时低开销监控。该角度独特在于大多数工作只报告准确性,本文显式比较边际成本,为资源受限场景下的监控方案选择提供了依据。
方法
安全控制
输入为 prompt,关键模块包含两条路径:DPO 在成对安全/不安全响应上优化策略,直接调整模型输出分布;三种表示操控方法(其中一种为 Flow)通过拟合安全相关方向,在解码过程中修改隐藏状态。输出为模型响应。评估覆盖鲁棒性(多类越狱攻击下 ASR)、实用性(过拒答率、能力保持、数据效率)和粒度(跨范围迁移)。
安全监控
输入为模型完整响应或流式 token。representation probes 在隐藏状态上训练线性分类器,输出安全分数;文本监控器包括微调 LLM(FT-LLM)与开放权重监控器 Qwen3Guard,输出逐 token 风险概率。评估维度包括全响应检测精度、早期检测及时性与边际计算成本。
监控-控制集成
监控器输出风险信号后,触发纠正性再生或引导干预,以恢复 benign fine-tuning 后的安全损失。
差异点:与先前孤立比较不同,本文在统一设置下匹配对比行为与表示两类方法,并验证监控-控制协同收益。
实验
实验设计
论文在安全控制和安全监测两条轨道上进行配对评估。安全控制比较行为对齐方法 DPO 与三种表示操控方法,评估维度包括鲁棒性、实用性和粒度控制;安全监测则对比表示探针与微调及开源权重文本监测器,指标覆盖全响应检测、早期检测和计算成本。另设监控引导干预实验,检验是否能在良性微调后恢复安全性能。
关键发现
- DPO 在多数攻击下鲁棒性最强,且随训练数据量增加性能持续提升,但良性微调会削弱其安全性。
- 表示操控在低数据场景下具有竞争力,尤其使用高质量对比数据时,但 Flow 方法的过拒绝率较高。
- 监测方面,Qwen3Guard 等专门文本监测器检测精度最高,但表示探针在边际计算成本上优势明显。
- 滚动探针提供更低的 FPR 操作点;监控引导干预能恢复 DPO 良性微调后的大部分安全损失,且额外过拒绝很小。
与基线对比解读
表示工程(representation engineering)方法普遍不能取代行为对齐,但在特定条件下具备实用价值:数据稀缺时表示操控可作为替代;计算预算受限时表示探针可作为低成本的监测第一层。监控与控制的集成进一步表明二者互补——表示工程为行为方法提供补充安全效益,而非简单替代。这一结论对实际部署中如何选型安全技术具有直接指导意义。
行业影响
落地场景
LLM 安全控制与监控在内容审核、智能客服、教育辅导、金融咨询等高风险场景中是刚需。论文结论直接指向两类产品形态:
- 低数据垂直领域:例如一家医疗问答创业公司,只有少量人工标注的安全对比数据。此时 representation steering 可在数据稀缺时保持竞争力,无需大规模对齐训练即可对模型行为进行轻量控制。
- 已上线且需持续微调的服务:例如企业客服模型定期用新业务数据做 benign fine-tuning,但可能引发安全退化。采用 monitor-guided intervention:先部署representation probe 实时检测风险,发现不安全时触发拒绝或重生成,可恢复大部分安全性能,且过度拒答增加很少。
商业价值
- 降低边际计算成本:representation probe 只需读取内部隐藏状态,无需额外生成完整文本,监控成本显著低于文本监控器(如 Qwen3Guard 或微调 LLM)。在高并发内容生成场景中,可节省 GPU/API 费用。
- 减少人工审核与合规风险:早期检测可将风险拦截在输出阶段,避免后续用户投诉、监管处罚或品牌损害。
- 数据效率优势:在高质量 contrastive data 少的情况下,steering 方法能接近 DPO 的效果,让中小团队无需昂贵的数据标注预算也能获得基本安全保障。
跟现有产品/工作流的接口
- 推理引擎集成:在 vLLM 或自研 serving 框架中通过 hook 获取指定层 hidden states,输入轻量线性 probe,输出风险分数。该模块可做成独立 sidecar 服务,与主模型解耦,支持热插拔。
- 对齐流水线:先用 DPO 完成基础对齐,上线后持续用 representation probe 监控;若检测到安全退化(例如 benign fine-tuning 后),启用 monitor-guided intervention 动态拦截,无需重新训练完整对齐模型。
- 监控面板:将 probe 输出作为日志指标接入现有 observability stack(如 Prometheus/Grafana),设定阈值告警,同时保留原始交互文本用于离线复核。
局限
- 评估范围有限,结论外推需谨慎。论文在 Llama-3.1-8B 等开源模型上开展实验,攻击集与良性微调场景相对有限,无法覆盖所有部署条件。表示工程对**高质量对比数据** 依赖较强,当 unsafe/safe 成对数据质量不高时,steering 与 probe 的优势会明显削弱。论文主要聚焦单轮交互与静态响应,对多轮对话、工具调用或代理场景下的安全监测与控制未做深入探讨,因此相关发现在复杂交互环境中的适用性尚不明确。
- 实验设计存在可推断局限。表示工程方法的超参数(如层选择、注入位置、probe 训练方式)虽做了敏感性分析,但搜索空间远未穷尽;full-budget Flow 在良性微调后性能下降,表明表示工程本身同样受微调影响,论文仅给出恢复性实验,缺乏对更稳健表示策略的探索。另外,计算成本估算基于简化假设,未考虑生产环境下批量推理、硬件加速及缓存等实际因素,可能高估或低估表示 probe 的边际成本优势,影响工程决策参考价值。
- 与同类工作对比存在弱点。相较于在线 RLHF、动态安全分类器等最新行为安全方法,表示工程缺乏统一的训练与评估协议,且当训练数据充足时,representation steering 明显弱于 DPO,限制了其作为主流控制手段的吸引力。在监测方面,representation probe 在流式早期检测上落后于专用文本监控器(如 **Qwen3Guard**),仅在全响应检测与低计算成本场景下有竞争力。这意味着在需要实时干预的高风险应用中,表示工程可能并非首选方案,其实际部署价值仍待进一步验证。