Nereus:面向 LLM 后训练的自适应并行
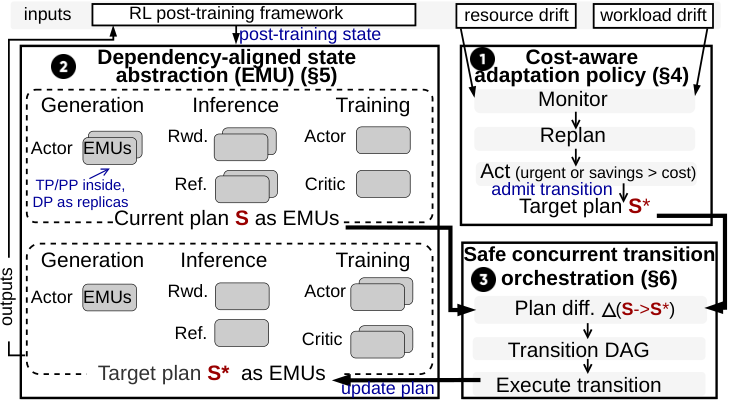
强化学习(RL)后训练 需要在大规模 GPU 集群上协调生成、推理与训练多个模型。运行过程中,资源可用性、序列长度、显存压力与各阶段瓶颈都可能发生变化,导致最初合适的执行计划逐渐变慢甚至不可行。然而,当多个模型共享 GPU 时,调整执行计划面临三重挑战:判断新计划是否值得迁移开销、复用作业的分布式状态,以及在模型与阶段之间协调 GPU 数据传输。 Nereus 是一个开销感知的运行时系统,可将 RL 后训练作业自适应调整为高效执行计划。其低开销控制器会选择显存可行的全局计划,并基于对运行中作业校准的开销模型决定是否执行迁移。为了估计并执行迁移,Nereus 将模型-阶段(某阶段中的一个模型)的每个副本的分布式状态表示为 Elastic Model Unit,并通过全局迁移图来编排这些单元的变换与 GPU 传输顺序。 实验表明: - 在真实数据轨迹中,在线 TP/PP 自适应 相比初始固定 TP/PP 布局配合 DP 扩展,将平均步延迟降低 27.7%; - 在达到 1,024 GPU 的 1,000 步运行中,六次迁移仅占总运行时间的 0.079%; - Nereus 在多样化集群上将 8B PPO 端到端吞吐相比 OpenRLHF 提升 2.14--7.27 倍,相比 Verl 提升 1.10--1.47 倍。
论文精读
TL;DR Nereus 是面向 LLM RL 后训练的自适应并行运行时:在线监测资源与负载漂移,用成本模型决策 TP/PP 重分片并协调跨模型状态迁移,平均步进延迟降低 27.7%,切换开销仅占千分之零点零七九。
问题
问题背景
LLM 强化学习后训练(RL post-training)在 GPU 集群上同时运行生成、推理和训练等多个模型,资源需求随时间动态变化。
现有方法局限
现有系统如 OpenRLHF 和 Verl 主要依赖静态执行计划:一旦确定 TP/PP/DP 布局,整个运行期间保持不变。但当序列长度增长、显存压力上升、集群资源收缩或阶段瓶颈迁移时,初始并行配置会逐渐变得低效甚至不可行。手动调整又面临三大障碍:
- 迁移成本未知,难以判断新计划是否值得切换;
- 分布式状态(权重、优化器状态、数据采样器状态等)难以在模型间安全重用;
- 跨模型、跨阶段的 GPU 传输依赖复杂,缺乏统一编排机制。
为什么这个问题难且重要
技术挑战在于:在线自适应需要低开销控制器实时监控运行时漂移;成本模型必须针对正在运行的任务进行校准,否则迁移决策失误会引入显著开销;并行度重分片涉及多模型共享 GPU 的复杂数据移动,任一环节出错可能导致训练中断或 OOM。业界关注度高是因为 RL post-training 是 LLM 对齐的核心环节,而集群资源动态变化在真实生产环境中普遍存在。论文实验显示,在线 TP/PP 自适应相对固定布局可降低 27.7% 的平均 step latency,端到端吞吐较 OpenRLHF 提升 2.14–7.27 倍,证明该方向有重大收益。
行业类比
类似自动驾驶系统根据实时路况动态调整路径规划,而不是固守出发时设定的路线;Nereus 为 LLM 后训练提供了运行时“导航”能力,让并行策略随集群状态自适应演进。
核心洞察
- Nereus 的核心贡献在于把执行计划切换的成本显式纳入决策,用在线校准的成本模型评估 transition cost 与后续收益。与现有弹性训练系统(如 Megatron 的 DP 弹性或 DeepSpeed 的 ZeRO 重配置)通常只检查新计划可行性、忽略状态迁移开销不同,Nereus 在 replan 阶段即计算转换开销,防止频繁重配置导致吞吐量下降。其在 1,000 步 RL 运行中仅 6 次转换、开销占比 0.079%,证明了成本感知决策的工程价值。
- Nereus 将每个 model-stage 的 replica 抽象为 Elastic Model Unit (EMU),以模型阶段边界对齐分布式状态依赖,使得跨 TP/PP 的重分片与 GPU 迁移可表示为全局 transition graph 上的节点转换。这解决了 RL post-training 中 actor、critic、reference、reward 共享 GPU 池时的协调难题,避免跨模型死锁和资源争抢,这是单体 LLM 训练系统无法覆盖的场景。其在跨集群实验中端到端 PPO 吞吐比 OpenRLHF 高 2.14-7.27 倍,验证了 EMU 机制在复杂负载下的有效性。
方法
输入与运行上下文
Nereus 接收一个正在执行的 RL post-training 作业,该作业由多个模型(如 actor、critic、reference、reward model)组成,每个模型可能按数据并行(DP)、张量并行(TP)、流水线并行(PP)切分,并共享 GPU 集群。作业执行过程中,运行时实时监控资源可用性、序列长度、显存压力、各 stage 的瓶颈等漂移信号。
关键模块与流程
Monitor 阶段
低开销控制器周期性采集运行指标,检测当前执行计划是否偏离最优(或变得不可行),触发重规划。Replan 阶段
控制器基于在线校准的成本模型(calibrated against the running job)评估候选执行计划。成本模型会考虑切换代价与目标计划的预期收益,同时保证目标计划显存可行。最终选择一个全局最优的 TP/PP/DP 布局。Act 阶段(状态抽象与转换编排)
为了执行布局切换,Nereus 将每个模型-stage 的副本分布式状态抽象为 Elastic Model Unit (EMU)。每个 EMU 对应一个模型在某个 stage 上的完整分片状态(参数、优化器状态、梯度等)。系统构建一个全局转换图(global transition graph),将 EMU 的变换(如 TP 重分片、PP 调整)与 GPU 间的数据迁移排序为 DAG,确保并发转换安全且不破坏训练一致性。
输出
输出为更新后的执行计划:作业以新的 TP/PP/DP 配置继续运行,且转换开销被控制在极小比例(实测 1,000 步中 6 次转换仅占总时间 0.079%)。
与同类方法的差异
Nereus 不同于 OpenRLHF、Verl 等静态或仅支持 DP 缩放的 RL 后训练系统,它首次在运行时同时自适应 TP/PP 布局,并通过 EMU 抽象和全局转换图实现低成本、安全的状态重分布。
实验
实验设计
Nereus 基于真实数据构建 trace,在 RL post-training 作业上评估 在线 TP/PP 自适应,对比固定 TP/PP 布局 + DP 扩展,并覆盖 8B PPO 在不同集群与 OpenRLHF、Verl 对比。
关键发现
- 在线 TP/PP 自适应 使平均 step 延迟下降 27.7%。
- 1,000 步规模至 1,024 GPU,6 次过渡仅占 0.079% 总运行时间。
- 端到端 8B PPO 吞吐相对 OpenRLHF 提升 2.14–7.27×,相对 Verl 提升 1.10–1.47×。
与基线对比解读
核心收益来自运行时 drift 的响应式重规划;固定 TP/PP + DP 扩展在资源或序列长度变化后效率下降甚至不可行。过渡成本被 cost model 控制,实验证明可忽略,说明自适应并行度不只是理论上可行,工程开销可控。相比之下 OpenRLHF/Verl 缺乏原生在线重配置,需要停机或手动调整。
行业影响
落地场景
RL post-training(如 RLHF/PPO)是生产级 LLM 对齐的核心环节,涉及 actor、critic、reward model 多模型协同,常面临动态序列长度、资源抢占和阶段瓶颈。Nereus 的自适应并行(在线调整 TP/PP/DP)适用于任何基于 GPU 集群的大规模 LLM 后训练任务。
具体用例:
- 电商对话推荐助手:在线流量存在波峰波谷,训练集群可能被其他任务抢占。Nereus 监测资源变化并动态调整并行度,避免 OOM 或效率骤降;在促销季可临时扩展 DP,训练吞吐提升,模型迭代更快。
- 内容平台的内容审核/生成模型:RLHF 训练中用户反馈数据长度不一,序列长度 drift 导致固定 TP/PP 失衡。Nereus 在运行中切换并行布局,减少 27.7% 步延迟,显著缩短训练墙钟时间。
商业价值
- 降本:Nereus 使平均步延迟降低 27.7%,端到端吞吐最高提升 7.27×(对比 OpenRLHF),直接减少 GPU 小时数和云成本;弹性利用空闲资源,避免资源浪费。
- 增收/体验:更快完成模型迭代,让对话助手、推荐系统等产品能更频繁更新策略,提升用户满意度和转化率;在资源受限场景下仍能维持训练可行性,避免宕机损失。
与现有工作流集成
Nereus 以 runtime 形式接入现有 RLHF 框架(如 OpenRLHF、Verl)或底层分布式训练框架(如 Ray/DeepSpeed),通过监控器采集运行指标,重规划器基于成本模型选择目标并行布局,执行器利用 EMU 抽象协调模型状态迁移。无需修改模型代码,只需在启动脚本中配置 Nereus 控制器,并允许其对 TP/PP/DP 进行动态重配置。与 Kubernetes 或 Slurm 等集群调度器配合,可在资源变动时触发重规划,实现训练作业的弹性伸缩。
局限
- - 论文主要面向 RL post-training 场景,虽然实验声称覆盖多种算法,但评估仍以 PPO 为中心,未展示在 SFT、预训练等其他 LLM 训练范式中的表现。其 Elastic Model Unit 抽象和全局 transition graph 针对 RL 的多模型、多阶段协作特点设计,可能不适用于只有单一模型或简单数据并行的训练任务,通用性有待进一步验证。 - 成本模型依赖在线校准来匹配运行中的作业状态,但在作业启动初期或资源、序列长度等剧烈抖动时,校准样本可能不足,导致过渡决策并非全局最优。论文报告在 1024 GPU 规模下过渡开销仅占总运行时间的 0.079%,但未评估更大规模(如数千 GPU)或更频繁重规划时的开销增长,编排复杂度可能随模型数和阶段数非线性上升。 - 与 OpenRLHF 和 Verl 相比,Nereus 需要更深入的框架集成,其 EMU 状态抽象和并发过渡编排机制可能增加工程实现复杂度。论文未讨论与 Megatron-LM 等底层并行框架的兼容性细节,也未提供与其他流行 RLHF 系统集成的示例,这可能限制在现有代码库上的快速部署,增加维护成本。