SentZero:一种面向多任务零样本胸部 X 光分析的增强句子中心视觉-语言预训练
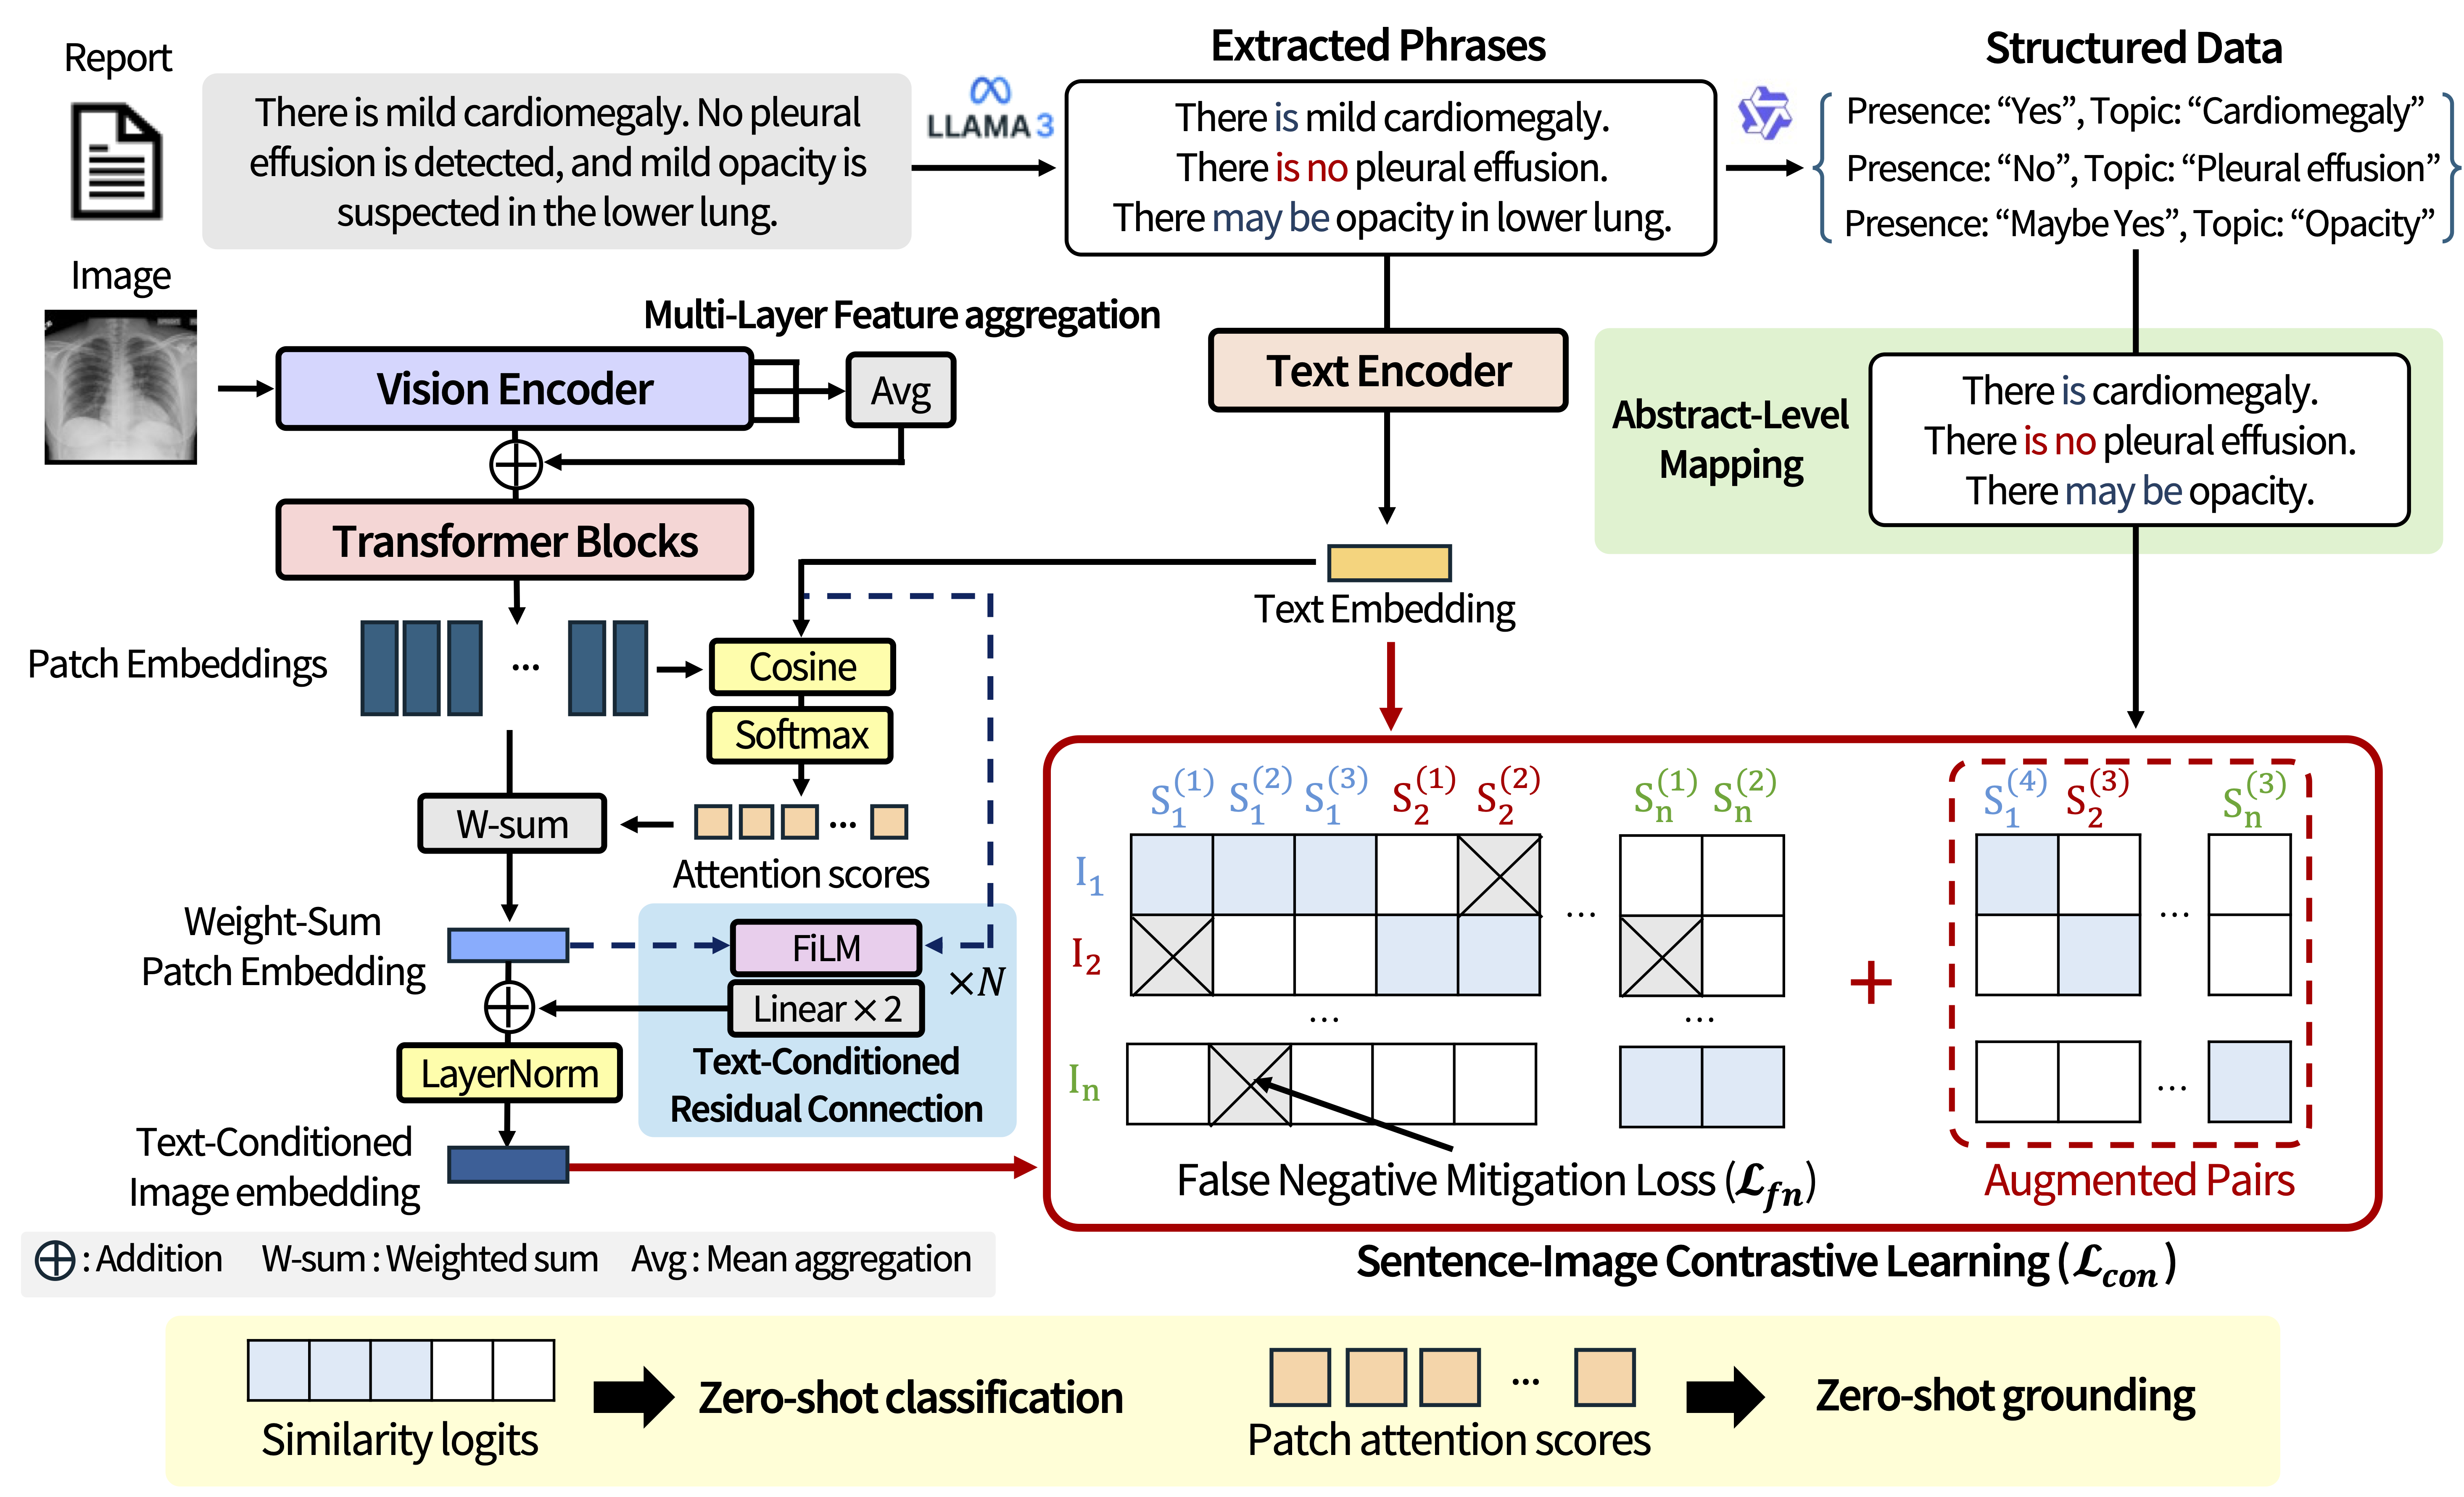
利用成对的胸部 X 光(CXR)图像与放射报告进行视觉-语言(VL)预训练,在医学图像理解上展现出强大潜力。然而,现有方法往往仍依赖任务特定的微调,因为放射报告冗长、临床信息密集,且难以与简单的零样本提示对齐。近期的句子级方法借助大语言模型(LLM)抽取的临床短语,部分缓解了这一限制,但它们在很大程度上忽略了放射学语篇的内在特性。 具体而言,有限的正样本对多样性 制约了性能的进一步提升,而临床上等价的句子在不同患者间频繁重复,会在对比学习中造成假阴性。 为此,我们提出 SentZero,一个面向零样本、多任务 CXR 分析的增强句子中心 VL 预训练框架。SentZero 引入基于 LLM 的摘要级句子结构化与映射,以扩展正样本对多样性,并增加一个额外的损失项来缓解假阴性。我们还引入句子条件化的视觉嵌入残差调制,使视觉特征能够适应每个输入句子的语义特征。 在多种下游任务与数据集上,SentZero 提升了零样本泛化能力,并优于此前的多任务零样本方法。
论文精读
TL;DR SentZero 引入 LLM 抽象级句子映射、假阴性损失和句子条件视觉调制,解决放射学报告的有限正对多样性与假阴性问题,提升多任务零样本胸部 X 光分析性能。
问题
问题背景
胸部 X 光(CXR)是临床最常用的影像模态之一,视觉语言预训练(VL pretraining)通过配对图像与放射学报告学习通用表示,已成为医学影像理解的研究热点。然而,放射学报告冗长且信息密集,与零样本推理中简洁的文本提示难以对齐,导致现有方法仍依赖任务特定微调。
现有方法局限
近期句子级方法使用 LLM 从报告中提取临床短语,显著改善了对齐,但仍忽视放射学话语的固有特性:
- 正样本对多样性受限:模型通常仅以原始图像-句子对作为正样本,而放射学报告中的句子常以不同措辞表达相同临床含义(如“心脏大小正常”与“心影不大”),有效正样本不足,限制了对比学习的上限。
- 假阴性问题突出:临床等价句子在不同患者的报告中频繁出现,在传统对比学习中被错误地视为负样本,导致表示空间被扭曲。
为什么这个问题难/重要
放射学文本具有高度结构化和重复性,简单迁移自然图像的对比学习策略会造成严重的语义冲突。同时,医疗场景标注成本高昂,零样本多任务能力(如分类、病灶定位)能显著降低对新数据的依赖。业界对医学影像 AI 的落地关注持续升温,零样本泛化成为关键能力之一,但需要针对领域特性设计专门的预训练目标。
行业类比
这类似于推荐系统中处理重复用户行为序列时,需要设计去偏损失以缓解负采样偏差——医学 VL 预训练同样需要克服文本重复带来的对比学习噪声。
核心洞察
- SentZero 通过 LLM 生成的抽象级句子映射扩大正样本对多样性,同时引入假阴性损失处理临床等价句重复出现的问题。现有句子级方法通常从报告中提取临床短语,但这些短语在不同患者间可能语义等价,导致对比学习中将它们视为负样本,限制了表示学习。SentZero 使用 LLM 将原始句子映射到抽象层面的表述,不仅生成更多样的正样本对,还显式惩罚假阴性对,这比仅依赖原始报告句子或简单数据增强的方法更贴合放射学文本的语义重复特性。这种设计直接针对医学影像文本的固有冗余,而非通用对比学习的通用技巧。
- SentZero 引入句子条件残差调制,使视觉编码器的特征能够根据输入句子的语义动态调整。传统视觉-语言预训练中,图像编码器提取的视觉特征通常是固定的,不随文本输入变化。SentZero 在视觉嵌入上添加由句子特征驱动的残差调制,让同一张 X 光片在不同临床描述下产生不同的视觉表征。这更加符合放射学诊断中“同一图像可对应多种临床发现”的特点,与单纯使用对比学习对齐固定全局特征的方法相比,提升了零样本任务(如分类与定位)中的特征适应性,是模型结构层面的创新而非仅训练策略。
方法
输入与预处理
SentZero 的输入为成对的 CXR 图像 与 放射学报告。原始报告冗长且临床信息密集,难以直接对齐零样本提示。因此,先用 LLM 对报告进行抽象级句子结构化与映射:将报告切分为临床短语,并进一步映射到抽象级别的语义表示,以扩大正对多样性。
关键模块
- 特征提取:使用视觉编码器(如 CNN/ViT)提取图像嵌入,文本编码器提取短语嵌入,二者进入对比学习框架。
- 句子条件残差调制:引入一个轻量调制模块,根据输入文本嵌入对视觉嵌入施加残差调整,使视觉特征能适配不同句子的语义特性,而非使用固定的图像表示。
- 对比损失与假阴性损失:标准对比损失拉近匹配的图像–句子对。由于临床等价句子在不同患者报告中频繁出现,直接视为负样本会引入假阴性。因此额外增加 假阴性损失,通过识别并软化这类情况来缓解影响。
输出与迁移
预训练后,模型可直接用于 零样本分类 与 零样本 grounding:分类时将类别名或短语作为文本输入,与图像特征计算相似度;grounding 则通过注意力图或相似度热图定位病灶区域。
与同类句子级方法相比,SentZero 的核心差异在于引入抽象级句子映射扩大正对多样性,同时显式建模假阴性,并用句子条件调制让视觉表征随任务语义动态改变。
实验
实验设计
论文在多个下游任务和数据集上评估 SentZero 的零样本迁移能力,涵盖 多任务零样本分类 与 零样本定位。与先前句子中心方法(如使用 LLM 提取临床短语)对比,SentZero 引入三项核心设计:
- 抽象级句子结构化与映射 扩大正样本对多样性
- 假阴性损失 缓解临床等效句子重复出现导致的对比学习假阴性
- 句子条件残差调制 使视觉嵌入适配输入句子的语义特性
实验主要在公开 CXR 数据集上进行,但原文未列出具体名称(输入节选未包含实验部分细节)。
关键发现
- SentZero 显著提升零样本泛化能力,并在多个下游任务上超越先前的多任务零样本方法。
- 通过抽象级句子映射,模型能学习更丰富的图像-文本对应关系,避免正样本对过于单一。
- 引入假阴性损失后,对比学习对语义等价但表述不同的句子更加鲁棒。
- 句子条件残差调制使同一图像在不同句子查询下产生自适应视觉特征,提升跨任务灵活性。
与基线对比深度解读
此前句子级方法依赖 LLM 提取临床短语,虽然降低了报告长度,但未能利用放射学报告的内在话语结构。SentZero 不仅提取短语,还在抽象层面进行结构化映射,显著扩大正对池;同时显式建模临床等效句子的重复模式,减少假阴性。这些改进使得模型在不进行任务特定微调的情况下,能够应对多任务零样本场景,展现出更强的通用性和数据效率。
行业影响
落地场景
SentZero 的句子中心视觉语言预训练方法可直接用于胸部 X 光多任务零样本分析产品,如放射科辅助诊断系统、体检影像筛查、远程医疗影像平台。它同时支持分类(如肺炎、气胸、胸腔积液)与病灶定位,无需为每个任务单独微调,适合快速扩展新病种覆盖。
商业价值
零样本能力大幅减少对标注数据的依赖,降低数据采集与标注成本;多任务统一模型减少推理服务部署资源,提升 ROI。在体检和基层筛查中,可提高报告生成效率与一致性,缩短患者等待时间,改善体验。潜在增收来自向更多医疗机构提供按调用量计费的 API 或本地化部署授权。
与现有产品 / 工作流的接口
SentZero 可作为预训练权重或微调起点,集成到现有 PACS/RIS 系统或影像云平台。通过标准 DICOM 输入、REST API 输出结构化 JSON(分类标签 + 热力图),与医院信息系统无缝对接。工程上可与现有 CV 推理框架(如 PyTorch、ONNX Runtime、TensorRT)结合,部署为容器化服务。
具体 use case:
- 医学影像 AI 公司(如提供胸部 X 光自动筛查 SaaS)可将其作为基础模型,快速上线新病种检测模块,减少每个病种需要数千张标注的周期,加速产品迭代。
- 远程医疗平台集成 SentZero 后,可对上传的 X 光片自动生成结构化发现列表,辅助医生预读,提高初诊效率。
局限
- **依赖 LLM 抽象级句子结构**:SentZero 使用 LLM 将句子映射到抽象级以扩大正对多样性,但 LLM 生成的抽象可能引入噪声或丢失细粒度临床信息,且处理大规模数据时推理成本较高。论文未讨论 LLM 失败案例或抽象映射的可靠性,这在低资源场景下可能成为瓶颈。
- **假阴性缓解有限**:提出的额外损失项旨在减轻临床等价句子重复导致的假阴性,但对比学习中的假阴性问题本质上是数据分布特性,单一损失项可能无法完全消除。论文仅在有限数据集上验证,未与更高级的假阴性处理策略(如软标签、聚类)系统比较,可能仍有改善空间。
- **实验范围局限于 CXR**:所有实验均在胸部 X 光数据集上进行,虽然多任务零样本性能提升,但方法是否适用于其他医学影像模态(如 CT、MRI)或更通用的视觉-语言任务尚未验证。此外,零样本定位效果可能不如微调,实际部署中可能仍需微调以获得临床可用精度。