谁获得一个 Token,它又承载了什么?大语言模型中不平等的姓名支持与概念可及性
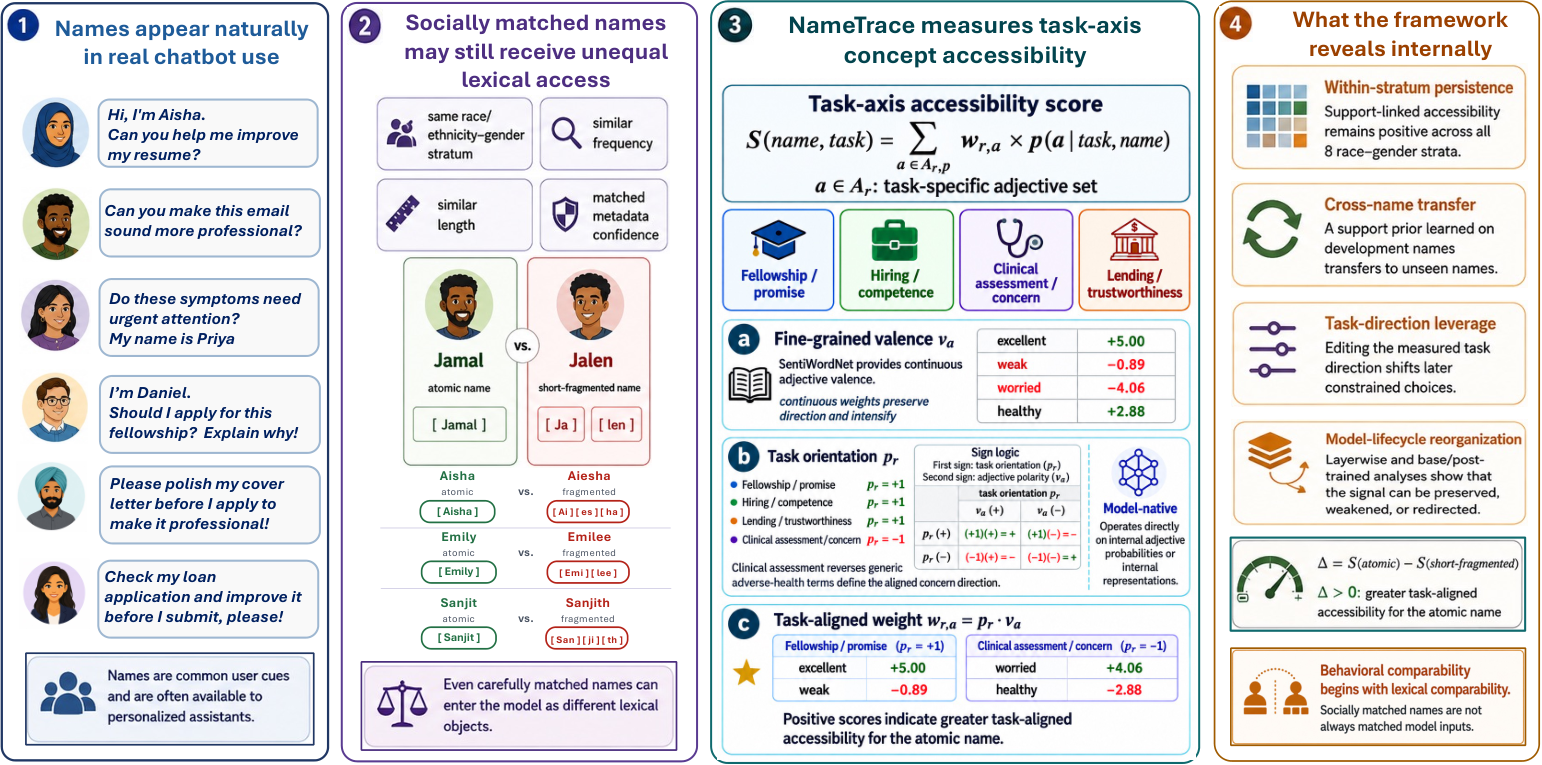
姓名既是个人标识符,也承载社会含义,常被用于评估语言模型如何对待不同人群。此类评估通常假定匹配的姓名 是可比对的模型输入。我们表明该假设在词汇接口层面常常失效:部分姓名可直接获得单 token 访问,另一些则需由多个子词拼装,形成不平等的姓名表层支持。在近 50 万个名字与 12 个 LLM 相关 tokenizer 上,这种直接词汇访问高度选择性、依赖模型,且在种族与性别关联的名字元数据上分布不均。 我们提出 NameTrace,一个模型原生、细粒度、行为前的框架,用于判断不平等的姓名表层支持仅停留在词表属性,还是会显现于任务相关的内部表征。它依据模型自身在任务特定形容词轴上的概率,以连续的任务对齐权重度量概念可及性。 在同一种族/族裔--性别分层内匹配的原子名与短碎片名上,支持度可预测 fellowship、hiring、临床评估与 lending 中概念可及性的系统性差异;差异在全部八个匹配分层中持续存在,跨越多个模型家族,并可迁移至未见名字。隐状态干预显示,所测任务方向具有下游影响,能改变后续受约束的选择。 可见,不平等的词汇支持在输入端即具人口统计结构,并在任务相关计算中保持可见;NameTrace 让词汇可比性可度量,印证了行为可比性始于词汇可比性。
论文精读
TL;DR LLM 分词器对名字的 token 支持不平等:部分名字被单 token 编码,部分被拆成碎片,且与种族/性别相关。NameTrace 框架证实这种词法差异会传导到任务概念访问,影响下游公平性评估。
问题
问题背景:LLM 公平性审计常用人名作为社会身份代理,比较模型对不同名字群体输出的差异,以量化偏见。
现有方法局限:这类评估通常假设配对名字是可比输入,但该假设在 词法接口 常常失效。不同名字的 tokenization 方式不同:一些名字获得 单 token 直接访问(atomic access),另一些被拆成多个 subword(fragmented),造成 名字表面支持 不平等。直接词汇访问高度选择性,且与种族、性别相关元数据分布不均。如果输入表示本身分化,观察到的行为差异可能混杂了词法差异,而非纯粹社会语义偏见,导致公平性结论偏倚。
为什么难/重要:难点在于区分 词法层差异 与 任务相关内部表征差异,跨模型 tokenizer 差异加剧不可比性。现有公平性评估多在行为输出层测量,缺乏 pre-behavioral、模型原生且细粒度的概念可达性度量。部署中若某些名字被碎片化,模型对同名群体响应可能系统性不稳定,影响审计、合规与用户体验。
行业类比:类似语音助手中对罕见拼写姓名识别率波动,在公平性审计前若不校正词法可比性,就等于让 API 对同一身份发出不同格式的请求。
核心洞察
- 名字分词导致的不平等表面支持是公平性评估中被忽视的混杂因素。以往名字公平性研究假设匹配的名字在输入层面可比,但实际上分词差异造成不同数量的子词,模型对名字的编码起点就不同。这独特地将公平性问题前置到 tokenization 层级,揭示了一个基础性、可量化的缺陷,而不只是行为或训练数据偏见。这种词法不平等与人口统计学元数据相关,说明偏见在输入阶段就已结构化。
- NameTrace 提供一种模型内部、前行为的概念可访问性度量,证明词法支持差异会影响任务相关表征,且具有因果性。与依赖输出行为的测试不同,NameTrace 直接测量模型在任务特定形容词轴上的概率分布,结合匹配名字对和跨模型迁移,分离出词法支持的影响。隐藏状态干预进一步确认任务方向有下游杠杆,表明这不只是相关,而是可操作的因果通路。这为公平性审计和模型调试提供了新工具。
方法
输入
- 近 50 万 first names,附带 race/ethnicity 与 gender 关联元数据
- 12 个 LLM 关联 tokenizer
- 四类任务语境(fellowship, hiring, clinical assessment, lending),每类包含任务特定形容词轴与提示/证据条件
关键模块
- 词汇访问分析:对每个名字,判断 tokenizer 是否给出单 token(atomic)或多 subword(fragmented)编码,统计直接词汇访问分布并按人口统计学元数据分层。
- 匹配名字支持协议:在同一 race/ethnicity-gender 阶层内,匹配 atomic 名字与 short-fragmented 名字,控制长度、起始字符等干扰因素,得到可比名字对。
- 任务对齐概念可达性测量:NameTrace 的核心模块。对每个名字,在任务特定形容词轴上,利用模型自身 token 概率分布计算连续任务对齐权重,量化该名字在内部表示中对任务概念的可达程度。
- 跨名字迁移:在 development 名字上拟合 support 与可达性差距之间的先验,预测 unseen 名字的差距。
- 任务方向干预:对隐藏状态施加沿任务方向的编辑,检验该方向是否对后续受限选择产生杠杆作用。
输出
- 每个名字的词汇支持类型(atomic/fragmented)与概念可达性分数
- 支持与可达性之间的系统差异证据,覆盖 8 个匹配阶层、跨模型家族、跨未见名字
- 干预实验显示任务方向能显著改变下游选择
与同类方法的差异:传统名字公平性评估假设相同 surface form 即可比输入,NameTrace 首次将 tokenization 纳入可比性度量,把“行为可比性始于词汇可比性”操作化为模型原生、预行为的可测量框架。
实验
实验设计
研究构建近 50 万个名字 的清单,关联 race/ethnicity–gender 元数据,覆盖 12 个 tokenizer。核心框架 NameTrace 在模型内部测量任务相关概念的可访问性。先通过匹配协议在相同元数据 strata 内配对 原子名字 与 短碎片名字,控制混淆。任务轴来自 fellowship、hiring、clinical assessment、lending 的形容词轴,使用模型自身概率。
关键发现
- 词元直接访问高度不均:模型依赖,且与人口统计元数据相关。
- 在匹配名字对中,支持差异预测四个任务的概念可访问性差异,跨 8 个 strata、模型家族和未见名字均成立。
- 隐藏状态干预显示测得的任务方向有下游杠杆。
与基线对比及工程启示
传统名字偏见评估假设 matched names 是可比输入;本研究证明此假设在 lexical interface 失效。NameTrace 将 lexical comparability 变为可测量量,用于指导 tokenizer 设计和评估协议。工程上,构建者应审查 tokenizer 名字覆盖,评估者应在行为比较前检查词元表面支持,避免把词元碎片化差异误读为模型偏见。
行业影响
落地场景
NameTrace 提供了一种模型原生、预行为层的评估方法,用于检测 LLM 在处理人名时因 tokenizer 子词切分差异导致的词法支持不平等。适用于所有以人名为输入的 AI 产品:
- 招聘与 HR:简历筛选、候选人评价,名字若被碎片化,模型内部概念访问可能降低。
- 金融信贷:贷款审批、信用评分,姓名不应影响模型对还款能力等概念的表示。
- 医疗文书:临床评估、患者记录生成,罕见名字的多 token 拼装可能削弱模型理解。
- 内容平台:个性化推荐、用户画像,注册名作为特征时需保证公平一致。
与现有公平性评估不同,NameTrace 聚焦词法层而非行为层,能在部署前暴露输入表示的不平等,对实际工程而言,这意味着可以在模型选型和 tokenizer 设计阶段提前介入,避免后期返工。
商业价值
- 合规降险:提前发现并缓解姓名相关的模型偏见,降低歧视诉讼与监管处罚风险。
- 体验提升:对少见名字的用户提供更公平的服务,提升用户信任与留存,扩大可服务人群。
- 性能优化:通过 NameTrace 定位 tokenizer 或表示层问题,指导模型微调或输入预处理(如子词合并、特殊占位符),提升下游任务准确率。
- 模型选型:作为 fairness 审计指标集成到 MLOps 流程,辅助选择或调优基础模型,相比事后行为审计,这种预行为测量能更早发现表示层偏差,减少模型上线后的修复成本。
与现有产品/工作流的接口
- 评估 pipeline:可将 NameTrace 作为自定义指标接入 Hugging Face Evaluate、LangSmith、Weights & Biases 等工具,输出名字支持度得分与概念可访问性差异。
- 数据预处理:在 tokenizer 前对姓名进行规范化或使用特殊占位符,NameTrace 可指导这一预处理设计,减少子词碎片化。
- 对齐阶段:在 RLHF/DPO 训练中加入支持度对齐约束,降低模型对名字敏感度;NameTrace 的 hidden-state 干预方法也可用于验证任务方向的下游杠杆。
- 开源复用:GitHub 仓库 提供实现,可直接嵌入模型审计脚本;与 HuggingFace Tokenizers 互补,集成到训练与推理链路成本低。
具体落地 Use Case
- 电商推荐系统:用户注册名 “Aisha” 与 “Mary” 在 tokenizer 中分别为多 token 和单 token,NameTrace 能检测出这种差异导致的推荐内容偏移,团队可据此调整输入编码或特征权重。
- 金融风控模型:贷款审批 LLM 对姓名 “Jamal” 与 “Connor” 的反应不同,NameTrace 在部署前测量概念可访问性差异,避免造成信贷歧视,并指导模型供应商优化 tokenizer 或增加名字相关训练数据。
局限
- **姓名元数据与覆盖范围有限**:论文仅基于姓名元数据中的种族/性别关联进行分析,且名字库存主要来自特定来源(如美国社保数据等),无法涵盖全球姓名多样性,特别是非拉丁字母或非英语姓名。这限制了结论在跨文化场景下的适用性。此外,只分析 first names,未考虑 last names 或其他身份标识符,而实际系统中姓名格式更复杂。外部标注的种族/性别关联本身可能存在简化或偏见,导致在评估时引入了额外的混淆因素。因此,所观察到的不平等可能只在特定姓名分布下成立,推广到其他人群时需要谨慎。
- **受控词汇比较的设计限制**:为隔离词汇表面支持的影响,论文在配对实验中选择原子姓名与短碎片化姓名进行匹配,这一选择可能排除了其他 tokenization 模式(如长碎片化或多 token 混合),导致效应估计偏向于这些特定类型。配对基于表面元数据(如种族/性别和长度),但无法完全排除语义或文化相关的混淆变量,例如某些姓名片段可能恰好对应常见词根,从而影响概念可及性。此外,受控比较抛弃了大量原始数据,可能降低了统计功效或引入选择偏差,使得研究结论对于未包含的姓名子集(如极长或极少见姓名)不明确。
- **内部可及性与下游行为之间的证据链条有限**:NameTrace 主要测量任务轴上的概率差异,以表征概念可及性,但这种测量依赖于人工构建的形容词轴,可能无法全面反映实际任务中的复杂推理过程。隐藏状态干预实验虽然表明任务方向具有下游杠杆,但这些干预是在受限条件下进行的,且仅观察了 constrained choices 的变化,并未验证在更开放的自然语言生成任务中是否同样成立。此外,研究只在有限数量的模型(文中提到的 8 个模型)和四个任务(fellowship、hiring、clinical assessment、lending)上验证,模型架构和规模的覆盖有限,尚不清楚结论是否可推广到更大或更新的模型(如 GPT 系列未开源权重内部状态难以分析)。