Pruned CTC:面向内存高效的大词表 ASR 训练
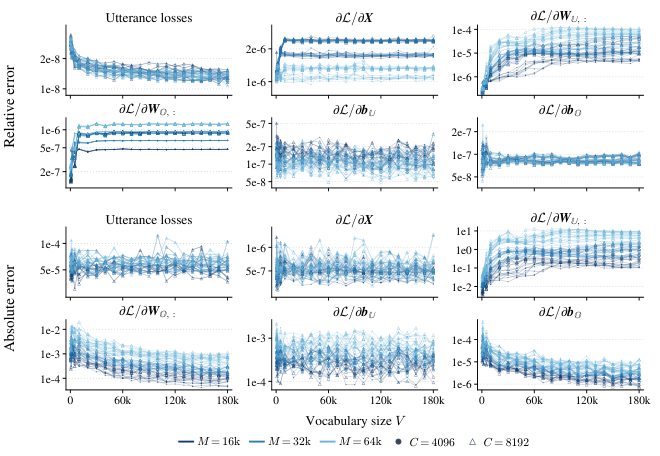
CTC 天然支持基于话语级监督的离线与流式语音识别,但传统实现需要把逐帧 × 词表的激活值全部落地到内存中,使得使用原生 LLM 词表进行 CTC 训练的内存开销高得难以承受。作者观察到:每条合法的 CTC 对齐只会用到目标 token 与 blank,而一个 batch 内这些 token 的并集通常只占完整词表的一小部分。 Pruned CTC 将对齐计算限制在该子集上,同时保留全词表归一化,并证明这种词表缩减在损失与梯度上与全词表 CTC 完全等价,使 head 与 loss 的激活内存不再随词表规模线性增长;此外还引入了 finite-beam 对齐剪枝。在此基础上提出的 LLM-CTC 可将预训练 LLM 适配为非自回归 ASR,同时保留因果注意力与原生词表,并扩展到有界历史流式场景,避免块级语音—文本对齐。 实验表明,使用 Zipformer-M 编码器与 180K 词表时,Pruned CTC 将整步内存降低 5.1 倍,步耗时仅增加 17%;在三个语料上,其精度与标准 CTC 持平。在 GigaSpeech 上,覆盖 0.6B 到 32B 的六种 Qwen3 规模,LLM-CTC 与 LLM-CE 的相对 WER 差距在 7% 以内,识别速度却快 7–10 倍;当微调 Qwen3-ASR 用于有界历史流式时,测试集上相对 WER 与匹配的离线模型差距在 3% 以内。 这些结果确立了 Pruned CTC 作为可扩展序列目标函数的地位,适用于原生词表的 LLM ASR 离线与流式场景。
论文精读
TL;DR Pruned CTC 利用 CTC 对齐仅需目标 token 和 blank 的特性,只对批次词汇子集计算激活,同时保留全词汇归一化,使内存占用降低 5.1 倍且准确率不降,让大语言模型能以原生词汇表高效训练非自回归 ASR。
问题
当前 ASR 领域关注如何将预训练 LLM 用于语音识别,同时追求内存高效的非自回归训练。
传统 CTC 实现 会显式物化每个时间帧对所有词汇的 logits(形状 T×V),内存随词汇表线性增长。当使用 LLM 原生词汇表(如 180K)时,单卡显存难以承受。现有 memory-efficient loss 要么采用采样近似(如 sampled softmax)破坏 CTC 全词汇归一化假设,要么引入 chunk-level 对齐或限制解码结构,牺牲 streaming 灵活性或精度。
为什么这个问题难/重要:CTC 要求对路径求和并做全词汇归一化:若只计算子集而舍弃其他词汇的贡献,会导致归一化不一致,影响梯度正确性和训练稳定性。此外,LLM-CTC 需要保留因果注意力 与原生词汇,同时在 streaming 场景避免 chunk 对齐,这对计算图设计提出严苛要求。业界对高效、精确、可扩展的序列目标有强烈需求。
行业类比:类似于大规模分类任务中用候选采样 替代 full softmax,但 Pruned CTC 做到精确等价,类比于在超大规模推荐系统中仅计算活跃 item 的 logits 却正确维护归一化常数。
核心洞察
- Pruned CTC 证明了在 CTC 训练中,损失和梯度计算可以严格限制在目标 tokens 与 blank 的小集合上,同时保持全词汇归一化,从而实现内存开销与词汇量解耦。这一发现区别于以往通过稀疏近似或随机采样来降低内存的方法,它提供了精确等价的理论保证,使训练原生大词汇量(如 LLM 的 180K 词汇)的 CTC 模型不再受显存线性增长的制约,为大规模 ASR 训练开辟了新可能。
- LLM-CTC 将预训练大语言模型直接作为非自回归 ASR 解码器与 CTC 结合,保持因果注意力和原生词汇,并通过有限历史流式扩展避免了 chunk-level 语音-文本对齐。相比基于交叉熵(LLM-CE)的 LLM 语音识别方法,LLM-CTC 在精度损失极小(7% 相对 WER 内)的情况下实现 7 到 10 倍解码加速,且支持流式推理,为实际部署大模型 ASR 提供了高性价比的方案。
方法
输入与目标
输入为声学特征序列及对应文本标注,词汇表使用 LLM 原生规模(如 Qwen3 的 180K 词表)。目标是计算 CTC 损失并更新参数,同时解决标准实现中帧×词表激活矩阵显存过大的问题。
关键模块:词汇缩减与等价归一化
Pruned CTC 的核心观察是每个 batch 内所有有效 CTC 对齐路径仅用到目标 token 与 blank,其并集构成一个小子集。计算时只在该子集上展开前向后向动态规划,同时保留全词汇归一化:通过重参数化将剩余词汇合并为一个“吸收”状态,或利用 logsumexp 技巧在子集 softmax 外校正全局归一化常数,保证损失与梯度跟标准全词汇 CTC 完全等价。随后引入有限束对齐剪枝,在前向过程中仅保留 top-k 路径,进一步降低计算量。
输出与 LLM-CTC 应用
输出为损失与梯度,用于更新编码器或 LLM 参数。基于 Pruned CTC 构建 LLM-CTC,将预训练 LLM(如 Qwen3 系列)作为声学模型微调,保留因果注意力 和原生词汇表,实现非自回归解码,推理速度比 LLM-CE 快 7–10 倍。流式场景采用有界历史注意力,避免 chunk 级语音-文本对齐。
与同类方法的差异点:相比标准 CTC 实现显存不再随词汇表线性增长,相比 LLM-CE 无需自回归解码且推理更快,相比 chunk 级流式方法免去了显式对齐工程。
实验
实验设计
作者在多个语料库上评估 Pruned CTC,包括 GigaSpeech 等,具体数据集名称未完全列出。编码器侧使用 Zipformer-M 和 180K 词汇表 进行内存与运行时间基准测试;LLM 侧采用 Qwen3 系列模型(0.6B 至 32B)做离线识别,并微调 Qwen3-ASR 用于 bounded-history 流式场景。
关键发现
- Pruned CTC 将 full-step 内存占用降低 5.1 倍,仅引入 17% 步时开销,且在三个语料库上精度与标准 CTC 持平。
- 在 GigaSpeech 上,六个规模的 LLM-CTC 模型相对 LLM-CE 的 WER 差距保持在 7% 以内,但识别速度提升 7-10 倍。
- 流式微调后, LLM-CTC 相对离线模型 WER 差距仅 3%,验证了该方法的流式适应性。
与基线对比解读
与标准 CTC 相比, Pruned CTC 的核心优势在于将激活内存复杂度从 O(V) 降至 O(B+U),其中 V 为词汇量,B 为 batch size,U 为目标 token 数。这对原生大词汇量 LLM 的 CTC 训练至关重要。与 LLM-CE 相比, LLM-CTC 通过非自回归解码大幅提速,同时保持相近精度,证明 CTC 目标在 LLM ASR 中的实用价值。流式与离线差距较小,表明剪枝和流式约束并未造成显著精度损失,适合实际部署。
行业影响
落地场景
Pruned CTC 使大词汇 ASR 训练可在有限显存上完成,直接支持:
- 语音助手 / 智能音箱:流式识别低延迟
- 会议转录 / 实时字幕:离线高精度 + 流式低延迟
- 呼叫中心质检 / 语音客服:大词汇量专有名词识别
- 电商平台语音搜索:商品名长尾词覆盖
- 医疗语音录入 / 教育口语评测:领域术语
具体 use case:电商语音客服质检 中,商品名称、促销术语等长尾词需要大词汇量,Pruned CTC 可在单卡训练 180K 词汇模型,内存降低 5.1x,使中小团队也能训练;内容平台自动字幕 利用 LLM-CTC 的非自回归解码,速度提升 7-10x,字幕生成延迟从秒级降到亚秒级,改善用户体验。
商业价值
- 降本:训练内存降低 5.1x,相同 GPU 可训练更大 batch 或更大模型,减少分布式训练需求;推理速度提升 7-10x,单位算力服务更多请求。
- 增收:支持原生大词汇 LLM 作为 ASR 后端,识别准确率与主流 CE 对齐差距在 7% 内,但推理快一个数量级,可承载更高并发语音服务。
- 体验提升:流式场景 WER 与离线差距仅 3%,实时交互更流畅。
与现有栈接口
- 直接替换
torch.nn.CTCLoss或 k2 中的 CTC 实现,作为 自定义损失函数 插入训练循环,无需改模型结构。 - LLM-CTC 提供 readout + attention mask 适配层,可将任意预训练因果 LLM(如 Qwen3)转为 ASR 解码器,保留原生 tokenizer 和 vocab,便于与现有 LLM 推理引擎(vLLM、TensorRT-LLM)集成。
- 开源 PrunedCTC 可直接用于 Icefall / NeMo 等框架。
局限
- **有限束剪枝存在近似误差**:论文引入 finite-beam alignment pruning 来进一步降低计算量,但该剪枝会丢弃部分低概率对齐路径,导致与全词表 CTC 的理论等价性仅在束宽足够大时才近似成立。实际使用中束宽的选择成为精度与内存/计算之间的敏感权衡点。对于长语音或高错误率场景(如噪声、重口音),被剪枝的对齐概率质量可能不可忽略,从而造成梯度偏差,最终影响模型收敛或识别准确率。论文仅在三个常见 ASR 语料上验证,未系统分析不同束宽下的误差传播规律。
- **任务验证范围较窄**:实验全部围绕语音识别(Encoder-based ASR 与 LLM-based ASR),虽然方法本身适用于任意 CTC 序列标注任务,但并未在 OCR、手写识别、手势识别等其他领域进行验证。LLM-CTC 依赖预训练 LLM 的因果注意力结构,对于需要双向上下文的任务可能不适用。此外,尽管激活内存显著降低,LLM 参数量本身仍然巨大,推理阶段仍需加载完整 LLM 权重,部署在边缘设备或内存受限环境时依然面临挑战。
- **与 LLM-CE 基线仍有性能差距**:论文报告 LLM-CTC 在 GigaSpeech 上与 LLM-CE 相比,相对 WER 差距在离线场景为 7% 以内,流式场景为 3% 以内。虽然识别速度快 7-10 倍,但绝对 WER 仍可能逊于交叉熵训练,对于追求极致精度的应用(如医疗、法律转录)可能需要额外微调或混合目标。同时,该方法与特定编码器(Zipformer-M)和 Qwen3 系列强绑定,跨模型架构的泛化性尚待证明。