哪种掩码几何结构最适合 EEG 基础模型?
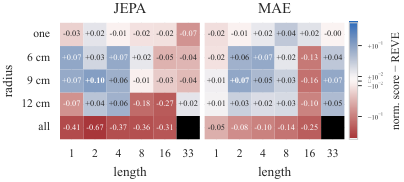
EEG 基础模型 有望在临床与认知神经科学中实现可扩展的脑信号解码,但其预训练流程仍缺乏深入理解。在设计选择中,掩码策略 尤为关键:它决定网络必须预测什么、以及依据何种上下文进行预测。然而该策略从未被单独消融研究——每个新模型往往把新的掩码策略与新的骨干网络、新的目标函数捆绑在一起。 本文形式化了时空掩码策略 的设计选择,并在统一流程下,跨两种 SSL 框架(MAE 与 JEPA)以不同的掩码配置训练模型。随后,我们在 OpenEEGBench 的 12 个数据集上,用线性探测 系统评估了 58 个预训练模型。 两种框架在最优掩码配置与共同失效模式上结论一致。在这些范围之外,性能表现稳健:11 种 MAE 与 9 种 JEPA 配置与最优结果在统计上无法区分。我们进一步发现了一种新的 JEPA 特有失效模式,称为 tagged bias-inflation collapse(标记偏置膨胀坍缩),标准检测器无法察觉。配合精心选择的掩码,我们的流程以远低于 REVE 的预训练算力达到了 REVE 级别的下游性能。
论文精读
TL;DR 系统消融 EEG 基础模型的时空 masking 几何:在统一 MAE/JEPA 管道下发现最优 mask 配置,性能媲美 REVE 且预训练计算量大幅降低,并识别出 JEPA 特有的 bias-inflation collapse 失效模式。
问题
问题背景
EEG 基础模型正成为可扩展脑信号解码的关键技术路径,面向临床与认知神经科学应用。当前社区关注如何通过自监督预训练(如 MAE、JEPA)在大规模 EEG 数据上学习通用表征。
现有方法局限
预训练管道中的掩码策略从未被独立消融。每个新模型发布时,通常同时引入新的 backbone、新的 objective、新的 mask 策略,导致无法判断性能提升真正来自哪个因素。现有工作把 masking 作为附属设计,缺乏对时空掩码几何(空间 vs. 时间冗余、块大小、掩码比例)的系统形式化。这种混杂变量使复现与公平对比困难,也阻碍了对失败模式的归因。
为什么这个问题难/重要
EEG 信号具有高空间冗余(相邻电极)和高时间冗余(短时窗口),掩码策略决定了模型从什么上下文预测什么目标,直接影响表征质量与预训练效率。论文在 MAE 和 JEPA 两个框架上训练 58 个模型,在 12 个数据集上线性探测,发现最优配置之外存在统计不可分辨的区域(11 个 MAE 和 9 个 JEPA 配置与最优无显著差异),还发现 JEPA 特有的 bias-inflation collapse 无法被标准探测器发现。这表明合适掩码能显著降低预训练计算成本,同时达到 SOTA 下游性能。业界关注点在于:通用 EEG 基础模型要落地,需要可复现、可扩展的预训练协议,而不是每次重新发明。
行业类比
类似于视觉 MAE 中 mask ratio 和 patch size 对下游任务的影响,EEG 的掩码几何决定了预训练信号密度,需像选择数据增强策略一样谨慎设计。
核心洞察
- 掩码几何(masking geometry)本身是决定EEG基础模型下游性能的首要因素,独立于SSL框架或骨干架构。 与既往模型将掩码策略与骨干、训练目标捆绑不同,本文首次在受控条件下隔离时空掩码设计,系统扫描空间/时间块形状与比例。实验表明最优几何在MAE和JEPA中一致,且空间冗余比时间冗余对性能影响更大,这归因于EEG多通道之间的高相关性——掩码应优先覆盖高度相关的空间邻居而非单独时间步。
- JEPA框架在EEG掩码预训练中存在一种被称为**bias-inflation collapse**的新失败模式,标准坍塌检测器无法发现。 该模式表现为表征频谱偏向特定频率且方差异常膨胀,但VICReg-style正则项对此不敏感,导致训练看似稳定实则表征退化。MAE因像素重建目标在结构上禁止该快捷路径,而JEPA依赖预测潜变量,易在掩码比例极端时陷入此陷阱。这提示从业者使用JEPA做EEG预训练时需引入额外的频谱/方差监控。
- 精心选择的掩码配置能在显著降低预训练计算成本的同时达到大型模型(如REVE)的下游性能,说明EEG基础模型的性能瓶颈更多在预训练任务设计而非模型容量。 文中58个模型的消融显示,11个MAE和9个JEPA配置与最优表现统计不可区分,证明掩码几何存在一个较宽的合理区间。这一结论对工程部署有直接价值:可通过小规模、短时长的预训练加合理掩码获得可用的通用EEG特征提取器。
方法
输入与预处理
多通道 EEG 信号被切分为时空 patch,经线性嵌入得到 token 序列。预训练数据来自多个公开数据集,统一缩放与分段。
关键模块
共享预训练 pipeline 固定骨干网络(REVE-Small 架构变体),仅改变两个轴:SSL 框架(MAE / JEPA)与 masking 几何。
Masking 策略 由两个参数定义:掩码比例 ρ 与块数量 K,控制时空掩码的块大小与空间/时间分布。采样算法生成可见/掩码 token 索引,保证几何可复现。
MAE 分支:encoder 仅处理可见 token,decoder 重建被掩码 patch,损失为重建 MSE。
JEPA 分支:teacher 网络对完整信号生成目标表征,student 网络基于可见 token 预测 teacher 表征,teacher 参数通过 EMA 更新。额外加入 collapse 诊断,识别 bias-inflation collapse(JEPA 特有失效模式)。
下游评估
冻结预训练 encoder,提取特征后经随机投影降维,用 closed-form ridge 回归做线性 probe。12 个 OpenEEGBench 数据集分数经过跨数据集归一化,并用统计检验比较不同配置。
与同类工作的差异
以往每个 EEG 基础模型都将 masking 策略与 backbone、训练目标捆绑发布,本研究首次在统一 pipeline 下单独消融 masking 几何,系统评估 58 个模型并定位共享最优配置与失效模式。
实验
实验设计
该工作构建统一预训练 pipeline,隔离 masking geometry 与 SSL 框架(MAE 与 JEPA)两个变量,训练 58 个预训练模型,并在 OpenEEGBench 的 12 个数据集上以线性探测评估。masking 策略覆盖空间/时间几何与不同遮挡比例。
关键发现
- 最优 masking 配置在两个框架中一致,共享失败模式。
- 最优配置之外,11 个 MAE 与 9 个 JEPA 配置与最佳结果无统计差异,说明性能对 mask 选择总体稳健。
- 发现 JEPA 特有失败模式:bias-inflation collapse,标准坍缩检测器无法识别。
- 精心设计的 mask 使 pipeline 达到 REVE 级下游性能,且预训练计算量显著降低。
与基线对比解读
该研究首次将 masking 策略单独消融,不同于以往模型将 mask 与 backbone、objective 捆绑发布。与 REVE 对比显示,无需昂贵计算即可达到相当性能,证明 masking geometry 是 EEG 基础模型预训练的关键杠杆。对实际工程而言,优先优化 mask 设计可能比扩展模型或数据更高效。
行业影响
落地场景
论文系统揭示了 EEG 预训练模型中 masking geometry 对下游性能的影响规律,可直接指导脑电分析产品的模型选型。应用场景包括:
- 医疗健康:癫痫发作检测、睡眠分期、麻醉深度监测等临床辅助诊断工具。
- 神经工程:脑机接口(BCI)设备中的运动意图解码、注意力状态识别。
- 企业服务:面向研究机构或企业的脑电数据 API,提供开箱即用的特征提取器。
商业价值
主要沿 降本 路径:最优 mask 配置下,以 REVE 一小部分预训练算力达到同等下游性能(论文原文:"reaches REVE-level downstream performance at a fraction of REVE's pre-training compute")。这意味着企业可以低成本训练自有 EEG 基础模型,摆脱对超大规模预训练资源的依赖;同时,结论中的 11 个 MAE 配置与 9 个 JEPA 配置统计上无显著差异,说明对 mask 选择的容错较高,降低工程调参风险。
与现有产品/工作流的接口
将论文推荐的 mask 配置直接作为 预训练 backbone,接入现有 EEG 分析 pipeline:
- 使用其开源的 GitHub 仓库 预训练模型提取冻结特征。
- 在下游任务上仅训练 线性 probe(或轻量分类头),无需微调整个网络。
- 若需极致性能,可参照论文的 spatio-temporal mask sampling 算法 重新预训练,再配合随机投影 + 闭式 ridge 回归,快速部署到实时 BCI 或云端脑电服务。
注意:论文发现 JEPA 特有的 bias-inflation collapse,部署时应加入对应诊断或直接选用 MAE 框架规避风险。
局限
- - **主干架构与预训练数据单一**:该研究在统一管道中仅使用了一种主干(REVE-Small 级别),且预训练数据集固定,未验证最优掩码几何在其他骨干容量或不同脑电数据集上的泛化性。因此,当从业者更换主干或预训练语料时,所推荐掩码配置的适用性存疑,需要额外实验验证。
- - **下游评估协议有限**:所有模型均采用线性探测在 OpenEEGBench 的 12 个数据集上评估,线性探针可能无法充分反映表示在非线性任务或真实临床分类/回归场景中的潜力。此外,未与更多已发布的 EEG 基础模型(如 BENDR、LaBraM)进行直接对比,仅与 REVE 比较性能,难以全面定位该方法的相对优势。
- - **JEPA 失败模式的检测滞后**:虽然识别出 bias-inflation collapse 这一 JEPA 特有失败模式,但论文提出的检测和缓解措施主要基于事后分析,缺乏在线预训练过程中的实时监测机制。此外,网格搜索的掩码参数(如 mask ratio、block count)组合有限,可能忽略参数间细微交互,最优配置在更大网格或不同随机种子下的稳定性有待进一步检验。