DISCO: 基于接地-推理解耦的分布式长上下文扩展
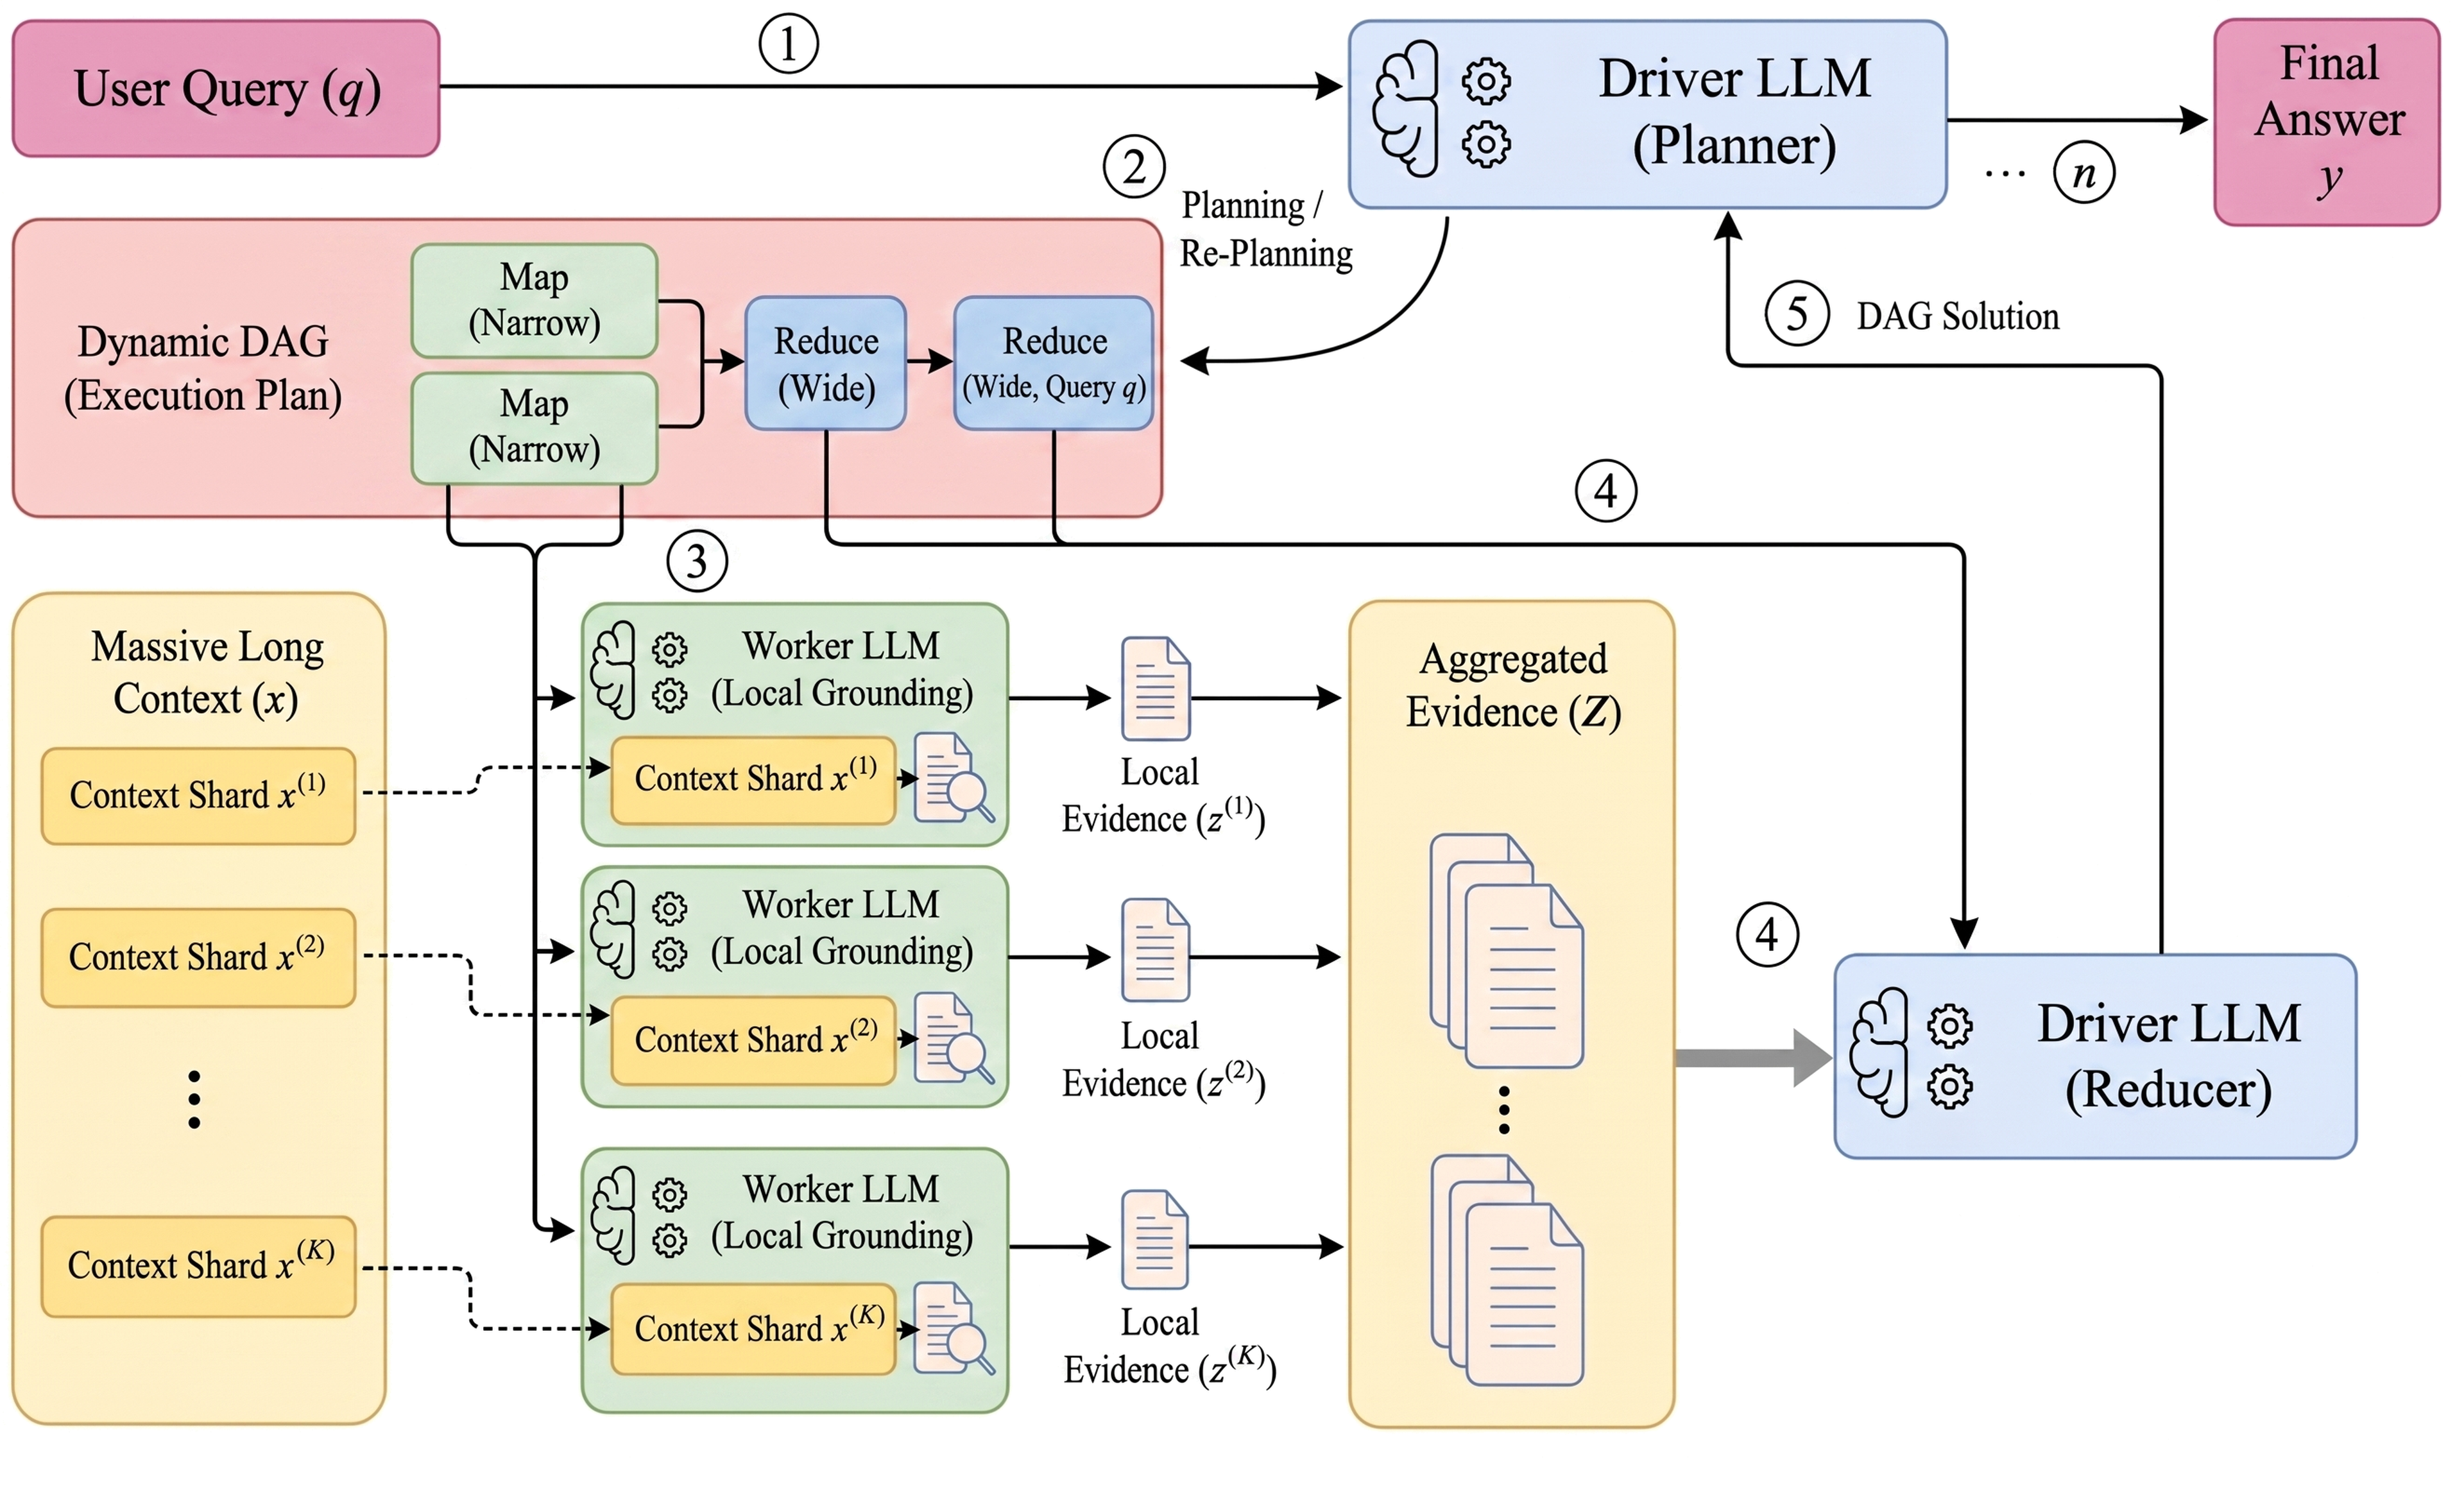
LLM 虽宣称支持百万 token 上下文窗口,但推理质量常随输入增长而崩塌,这一现象被称为 context rot(上下文腐化)。其根源在于单体架构中的结构性纠缠:上下文接地(contextual grounding)带来的巨大搜索负担耗尽了复杂推理所需的表示容量。 为此,我们提出 DISCO(DIStributed long COntext scaling),通过接地-推理解耦来解决该问题。受 Apache Spark 等分布式计算框架启发,DISCO 将长上下文切分到一组 Worker LLM 上,专门负责并行、局部化的接地;一个中心 Driver LLM 通过 Reinforcement Learning(GRPO)训练以优化规划,将查询动态映射为原子抽取任务,并对汇聚的证据进行归约,合成最终答案。通过将推理与原始上下文噪声隔离,DISCO 有效消除了 context rot。 在 RULER-QA(1M tokens)上,当标准基线全面崩溃时,DISCO 仍保持 78.4% 的准确率。此外,它在 LongBench v2 上比全上下文模型高出最多 9.8 分,并与 Gemini-3-Pro-Preview 等前沿模型相当,同时将推理成本降低 80% 以上,为稳健长上下文推理建立了高效范式。
论文精读
TL;DR DISCO 把长上下文分片交给 Worker LLM 并行提取证据,Driver LLM 经强化学习规划并合成答案,解耦 grounding 与 reasoning,在 1M token 上保持 78.4% 准确率且成本降低 80% 以上。
问题
问题背景
近年来 LLM 上下文窗口迅速扩展至百万 token,但长输入下的推理质量衰减问题(context rot)成为阻碍其实际落地的关键瓶颈。
现有方法局限
- 单体模型将证据定位(grounding)与逻辑推理(reasoning)耦合在同一前向过程中,长上下文中大量与问题无关的文本会占据模型表示容量,导致推理能力被显著削弱。
- 传统检索增强方法(如 RAG)虽然能减少输入长度,但稠密检索器在长文档中召回率有限,容易遗漏关键证据;且检索与推理两个阶段缺乏端到端优化,误差会累积。
- 一些分治方法(例如对长文本分块独立处理)缺乏全局规划,无法处理需要跨块综合信息的复杂查询。
为什么这个问题难且重要
- 技术挑战:上下文越长,证据搜索空间指数增长,单体模型很难同时做好局部证据提取与全局逻辑归纳;解耦架构需要设计合理的任务分解与动态调度机制,让模型学会“何时分解、如何汇总”。
- 业界关注度:长文档分析、多跳问答、代码库理解等场景均要求稳定可靠的长上下文推理,同时推理成本与延迟是生产环境中的硬约束,因此高效且鲁棒的解决方案具有极高价值。
行业类比
类似 Apache Spark 将大规模数据处理拆分为 map / reduce 任务并在集群上并行执行,DISCO 把长上下文中的 grounding 拆解为多个 worker 的原子提取任务,再由 driver 汇总推理,可类比于企业级知识库问答中“先定位证据再生成答案”的工程范式。
核心洞察
- Grounding-Reasoning 分离是架构级解耦,而非 prompting 或微调技巧。现有长上下文方法如稀疏注意力、RAG 都在单一模型或检索管道内处理全部信息,注意力稀释导致 reasoning 崩坏(context rot)。DISCO 借鉴 MapReduce 将“定位证据”和“逻辑推理”分配给 Worker 与 Driver 两类模型,从结构上隔离上下文噪声对推理的干扰。Driver 无需读取全部上下文,只需规划与综合,这使得推理质量不再随上下文长度下降,也解释了为何成本与规模解耦。
- 把复杂查询显式建模为 DAG(有向无环图),让长上下文推理成为可并行、可优化的规划问题。DISCO 将查询分解为原子提取任务(Map)与逻辑合成(Reduce),通过迭代细化 DAG 处理证据不足,比隐式的 chain-of-thought 更透明可控。RL 奖励不仅针对最终答案,还包含规划效率 `R_evd` 和结构稳定性 `R_fmt`,促使 Driver 用最少的 Worker 调用获得充要证据。相比 RAG 的 dense retriever,生成式 Worker 在局部 grounding 时具备推理能力,能捕捉检索无法覆盖的语义关联,这是性能超越全上下文模型的关键。
方法
输入为长上下文文档 C 与用户查询 Q。DISCO 将 C 切分为多个局部片段,分配给一组 Worker LLMs;每个 Worker 仅负责在指定片段内执行局部 grounding,输出原子性证据(如实体、关系、事实片段)。中心 Driver LLM 接收 Q,通过 GRPO 强化学习训练的规划策略,将 Q 动态分解为一张 有向无环图(DAG)。DAG 节点分为两类:窄动作(Map) 对应原子提取任务,指定 Worker 从某个片段抽取信息;宽动作(Reduce) 对应逻辑综合,对已收集证据进行归纳、比较或推理。执行时 Driver 调度 Worker 并行完成 Map 任务,把返回的证据汇入 证据池;随后评估证据充分性与 DAG 结构,若不足则进行 迭代式 DAG 精化,补充新的 Map 节点或调整 Reduce 逻辑。最终 Driver 执行 Reduce 节点,从池化证据中合成最终答案。DISCO 的 RL 奖励函数由 证据效率 (鼓励用更少提取步骤获得充分证据)和 结构稳定性 (鼓励生成合法、收敛的 DAG)组成。输出为基于分布式 grounding 证据的最终答案。
与同类方法(如简单 map-reduce 或检索增强)的差异:DISCO 通过 RL 优化的动态 DAG 规划实现 grounding 与 reasoning 的显式解耦,而非固定分块或静态检索管道。
实验
实验设计叙述
DISCO 在 RULER-QA(1M token 超长上下文)与 LongBench v2 上评估,对比标准全上下文模型等基线。采用分布式架构:Worker LLM 并行处理上下文分片,Driver LLM 通过 DAG 分解查询并规划原子提取任务,使用 GRPO 强化学习优化规划策略。评估指标包括准确率与推理开销,并验证了成本与上下文长度的解耦效果。
关键发现
- RULER-QA 1M tokens:DISCO 准确率 78.4%,标准基线因 context rot 性能崩溃。
- LongBench v2:较全上下文模型最高提升 +9.8 分,并匹配 Gemini-3-Pro-Preview 性能。
- 推理成本降低 >80%,分布式架构使成本随上下文长度线性增长而非二次增长。
基线对比解读
标准全上下文模型受限于 Grounding-Reasoning 干扰:长上下文中定位证据消耗大量表示容量,挤压复杂推理。DISCO 通过解耦 grounding 与 reasoning,将定位任务分散到 Worker,Driver 专注规划与合成,从根本上避免 context rot。与 Gemini-3-Pro-Preview 相比,性能相当但成本大幅下降,表明并非依赖更大模型,而是通过架构优化实现高效长上下文推理。
行业影响
落地场景
DISCO 将长上下文推理拆解为分布式 grounding 与中心 reasoning,可落地于企业知识库问答、法律/金融文档审查、电商评论洞察 等场景。例如在电商平台,Worker LLMs 并行提取海量商品评论中的属性与质量反馈,Driver LLM 聚合回答“这款手机实际续航如何”等复杂问题。医疗场景 则可并行检索多份病历与指南,辅助临床决策。
商业价值
- 降本:推理成本降低 80% 以上,长上下文 API 按 token 计费时,用并行小模型替代单次大模型调用,显著削减开支。
- 体验提升:在 1M token 任务上保持 78.4% 准确率,避免上下文腐烂,减少“模型越读越笨”的用户体验问题。
- 扩展性:计算开销随上下文线性增长,Worker 可水平扩容,适合云服务按需调度。
接口与集成
DISCO 可作为编排层 接入现有 LLM 推理栈:长文档切分后交给 Worker LLMs(现有 API 或本地服务),Driver 通过 RL 训练的规划器生成 DAG 子任务,与 LangGraph / DSPy 等工作流框架天然兼容。对现有 RAG 系统,可将“检索+生成”升级为并行召回与逻辑合成,只需替换检索后端为 Worker 集群。推理服务商可封装为托管服务,保持 OpenAI 风格 API 兼容。
局限
- **分布式系统复杂度与训练成本**:DISCO 需要部署多个 Worker LLM 并行执行局部 grounding,虽然单次推理的 token 成本显著下降(论文报告降低 80% 以上),但整体系统引入了多实例管理、任务调度、证据归约等工程开销。Driver LLM 通过 GRPO 训练需要构建带 DAG 轨迹的合成数据集,数据构造和 RL 训练本身需要大量计算与人工设计奖励函数,实际落地时需额外基础设施投入。对于资源受限或追求低延迟的线上服务,这种多机协同的架构可能带来较高的运维复杂度和潜在延迟。
- **Worker grounding 的局限性**:Worker LLM 被设计为仅执行原子提取等 Narrow Actions,这避免了直接处理长上下文,但可能丢失需要全局上下文关联的推理线索。对于需要跨多个证据段落综合、比较或进行复杂逻辑推导的任务,Driver 的 Reduce 阶段若证据不完整或存在冲突,最终答案质量会受影响。此外,动态迭代 DAG refinement 虽能应对部分失败,但引入了多次前向传播,在实时或高并发场景下可能造成不可忽略的延迟,且 Worker 能力不足时会导致提取错误累积。
- **泛化性与同类对比限制**:论文主要在英文 RULER-QA 和 LongBench v2 等基准上验证,与 Gemini-3-Pro-Preview 等闭源前沿模型的对比条件需谨慎解读(如 API 版本、上下文处理细节)。与检索增强或记忆压缩等轻量方案相比,DISCO 依赖多个 LLM 推理,其收益是否在所有长上下文任务类型(如多跳数学推理、代码库理解)上都稳定,仍需更广泛评测。另外,Worker 与 Driver 的模型家族、路由器策略等超参数对性能影响较大,跨领域迁移时可能需要重新训练或微调。