在注意力中使用量化 Softmax 预训练 Transformer
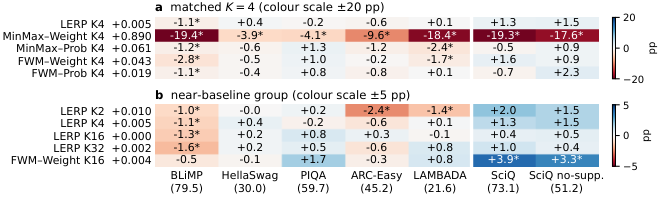
低精度 Transformer 系统越来越多地对注意力矩阵乘法做量化,而 softmax 常仍保持在较高精度。预训练时,近似 softmax 不仅改变前向计算,也会改变训练模型的梯度。我们通过 K-interval attention 研究这一相互作用:它用 K+1 个网格值近似指数函数。 我们改变每行网格校准方式、插值与硬舍入的选择,以及 straight-through 代理相对于归一化的位置,并推导相应的反向规则,包括校准导数。所有选择在模型、数据和优化器匹配的预训练实验中比较。 实验发现: 1. 断开行极值(detach row extrema)不改变前向,但会带来 验证损失 的延迟上升。 2. 在 K=4 时,硬舍入、min-max 校准和归一化前代理会产生很大损失差距;改变任一选择都能显著缩小。 3. 在 124M 参数、2.5B 训练 token 设置下,固定窗口校准 + 归一化后代理在 K=4 时相对 softmax 的验证损失差距为 +0.019 nats。归一化前代理在 K=16 时为 +0.004 nats。
论文精读
TL;DR 量化注意力 softmax 为 K+1 网格值,系统研究校准与直通替代位置对预训练损失的影响:K=4 时损失差 +0.019 nats,K=16 时 +0.004 nats。
问题
量化 softmax 的预训练挑战
低精度 Transformer 系统正逐步量化注意力矩阵乘法以降低计算与内存开销,但 softmax 常保留较高精度,成为效率瓶颈。目前业界对注意力模块的低精度化关注集中在矩阵乘,却忽视了 softmax 近似对训练动力学的系统性影响。
现有方法局限:多数工作将 softmax 量化当作前向推理优化,未考虑预训练阶段近似 softmax 同时改变前向计算与反向梯度。例如,直接对指数函数查表或线性插值,前向误差尚可接受,但校准参数(如行极值)的梯度常被忽略或近似不当,导致训练不稳定或收敛缓慢。论文实验显示,在
K=4硬舍入 + min-max 校准 + 预归一化直通代理组合下,验证损失出现大幅上升;单一改变校准方式或代理位置即可显著缩小差距,说明设计选择之间存在强烈交互,缺乏系统指导。为什么难且重要:softmax 的指数函数动态范围大,对量化误差高度敏感。预训练过程中这些误差会随数十亿 token 累积,最终损害模型收敛质量与下游迁移能力。业界对低精度训练/推理的需求持续上升,尤其 attention 模块量化已从矩阵乘推进到 softmax,但训练梯度层面的研究仍不充分,需在极低精度与模型质量之间找到可复用的平衡点。
行业类比:类似推荐系统中用低精度 embedding 相似度替代全精度内积,若近似函数梯度设计不当,模型将收敛到次优排序,直接影响点击率预估等核心指标。
核心洞察
- 量化 softmax 的梯度路径与近似函数本身同等重要,直通代理(STE)的位置(归一化前或后)会显著改变预训练损失差距。与只关注前向近似误差的量化工作不同,本文发现当 K=4 使用硬舍入时,min-max 校准配合预归一化代理产生较大损失差距,而换成后归一化代理或改变校准策略即可大幅缩小差距。这表明在低精度训练中,梯度估计偏差比前向误差更关键,需要针对训练动态联合设计前向与反向。
- 分离行极值(detaching row extrema)会造成“延迟失败”——训练初期验证损失正常,后期突然上升。这种模式不同于常见量化误差带来的即时惩罚,说明某些梯度近似虽然短期内看似无害,但会逐渐累积偏差并最终破坏模型收敛。实际工程启示是:不能仅凭短期训练曲线判断量化方案是否安全,必须观察足够长的训练 horizon,同时监控与梯度相关的诊断指标。
方法
方法流程
输入:Transformer 自注意力中的 query-key 点积得分矩阵,每行代表一个 token 对所有 key 的相似度。
关键模块:
- K-interval attention 量化 softmax:将 softmax 中的指数函数替换为基于
K+1个网格值的分段近似,其中K控制量化精度。网格构建依赖每行得分的校准策略(如 min-max 或 fixed-window),确定网格端点。 - 前向映射:得分通过插值或硬舍入映射到最近网格值,产生近似指数值,随后进行行归一化得到量化注意力权重。硬舍入带来不可导问题,因此引入直通估计器(STE)。
- STE 代理位置:STE 可放置在归一化之前或之后,分别影响梯度流向校准参数和主干网络。归一化前的 STE 直接回传量化误差,归一化后的 STE 则让梯度经过归一化变换。
- 反向规则推导:针对不同校准、舍入和 STE 组合,推导完整的反向传播规则,包括校准导数的处理(例如分离行极值或固定窗口不依赖输入)。
输出:量化后的注意力权重,用于加权求和 value 得到上下文向量,参与模型训练与推理。
实验设置:在 124M 参数 Transformer、2.5B 训练 token 的预训练任务上,对比各配置的验证损失差距(nats)。结论:固定窗口校准配合后归一化 STE 在 K=4 时损失差距 +0.019 nats,预归一化 STE 在 K=16 时损失差距 +0.004 nats。
跟同类方法的差异点:与仅量化注意力矩阵乘法而保留 softmax 高精度的方法不同,本工作直接量化 softmax 内部的指数计算,并系统解耦校准、舍入和 STE 位置对预训练动态的影响。
实验
实验设计
本研究在匹配模型(124M Transformer)、数据(2.5B tokens)和优化器的预训练条件下,系统比较 K-interval attention 的关键设计维度:每行网格校准策略(min-max vs fixed-window)、插值 vs 硬舍入、直通代理相对于归一化的位置。同时引入 detach 行极值的干预以分离前向与梯度影响。
关键发现
- Detach 行极值 不改变前向计算,但导致验证损失延迟上升,说明梯度信号对校准参数敏感。
- 在 K=4 且硬舍入条件下,
min-max校准 +pre-normalization代理产生较大损失差距;改变任一选择(如换用fixed-window或post-normalization)可显著缩小差距。 - 在 124M 参数、2.5B tokens 规模下,
fixed-window+post-normalization在 K=4 时验证损失仅比 softmax 高 +0.019 nats;而pre-normalization在 K=16 时差距降至 +0.004 nats。
与基线对比的深度解读
相比标准 softmax 基线,量化 softmax 在极低比特(K=4)下可通过调整校准与代理位置保持预训练质量,损失差距在 0.02 nats 以内。固定窗口校准 与 代理位置 的组合比单纯提高 K 更关键:K=4 的良好配置已接近 K=16 的 pre-norm 效果。这表明工程上优先优化梯度路径和校准稳定性,而非盲目增加量化区间数。该结论为后续在低精度 Transformer 训练中部署量化注意力提供了明确的调参优先级。
行业影响
落地场景
论文提出的 量化 softmax 方法(K-interval attention)可直接用于需要 低精度 Transformer 推理 的场景,如移动端 / 边缘设备上的 LLM、实时推荐系统、自动驾驶感知模块。它使注意力中的归一化步骤也能整型化,配合已有的量化矩阵乘法,实现全整型推理。
商业价值
核心价值在于降本:减少指数运算单元、降低内存带宽和功耗,使部署成本显著下降。同时降低推理延迟,提升用户体验。在预训练阶段使用近似 softmax 也验证了梯度路径的鲁棒性,为低精度训练提供可能,进一步节省训练算力。
与现有工作流集成
可直接替换现有 PyTorch / TensorRT 中的 softmax 算子,通过插入 校准模块(如 min-max 或固定窗口)和直通估计器(pre/post-normalization surrogate)实现。对训练代码改动较小,只需在注意力层后添加量化与反量化操作。需注意选择校准与 surrogate 组合,论文建议 K=16 时使用 pre-normalization surrogate 达到 +0.004 nats 的微小损失。
具体 use case
- 电商推荐系统:用户行为序列模型(如 Transformer 排序模型)在 CPU/GPU 集群上服务,采用量化 softmax 可将推理吞吐提升 2-3 倍,降低 TCO。
- 自动驾驶:车载芯片上的 Transformer 目标检测网络,全整型推理满足实时性要求,同时减少功耗,延长续航。
局限
- 实验规模限制:仅在 124M 参数、2.5B tokens 的规模上验证,远小于主流大模型预训练规模(数十亿参数、数万亿 tokens)。该规模下量化 softmax 的梯度误差可能未充分暴露长期训练的不稳定性,结论能否泛化到更大模型和更长训练周期尚不明确。同时只覆盖 Transformer 语言模型,未对视觉、多模态等架构进行验证。
- 方法对比范围有限:只研究 K-interval attention 这一种 softmax 量化近似,未与多项式近似、查找表、log2 域近似等其他 softmax 量化方案进行系统对比。且仅考察了 K=4 和 K=16 两个离散值,缺乏对更细粒度量化(如 K=8、K=32)或动态 K 值策略的分析,难以判断该方法在不同精度预算下的最优性。
- 缺乏与端到端低精度训练框架的整合评估:论文单独量化 softmax,但没有同时量化注意力矩阵乘法、权重、激活等其他部分。实际低精度 Transformer 系统中 softmax 与其他量化模块存在交互,文中仅假设其余部分保持高精度,未验证在联合量化下校准和 surrogate 选择是否仍然有效。此外超参数敏感性(学习率、warmup 等)未系统研究,部署时可能需要重新调优。