SMAT: 简单高效的可合并感知训练
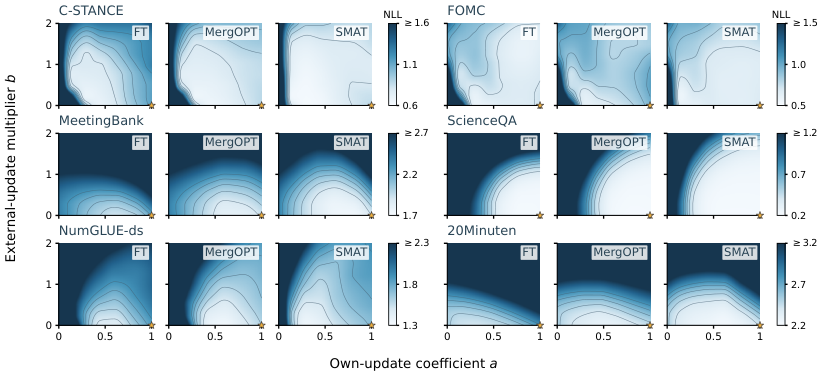
模型合并 能将多个专家模型的能力整合起来,且无需联合重训练;但标准的专家训练只优化任务损失,无法保证合并后的性能。可合并感知训练(MAT)旨在提升合并效果,然而现有方法未充分考虑常见的合并操作,还带来额外训练开销。 从单个专家的角度看,常见合并方法可归纳为三种操作: 1. Scale:重新加权自身的更新量; 2. Mask:移除选定的坐标; 3. Perturb:叠加其他专家的更新。 基于这一视角,作者提出了 SMAT(Simple MAT),在由采样得到的缩放系数、掩码与加性噪声所模拟的合并参数上,联合优化专家损失与期望损失。 为提升效率,SMAT 进一步引入 周期性调度、核融合 与 参数存储切换,使每步仅需一次前向和一次反向传播。在四种语言与视觉语言骨干模型上,SMAT 相对各骨干最强基线,在五种合并方法上的平均得分提升 1.07-2.16 分,而训练时间相比标准微调的开销 不足 2%。
论文精读
TL;DR SMAT 在专家训练中模拟 Scale / Mask / Perturb 三种合并操作,直接优化合并后性能,以不到 2% 训练开销在多个 backbone 上平均提升 1.07-2.16 分。
问题
问题背景
模型合并(model merging)正成为复用多个专家模型、避免联合重训的主流范式,常见操作如 Task Arithmetic、TIES、DARE 等已在多个视觉与语言任务中应用。然而标准专家训练只优化单任务损失,未考虑合并时的参数交互,导致合并后性能明显下降。
现有方法局限
合并感知训练(MAT)尝试在训练阶段引入合并目标,但现有方案存在两个主要不足:
- 覆盖不完整:多数 MAT 方法只针对特定合并规则(如简单平均或 Task Arithmetic)设计,没有系统覆盖主流合并操作。而从专家视角,常见合并方法可归纳为三类操作:
Scale重加权自身更新、Mask删除部分坐标、Perturb注入其他专家更新。仅拟合其中一种,泛化到其他合并算法时效果不佳。 - 训练开销大:现有 MAT 方法通常需要额外前向/反向传播来估计合并后损失,显著增加训练时间与显存,难以在大模型上实用。
为什么这个问题难/重要
技术挑战在于:合并后参数状态由多个专家的更新组合而成,其分布取决于采样系数、掩码和噪声;要有效训练专家对合并鲁棒,需要在每个训练步模拟这些随机合并操作并计算期望损失,但若直接实现会带来多倍计算。SMAT 通过一次前向 + 一次反向即可完成模拟,同时保持 <2% 训练时间开销,表明效率与合并性能可以兼得。业界对模型合并关注度高,因为它能以极低成本组合已有模型能力,提升多任务部署、持续学习和开源模型协作中的可复用性。
行业类比
这一需求类似于 multi-LoRA 推理服务:每个 adapter 在单独训练时表现良好,但被合并到同一个 base model 上时容易出现任务冲突;让 adapter 在训练阶段就感知合并操作,可显著降低上线后的性能回退。
核心洞察
- 从单个专家的视角,常见模型合并操作可统一为三种基本变换:Scale 重缩放自身更新、Mask 移除选定坐标、Perturb 加入其他专家的更新。这个抽象让合并感知训练可以通过采样缩放系数、掩码和加性噪声来模拟多种合并方法,而不需要针对每种合并方案单独设计训练目标。与现有 MAT 方法只考虑特定合并操作或需要复杂模拟不同,SMAT 的模拟方式更通用,且只需一次前向和一次反向传播即可完成训练,大幅度降低了实现复杂度。
- SMAT 的训练目标在专家任务损失之外加入模拟合并参数下的期望损失,使专家训练时直接优化“合并后”的性能,而非仅优化单任务损失。这一角度与标准微调只关注独立任务损失、以及以往 MAT 方法通过复杂正则化或额外模块提升合并性能的做法形成差异。通过周期调度、kernel fusion 和参数存储切换,SMAT 将额外训练时间控制在标准微调的 2% 以内,同时在不同 backbone 上平均提升五种合并方法的得分 1.07-2.16 点,证明在低成本下也能获得显著的合并收益。
方法
输入与核心观察
SMAT 面向模型合并场景,输入为多个独立微调的专家模型。其核心观察是:从某个专家视角,常见合并方法可归结为三类操作——Scale 重新加权自身更新,Mask 移除部分参数坐标,Perturb 注入其他专家的更新。这提供了对合并过程的统一模拟框架。
关键模块:模拟合并参数与训练目标
SMAT 在训练专家时,不仅优化原始任务损失,还额外计算模拟合并参数下的期望损失。具体做法:在每一步中,随机采样缩放系数、掩码模式以及加性噪声,构造出合并后的参数状态;随后在该模拟参数上评估损失。训练目标为联合优化:原始专家损失 + 模拟合并损失的期望。作者通过梯度分析表明,这等同于对专家更新施加了正则,使其对后续合并操作更鲁棒。
工程实现与效率优化
为保证每步仅一次前向和一次反向,SMAT 采用三项技术:
- 周期性调度:并非每步都采样所有模拟参数,而是按周期对缩放、掩码、扰动进行采样,减少计算波动。
- Kernel fusion:融合相关算子,降低内存访问和 kernel 启动开销。
- 参数存储切换:在前向与反向之间高效切换原始参数与模拟参数,避免额外拷贝。
最终输出为训练好的专家模型,可直接用于多种合并方法,且训练时间开销低于标准微调 2%。
与同类 MAT 方法相比,SMAT 不依赖特定合并算子的解析近似,而是通过随机采样统一覆盖 Scale/Mask/Perturb 三类操作,因此更通用且训练开销极低。
实验
实验设计叙述
该研究在 四个语言与视觉-语言骨干网络 上评估,覆盖 五种常见模型合并方法,并与最强基线进行对比。SMAT 在每个训练步骤仅需 一次前向与一次后向,通过周期性调度、核融合、参数存储切换等实现高效训练。训练开销相比标准微调 小于 2%。
关键发现
SMAT 在多个骨干网络上将五种合并方法的平均分数提升 1.07–2.16 点,且训练开销低于 2%。这表明通过模拟合并过程中的缩放、掩码、扰动三种操作,SMAT 能有效优化专家损失与模拟合并参数的期望损失,同时保持计算效率。
与基线对比的深度解读
相比现有 Merge-Aware Training(MAT)方法,SMAT 更完整地模拟了合并操作,并引入了工程优化,避免了额外的训练成本。结果证实,简单高效的设计能够在不增加显著开销的情况下,显著提升合并后性能,对实际部署模型合并有直接参考价值。
行业影响
落地场景
SMAT 可应用于需要频繁合并多个专家模型的场景,例如电商平台的多任务推荐系统(不同商品类目/场景的专家模型合并)、内容平台的多模态内容理解(文本/视觉专家融合)、以及医疗领域的联邦学习(多家机构模型参数融合,无需共享原始数据)。在模型版本管理中,SMAT 训练出的专家在合并后性能更稳定,减少合并后二次微调成本。
商业价值
核心价值在于降低合并后的性能损耗,从而减少为恢复精度所需的额外训练和算力投入。对于需要快速迭代多专家模型的企业,SMAT 仅增加 <2% 的训练时间,但能提升 1.07–2.16 个平均分(论文报告跨 5 种合并方法),直接带来推理效果提升 和 运维成本下降。在个性化服务中,通过合并多个领域专家,可以快速生成适配新任务的模型,缩短产品上线周期。
与现有工作流接口
SMAT 可无缝集成到现有 PyTorch/JAX 训练 pipeline 中,只需在损失函数中加入模拟合并后的期望损失项,并配合周期调度与核融合优化。它与现有合并算法(如 Task Arithmetic、TIES、DARE、Model Soups)兼容,训练出的专家可直接用于这些合并操作。实际工程中,可将 SMAT 作为标准微调的一个可选插件,开启后无需改动模型架构或数据加载逻辑,适合在已有 MLOps 流程中增量部署。
局限
- 模拟分布与真实合并的差异:论文采用预设分布采样缩放系数、掩码和噪声来模拟合并后参数,但无法覆盖所有合并算法(尤其是非线性或自适应合并)。采样超参数(如掩码比例、噪声幅度)的调优依赖任务和模型,增加了开发阶段搜索成本,可能影响方法在未知合并器上的泛化。
- 评估范围有限:实验仅在四个语言和视觉-语言骨干上验证,任务数量与多样性可能不足;且报告的是五种合并方法的平均分提升,未必在每个单独合并方法上均优于最优基线。对更大规模模型或更多专家数量的扩展性有待检验。
- 训练开销与实现复杂度:尽管利用周期调度、kernel fusion 和参数存储切换将额外开销控制在 2% 以内,但这些优化依赖特定框架与硬件,迁移到其他训练栈时需要重新实现;同时 SMAT 要求训练过程中维护并切换参数存储,增加了工程复杂度。