StoryEngine: 一个基于状态锚定的视频叙事智能体框架
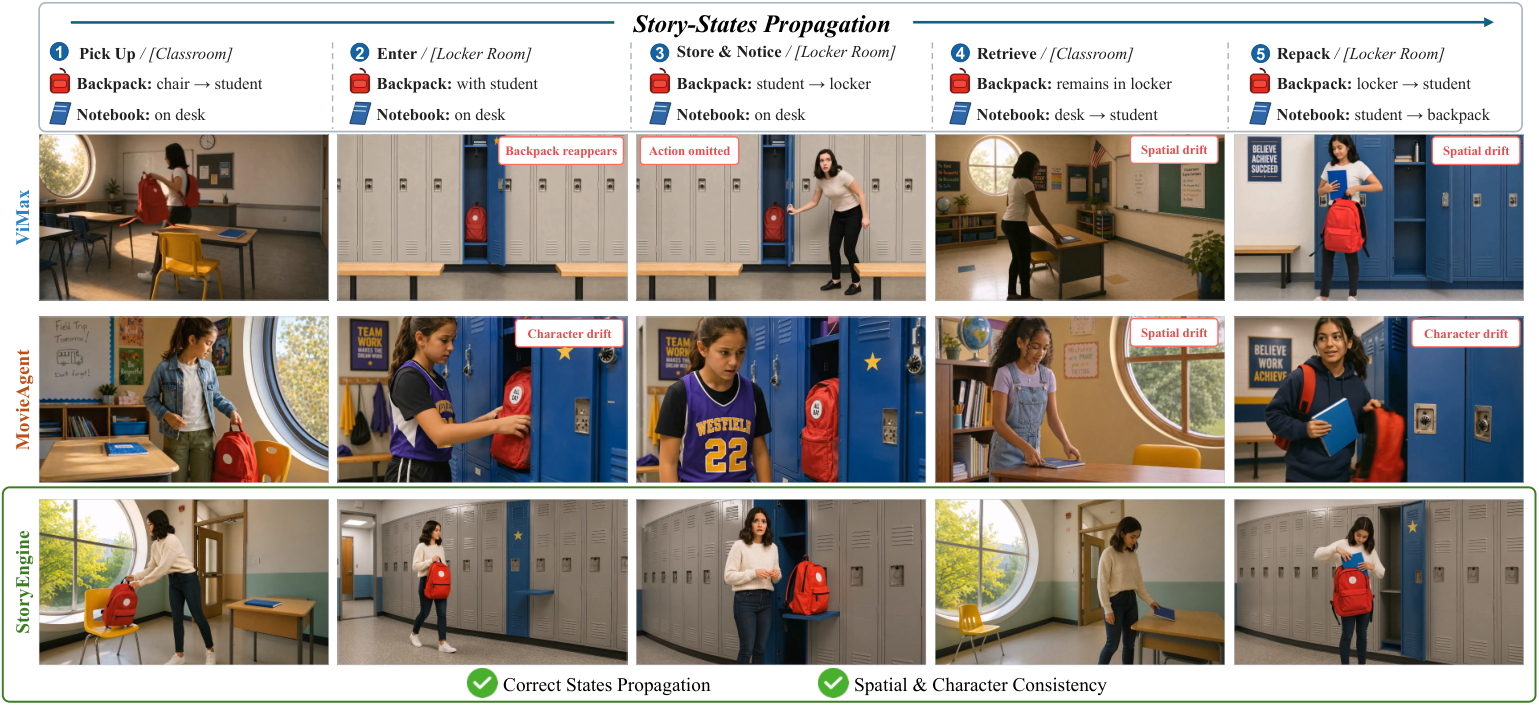
当前 agentic 多镜头视频生成虽已有进展,但生成连贯且一致的长篇故事仍具挑战。现有 agentic 流程通常依赖文本化的镜头规划或此前生成的像素,却缺乏显式机制来传播故事事件的后果、并在镜头之间维护视频世界状态。结果是缺失的视觉细节可能被错误重建,视觉漂移也会在后续镜头中不断累积,损害叙事连贯性与视觉一致性。 为此,我们提出 StoryEngine,一个基于状态锚定的 agentic 视频叙事框架。它的核心思想是在权威语义规划与不可靠视觉观测之间做出分离: - 维护实体位置与故事相关状态的结构化表示,并传播事件引发的状态变化,从而定义每个镜头的预期起始状态与结束状态; - 为反复出现的实体与环境构建规范参考(canonical references),并将状态约束与视觉约束编译为可执行的渲染计划; - 引入有界评估引导的修复循环,进一步纠正局部状态不一致。 这些机制共同保证了故事的因果推进,并阻止局部视觉错误在镜头间传播。为全面评估长篇叙事,我们构建了覆盖多种场景与视觉风格的 benchmark,并从叙事质量、叙事连贯性与视觉一致性等维度进行度量。实验结果表明,StoryEngine 在所有评估维度上均持续优于 state-of-the-art 方法,验证了其在连贯且一致的视频叙事上的有效性。
论文精读
TL;DR StoryEngine 通过显式建模事件驱动的故事世界状态,将语义规划与视觉渲染解耦,并引入评估引导修复,有效抑制长视频叙事中的视觉漂移与状态不一致。
问题
多镜头视频生成 正成为当前视频生成研究的核心方向,agentic 流程被广泛用于规划与执行长篇故事。然而,现有 agentic pipeline 主要依赖文本分镜计划或先前生成的像素,缺乏显式机制传播故事事件的后果并维护跨镜头的视频世界状态。这导致缺失的视觉细节被错误重建,视觉漂移在后续镜头中累积,最终破坏叙事连贯性和视觉一致性。
为什么这个问题难且重要
- 状态维护难:长故事中实体位置、属性、环境随事件不断变化,维护一致的语义状态需要结构化表征与因果推理,而当前方法缺少这种显式建模。
- 视觉漂移累积:局部生成误差(如实体外观、位置)若不被纠正,会沿镜头序列传播,形成全局性偏离,难以回收。
- 业界需求明确:电影、游戏、虚拟制作等领域对长篇视频生成有强烈需求,但一致性不足严重限制应用落地。
行业类比
类似自动驾驶中的世界模型,若不维持场景状态一致性,多帧预测会产生灾难性漂移;StoryEngine 提出 state-grounded 思路,为该问题提供了一条新路径。
核心洞察
- 状态接地作为核心抽象:StoryEngine 将权威语义计划与不可靠视觉观察分离,显式维护实体位置和故事状态,为每个镜头提供可验证的世界状态。 现有 agentic 流程依赖文本镜头计划(如 MovieAgent)或前一镜头像素(如 Direct I2V),缺少全局状态锚点,导致视觉细节错误重构或漂移累积。StoryEngine 的状态接地机制提供了可预测的因果骨架,使得生成过程能够按事件后果更新状态,而非盲目跟随前序输出,显著提升长故事的一致性。
- 事件驱动的状态传播与规范参考修复:StoryEngine 通过事件引起的状态转换定义每个镜头的预期起止状态,并构建实体/环境的规范参考,编译为可执行渲染计划,同时引入评估引导的局部修复循环。 与仅将文本计划作为提示的 baseline 不同,StoryEngine 将事件后果显式编码为状态转换,确保因果进展;而规范参考和修复循环则限制局部错误传播,避免视觉漂移跨镜头扩散。这种设计将“计划”与“执行”解耦,使系统既能保持全局叙事逻辑,又能容忍生成过程中的局部不确定性。
方法
输入与总览
StoryEngine 接收多镜头故事 brief(含情节事件、实体、环境描述),目标是生成连贯的长视频序列。其核心区别在于显式维护世界状态 (world state),将权威语义计划与易出错的视觉观察分离。
关键模块
- Story-State Propagation:通过结构化语义计划(含实体标识符、类型化放置、状态目录)记录每个实体的位置和故事相关属性。根据事件逻辑执行状态转移,推导每个镜头预期的 start/end states,确保因果链跨镜头传播。
- Grounded Render Planning:为重复出现的实体和环境建立canonical asset library,绑定资产与语义标识符;将状态约束和视觉约束编译为可执行的 render plan,并附加 phase-tagged criteria 用于后续验证。
- Continuity-Aware Generation:生成每个镜头后,continuity gate 依据 phase-tagged criteria 检查相邻镜头连续性;若局部状态不一致,触发plan-preserving local repair,在限定预算内执行评估引导的修复,仅修正局部错误而不破坏全局计划。
输出与差异
输出为满足叙事因果推进和视觉一致性的多镜头视频。与传统 agentic pipeline 仅依赖文本 shot plan 或已生成像素不同,StoryEngine 显式建模并传播 world state,防止局部视觉漂移跨镜头累积。
实验
实验设计
StoryEngine 构建了专用 benchmark,包含 N20(narrative realization)、T20(cross-shot coherence)、C20(visual consistency)三个子集,覆盖多样场景与视觉风格。评估指标包括 PEC(Plan Event Coverage)、ECS(Event Completion Score)、APR(Anchor Persistence Rate)、SPS(State Progression Score)、LAR(Location Adherence Rate)、GPC(Geometric Place Consistency)、MIR(Minimum Identity Retention)、LCS(Lighting Coherence Score)。基线选取 Direct I2V、ViMax、MovieAgent,并设置消融变体与 planner sensitivity 分析。
关键发现
实验结果显示 StoryEngine 在所有评估维度上一致优于现有最先进方法,验证了状态接地机制对长视频故事生成的有效性。核心创新在于将 权威语义计划 与 不可靠视觉观测 分离,通过事件驱动的状态传播定义每镜头的预期起止状态,并构建 canonical references 及 render plans,配合评估引导的局部修复循环校正状态不一致。
与基线对比的深度解读
现有 agentic 流水线依赖文本镜头计划或先前生成像素,缺少显式世界状态维护,易导致视觉细节重建误差与视觉漂移跨镜头传播。StoryEngine 的 Continuity Gate 与 Plan-preserving Local Repair 机制从架构上阻断了局部错误累积路径,同时避免全局重规划开销。对实际工程的启示:多镜头生成系统应将状态管理从像素生成器中解耦,以结构化状态和规范资产库作为 grounding,并引入有界修复循环,可显著提升叙事连贯性与视觉一致性。
行业影响
落地场景
StoryEngine 适用于需要长视频叙事自动化的业务场景:
- 电商视频广告: 自动生成多镜头产品故事, 保持产品外观与场景状态连贯, 例如从开箱到使用演示的完整 sequence。
- 内容平台: 批量生产短视频系列、互动叙事或虚拟主播内容, 减少人工分镜与后期。
- 教育 / 培训: 长视频课程中的情节化演示、分步骤操作流程, 保证视觉元素(工具 / 界面)跨镜头一致。
- 企业服务: 产品 Demo、营销叙事与客户成功案例的自动生成。
商业价值
主要作用于 降本 与 体验提升 两条线:
- 降本: 将传统 multi-shot 视频生产中的分镜设计、状态维护、后期修正自动化, 减少人工审核与重拍成本。例如, 一个 5 镜头的产品视频, 人工介入点从每镜头逐一调整降低为仅处理最终异常镜头。
- 体验提升: 通过 状态接地 与 连续性门控, 避免视觉漂移(如物体颜色变化、角色服装不统一), 提升观众完播率与转化。对于内容平台, 连贯的系列故事能增强用户留存。
- 长期可形成 AI 视频生产 API, 按镜头或按故事计费, 带来新的订阅收入。
与现有产品 / 工作流的接口
StoryEngine 可作为 Agentic video generation pipeline 的 中间编排层, 与现有文生视频模型(如 Sora、Runway Gen-3、Veo 等)或开源模型协同。具体集成路径:
- 接入 MCP 或 LangGraph 等 Agent 编排框架, 将
Story-State Propagation、Grounded Render Planning、Continuity Gate封装为可调用节点。 - 输出标准化的 可执行渲染计划(render plan) 与 规范资产库(canonical asset library), 可对接现有后期管线(如 DaVinci Resolve、After Effects 的脚本接口)。
- 通过 bounded evaluation-guided repair loop 提供质量信号, 可作为 CI/CD 中的视频验证步骤, 与现有 A/B 测试或内容审核系统联动。
项目主页: StoryEngine, 代码: GitHub。
局限
- **权威语义计划依赖 LLM 生成,缺乏高层纠错**。框架将 LLM 生成的语义计划视为权威,若计划本身出现事件因果错误或实体状态定义不完整,后续状态传播与渲染将系统性失真。虽然局部修复循环能纠正视觉不一致,但无法挑战或修正计划本身,导致对 LLM 计划质量高度敏感。
- **Canonical visual grounding 依赖有限视觉证据**。实体与环境的规范参考构建需要初始视觉素材或生成资产,对于长故事中未出现或动态变化的实体,可能无法建立稳定参考,导致跨镜头外观漂移。此外,多阶段状态解析、资产绑定和连续性门控增加了显著推理与生成开销,实时性和可扩展性受限。
- **基准与评估覆盖范围有限,指标存在主观性**。N20/T20/C20 基准虽然设计多样,但场景和风格数量有限,可能不代表开放域故事生成;评估指标依赖 VLM 评判,如 PEC、ECS、GPC 等,对视觉细节的判断可能存在偏差或不一致,且部分指标(如照明一致性)定义较粗,难以全面捕捉叙事连贯性。