重新思考 SFT 的 Token 重加权:压制、反转与外推已学特征
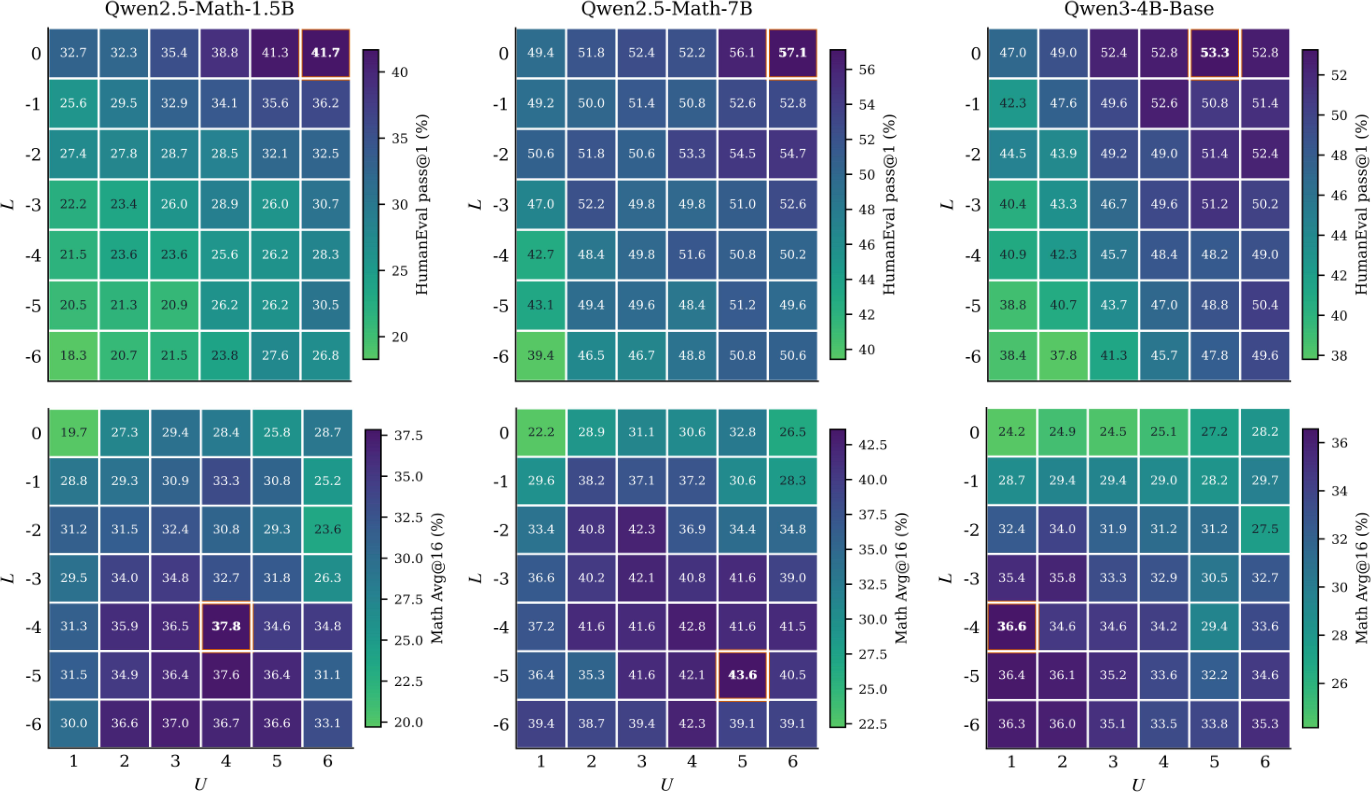
监督微调(SFT)会从模型认为最不可能生成的 token 上学习得最为激进。这有助于获取新行为,但也会放大噪声或冲突监督,并可能覆盖有用的预训练知识。 通过统一的 policy-loss 视角,我们重新审视现有 token 重加权方法,发现它们为被示范的 token 分配的是非负系数。因此,这类方法能够压制或放大监督更新,却无法在有害特征被学到后将其反转。此外,更大的训练权重并不等同于特征外推,因为它改变的是优化轨迹,而非缩放一个固定的 SFT 方向。我们认为,反转与外推需要一个由固定 SFT delta 定义的稳定参考系。 据此,我们提出 SCALE(Selective Control of Adaptation via Local Entropy),一种熵引导的适配强度控制方法:冻结预训练模型与 SFT delta,仅通过最小化预测熵来学习有界的 token 级与模块级门控。这些门控根据与熵降低的对齐程度,对冻结的 SFT 特征进行压制、反转或外推。 在 Qwen2.5-Math-1.5B、Qwen2.5-Math-7B 与 Qwen3-4B-Base 上,SCALE 的数学推理平均分分别达到 37.84、43.60 与 36.57,超过对应的最强基线,同时在通用能力保持基准上仍具竞争力;并在三个模型的 HumanEval、HumanEval+ 与 MBPP 上均取得最佳代码生成平均性能。结果表明,有效的 SFT 校正可以受益于控制已学残差的使用方式,而非仅仅修改其学习方式。
论文精读
TL;DR SCALE 冻结 SFT 增量,用预测熵学习有界 token/模块门控,实现对已学特征的抑制、反转与外推,在数学推理和代码生成上超过强基线。
问题
问题背景
监督微调(SFT)中模型会优先学习预测概率最低的 token,这种特性帮助模型快速获得新行为,但也可能放大噪声标签或覆盖预训练知识。因此,研究者广泛关注如何通过 token 重加权 控制 SFT 的学习强度。
现有方法局限
现有 token 重加权方法(如加权交叉熵、RPO 等)本质上都只在已示范 token 上分配非负系数。这带来两点根本局限:
- 非负系数只能抑制或放大监督更新,无法反转已经学会的有害特征,例如模型曾学到的错误推理模式无法被直接抵消。
- 更大的训练权重并不等价于特征外推。改变权重会改变优化轨迹,而不是在固定 SFT 方向上做缩放,因此无法稳定地获得“比原始 SFT 更强”的特征表达。
为什么这个问题难且重要
实现抑制、反转与外推需要一个稳定的参考系——即一个被冻结的 SFT delta(预训练模型与 SFT 模型参数的差值)。若无此参考系,任何 token 重加权都只是改变学习过程,而非直接操控已经学到的残差。此外,如何从熵减少的角度判断哪些 token-模块组合应当增强、抑制还是反转,涉及离散门控与训练稳定性,是一个高度非平凡的问题。业界对模型后训练阶段的可控性与可靠性日益关注,该问题直接影响下游任务表现与知识保留。
行业类比
该问题类似于大型语言模型适配到代码生成场景时,需要在不破坏通用推理能力的前提下纠正特定错误模式,本质上是对已学特征做精细的“增益/抵消/超调”控制。
核心洞察
- - 熵作为带符号的策略损失,使无标签的熵最小化能够指导对已学习 SFT 特征的选择性控制。SCALE 将预测熵视为 token 级策略损失的符号化代理,在第二阶段仅凭熵减少来学习门控,无需额外监督标签。相比传统 token reweighting 依赖非负系数只能放大或抑制监督更新,SCALE 通过有界门控实现对冻结 SFT delta 的抑制、反转与外推,突破了不能反转有害特征的限制。
- - 冻结 SFT delta 并提供有界门控,使模型能够在推理时动态控制已学习残差的使用,而不是重新改变学习过程。现有方法如 model editing 或 delta 缩放通常在训练阶段修改 delta 本身,而 SCALE 保持 delta 固定,学习 token 与 module 特定的 signed gates,从而将控制问题从“如何学习”转变为“如何使用已学习的知识”。这带来了参数效率和泛化优势,且与保留通用能力兼容。
方法
输入
- 预训练模型
θ_pretrained - SFT 任务数据(数学推理 / 代码生成)
- Stage I 产出的 SFT delta
Δθ
关键模块
Stage I:学习任务 delta
在目标数据上执行标准 SFT,得到参数变化量 Δθ = θ_SFT - θ_pretrained,随后冻结 θ_pretrained 与 Δθ。
Stage II:identity-centered signed gates
仅训练轻量 gate 参数,对每个 token 和每个 module 的 Δθ 分量引入带符号、有界的缩放系数 g,允许 g < 0(反转特征)、g = 0(抑制特征)、g > 1(外推特征)。训练目标为最小化响应前缀上的预测熵(predictive entropy),不依赖额外标注或奖励信号。gate 初始化在恒等映射附近,保证训练稳定。
输出
最终推理模型权重由预训练权重加上门控调制的 delta 得到(g 与 delta 逐元素相乘)。该模型在数学推理与代码生成任务上输出修正后的 token 分布,避免 SFT 对噪声或有害特征的过度放大。
与同类方法的差异点:传统 token reweighting 只能对监督更新施加非负系数,无法反转已学特征;SCALE 冻结 delta 并引入可负可大于 1 的 gate,在固定参考系下实现真正的 suppression、reversal 与 extrapolation。
实验
实验设计
SCALE 在 Qwen2.5-Math-1.5B、Qwen2.5-Math-7B、Qwen3-4B-Base 上评估。分两阶段:Stage I 学习 SFT delta;Stage II 冻结预训练模型与 delta,仅通过最小化预测熵学习有界 token- 和 module- 级门控,实现抑制、反转或外推已学特征。
关键发现
数学推理平均分分别达到 37.84、43.60、36.57,均超过对应最强基线。代码生成在 HumanEval、HumanEval+、MBPP 上取得三模型最佳平均性能,且通用保留基准保持竞争力。
与基线对比解读
与现有 token reweighting(均为非负权重)不同,SCALE 引入有符号门控,可反转有害特征而非仅抑制或放大;冻结 delta 提供稳定参考系,实现特征外推,而非仅改变优化轨迹。工程启示:冻结 SFT delta + 可学习门控可作为轻量后训练修正手段,避免大规模重训,且无需奖励模型,仅用熵信号即可筛选有效特征。
行业影响
落地场景
- 数学推理助手:在教育科技与在线解题产品中,SCALE 可对 SFT 后的 Qwen 系列模型进行熵引导的修正,提升数学推理准确率(如 Qwen2.5-Math-7B 平均 43.60),同时维持通用能力。
- 代码生成服务:用于 Copilot 类代码补全或企业级编程辅助,通过逆转低质量样本习得的有害特征,改善 HumanEval/MBPP 等基准表现,减少错误代码建议。
- 企业知识库问答:在领域 SFT 后应用 SCALE,可抑制冲突监督信号,避免覆盖预训练知识,适合金融、医疗等对准确率敏感的场景。
商业价值
- 降低再训练成本:冻结预训练模型与 SFT delta,仅训练轻量 gates,无需重新 SFT 或全量调整,大幅节省 GPU 时间与数据标注开销。
- 提升用户体验与留存:数学与代码任务性能直接转化为产品力,例如教育平台解题正确率上升可提高付费转化;代码工具误差减少可降低用户流失。
- 降低风险:逆转有害特征可减少模型输出错误或不符合安全规范的内容,降低合规与售后成本。
与现有产品/工作流集成
- 作为 SFT 后处理阶段:在现有 SFT 流水线后增加 Stage II,基于 frozen delta 训练 entropy-guided gates,兼容 PyTorch / Hugging Face Trainer,无需重构训练栈。
- 参数高效且易插拔:只增加少量 gate 参数,可与 LoRA / QLoRA 等并存,存储和推理开销小,适合在线服务部署。
- 无需额外标注:仅需 response prefix 上的预测熵作为训练信号,数据稀缺场景也可快速接入。
具体 use case
- 电商智能客服:对商品问答模型进行领域 SFT 后,用 SCALE 逆转从错误标注中习得的冲突特征,减少错误推荐与答非所问。
- 自动驾驶规划模块:在基于 LLM 的路径规划推理中,通过 SCALE 抑制噪声监督、外推可靠逻辑特征,提升复杂场景下的决策稳定性。
局限
- **两阶段训练带来额外复杂度和依赖**:SCALE 需要先训练一个高质量的 SFT delta,再冻结并学习 gates。这增加了训练流程的步骤和计算开销,且最终性能上限受限于初始 delta 的质量。如果初始 SFT 已严重学到有害特征,SCALE 只能通过 gates 选择性地抑制或逆转这些特征的使用,无法从源头修正 delta 本身的缺陷。
- **实验任务范围较窄,熵信号的有效性存疑**:论文仅在数学推理和代码生成任务上验证,这两类任务具有明确的客观正确性,预测熵与任务性能的对齐较为可靠。但对于开放式生成、创意写作、对话等主观或低熵任务,熵减少是否仍能有效指导 gates 的选择尚未得到验证,SCALE 的泛化能力可能受限。
- **与在线重加权方法相比,SCALE 属于后处理校正**:它不能直接改善 SFT 训练过程本身,无法在有害特征被学习时就及时干预。此外,冻结 SFT delta 并额外学习 token- 和 module-specific gates 会增加模型部署时的存储和计算开销,且 gates 在不同数据分布下的鲁棒性仍需进一步检验。