TT-VidT:解耦时间轴以实现高效的运动中心视频预训练
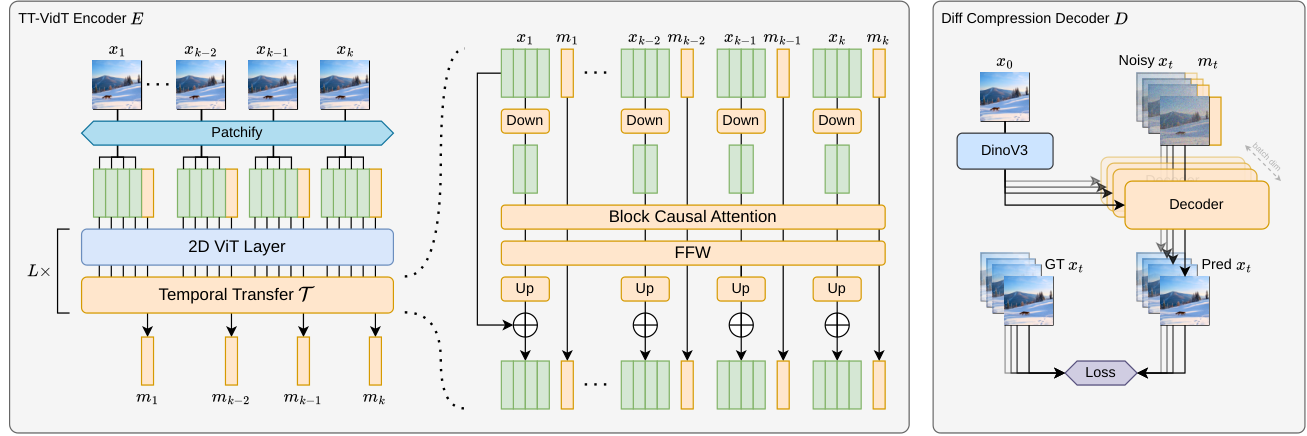
视频自监督学习中的对比实验常评估完整训练配方,而非隔离方法本身:架构、目标函数、数据曝光、调度、规模与解码器容量都可能同时变化,令人难以辨别哪些选择真正产生了以运动为先的表征——其收益集中于帧间变化,同时保留有用的外观信息。 为此,我们在约 170M 190M 编码器规模下,于 sim1.7M OpenVid 与 Moments-in-Time v2 片段上训练 8 个 epoch,开展了匹配的 4 × 6 = 24 组架构-目标研究,并提出 TT-VidT。该方法将 DINOv3 初始化的 ViT-B/16 逐帧空间路径与紧凑的 Temporal Transfer Layer 结合,通过 Diff Compression 从首帧外观锚点与帧特定运动 token 重建目标帧。 扫描结果表明:TT3D 与 Diff Compression 的组合——而非任一组件单独作用——才进入最强的运动敏感区间;解码器消融则偏好紧凑的视频预训练解码器。 最终对比中,TT-VidT 在 Jester、Something-Something V2、ARID 与 Diving48 微调上同时领先,较最强非 TT 基线提升 54% 121%,编码器 FLOPs 比 DisMo 少 48%、比 VideoMAE 或 V-JEPA2 少 55%。HMDB51、IARD 与 EPIC-Kitchens 界定了该结论的适用范围。
论文精读
TL;DR TT-VidT 将视频预训练的时间轴解耦为 DINOv3 逐帧空间路径与紧凑 Temporal Transfer Layer,用 Diff Compression 从首帧锚点重构目标帧,以更少 FLOPs 获得运动优先表征,在多个动作识别基准上领先。
问题
问题背景
视频自监督学习领域当前关注如何获得 运动优先表示(motion-prioritized representation),即在下游任务中同时保留物体外观与帧间运动信息,尤其对细粒度动作识别至关重要。
现有方法局限
主流视频预训练方案(如 VideoMAE、V-JEPA、DisMo)在对比评估时通常将架构、训练目标、数据曝光量、训练时长、解码器容量等多个变量同时改变,导致无法归因于具体设计为何有效。此外,多数方法对时空联合建模,未显式解耦时间轴,容易产生 外观捷径(appearance shortcut),模型依赖静态背景或物体身份即可通过某些基准测试,而运动敏感的性能提升被掩盖。同时,这些模型编码器计算开销大,难以在资源受限场景部署。
为什么这个问题难/重要
视频中外观与运动高度耦合:单帧图像同时包含物体类别和姿态信息,分离二者需要额外结构或训练信号。设计运动优先的表示面临两个技术挑战:一是如何在保留外观特征的同时增强对帧间变化的敏感性;二是如何设计可扩展的轻量时序模块,避免显著增加 FLOPs。业界对高效、运动中心的视频预训练方法有持续需求,因为动作识别、视频异常检测、机器人操作等任务的核心判别线索是运动而非静态外观。
行业类比
类似于视频监控中的 异常行为检测:如果模型只提取每帧外观特征而忽略时间变化,就难以区分正常行走与突然跌倒,必须显式注入运动 token 才能捕捉关键动态。
核心洞察
- TT-VidT 将时间建模与空间特征提取解耦,通过 DINOv3 初始化的 ViT-B/16 逐帧空间路径和紧凑的 Temporal Transfer Layer,结合 Diff Compression 学习运动令牌。与 VideoMAE、V-JEPA2 等需要大规模时空联合编码的方法相比,该设计大幅降低编码器 FLOPs(分别少 55% 和 48%),同时保持运动敏感任务的领先性能。这种解耦允许重用强大的图像预训练特征,仅需轻量时间适配,为资源受限的视频自监督场景提供了高效替代方案。
- 论文通过匹配的 4×6=24 架构-目标消融研究,隔离了架构、目标、数据暴露、调度等因素,证明 TT3D 与 Diff Compression 的组合才能进入最强运动敏感机制,单独使用任一组件不足。这纠正了视频自监督领域常见的方法比较混杂问题,为后续研究提供了可靠的实验基准。此外,紧凑的视频预训练解码器优于图像预训练解码器,表明解码器的预训练领域对最终表征同样关键,这一发现对实际工程中的模块选择具有直接指导意义。
方法
输入与空间编码
输入为视频片段。使用 DINOv3 初始化的 ViT-B/16 逐帧提取空间特征,得到每帧 patch token 序列;同时选取第一帧作为外观锚点(appearance anchor)。
关键模块:Temporal Transfer Layer
引入紧凑的 Temporal Transfer Layer(TTL),对帧间特征进行时序建模,生成每帧特定的 motion tokens。TT3D 是联合空间-时序混合的变体,在架构-目标消融中与 Diff Compression 组合展现出最强运动敏感表现。
训练目标:Diff Compression
以第一帧外观锚点和各帧 motion tokens 为条件,通过 Diff Compression 损失重构目标帧。该目标迫使网络将外观与运动信息解耦,且 motion tokens 必须携带充分的时序变化,从而得到运动优先的表示。
输出与效率
输出为运动中心化特征,在 Jester、Something-Something V2、ARID、Diving48 等运动敏感基准上同时领先,且编码器 FLOPs 比 DisMo 低 48%,比 VideoMAE 或 V-JEPA2 低 55%。
与多数工作同时变动架构、目标、数据、解码器容量等完整配方不同,TT-VidT 通过受控扫描证明 TT3D + Diff Compression 是进入最强运动敏感区域的关键,并以紧凑时序模块解耦时间轴,避免大容量视频编码器的高计算开销。
实验
实验设计
作者进行匹配的 4×6=24 架构-目标扫描研究,在约 1.7M 的 OpenVid 和 Moments-in-Time v2 视频片段上训练 8 个 epoch,encoder 规模 170M~190M,控制变量以隔离方法本身。提出 TT-VidT,结合 DINOv3 初始化的 ViT-B/16 逐帧空间路径和紧凑 Temporal Transfer Layer,通过 Diff Compression 训练,从第一帧外观锚点和帧特定运动 token 重建目标帧。
关键发现
- 扫描显示 TT3D 与 Diff Compression 结合,而非任一单独组件,进入最强运动敏感机制。
- 解码器消融表明紧凑的视频预训练解码器更优。
- 最终比较中,TT-VidT 在 Jester、Something-Something V2、ARID、Diving48 四个运动中心数据集上同时领先,相对最强非 TT 方法提升 54%~121%。
- 同时 encoder FLOPs 比 DisMo 少 48%,比 VideoMAE/V-JEPA2 少 55%。
- 在 HMDB51、IARD、EPIC-Kitchens 等外观主导数据集上优势有限,表明方法偏向运动表征。
与基线对比解读
与 DisMo、VideoMAE、V-JEPA2 等相比,TT-VidT 通过解耦时间轴,用第一帧外观锚点显式建模运动 token,在显著降低 FLOPs 的同时实现更高运动敏感性。效率优势来自紧凑的时间转移层,避免重型 3D 卷积或全帧注意力。此外,4×6 扫描实验揭示了架构-目标协同的重要性,提示从业者应关注方法本身而非完整训练配方。
行业影响
落地场景
TT-VidT 提供的运动中心、高效视频表征适合对时序动作敏感的产品。典型 use case 包括:
- 电商直播:识别主播手势、商品展示动作,用于实时特效触发与违规检测。
- 教育科技:技能教学视频中评估学员动作规范性,如体育训练、实验操作。
- 监控与安全:基于 ARID 类异常行为检测,降低误报。 此外,Jester 和 Something-Something V2 等数据集覆盖的手势交互可用于 AR/VR 界面。
商业价值
核心降本来自 encoder FLOPs 的大幅降低(比 DisMo 少 48%,比 VideoMAE/V-JEPA2 少 55%),在不显著牺牲精度的条件下可减少云推理成本或支持边缘部署。运动优先表征能提高动作细粒度任务的准确率,减少从零标注或大规模预训练成本。对内容平台,这直接改善推荐相关性、互动体验及广告转化。
与现有工作流的接口
- 作为即插即用 backbone:替换现有视频理解模型中的 encoder(如 VideoMAE、V-JEPA2),输出 token 可直接接入下游分类/检测头。
- 利用 DINOv3 图像预训练权重初始化空间路径,与现有基于 ViT 的图像特征提取管线兼容。
- Temporal Transfer Layer 模块小巧,可轻量集成到已有推理框架,无需重写数据加载或训练 pipeline。
局限
- **数据集泛化边界明确**:论文在 HMDB51、IARD、EPIC-Kitchens 上表现受限于声明,说明 TT-VidT 的 motion-centric 优势在 appearance-heavy 或长时序复杂场景中并不稳固。工程上,若下游任务侧重静态外观或场景分类,需重新评估该预训练是否比通用视频预训练(如 VideoMAE)更合适。
- **训练规模与模型大小单一**:实验仅使用 ~1.7M 片段、8 epochs、ViT-B/16 编码器,未验证更大模型或更长训练。实际部署中,Temporal Transfer Layer 的扩展性和对高分辨率视频的适配性未知。与其他大规模视频预训练(如 V-JEPA2)相比,数据规模和训练时长均较保守。
- **依赖 DINOv3 初始化与 decoder 选择**:TT-VidT 的 per-frame 路径完全依赖 DINOv3 初始化,若更换为其他图像预训练权重,Diff Compression 和 TT3D 的效果可能改变。同时 decoder 消融只比较了紧凑视频预训练 decoder,未探索更灵活的 decoder 结构,该方法对 decoder 容量的敏感性可能限制实际调优。