面向机器人操控的跨智能体递归 Harness 蒸馏
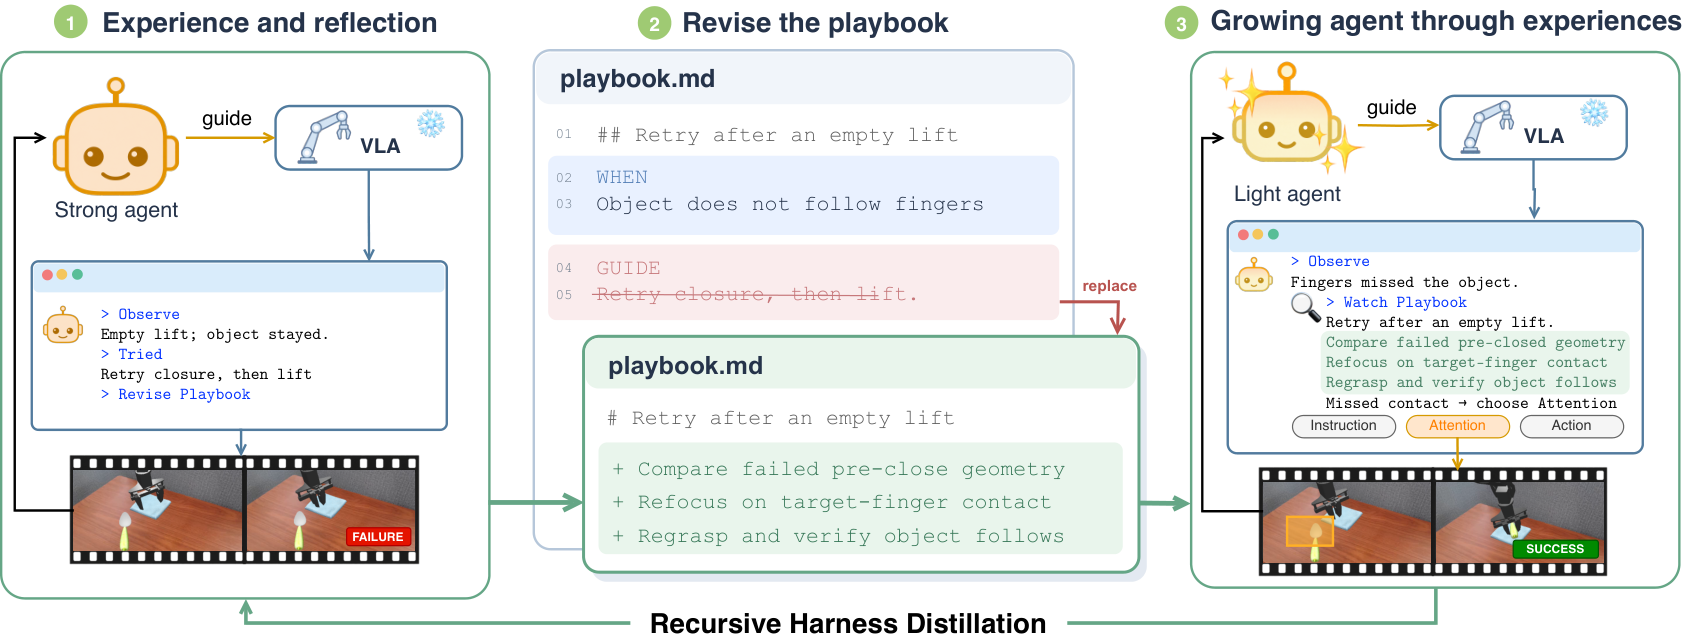
机器人领域的核心目标之一,是让机器人在不断变化的任务与环境中完成操控。视觉-语言-动作(VLA) 模型虽具备广泛的操控能力,但当执行过程需要诊断失败并调整行为时,往往表现不佳。 强智能体可以通过与这些策略交互,发现有效的干预手段。我们提出 Recursive Harness Distillation,把这类经验积累为可跨智能体复用的指导:强智能体先将自身经验蒸馏成一份供轻量智能体使用的 playbook,再依据轻量智能体的执行反馈递归地精炼该 playbook。由此得到的 playbook 使智能体无需更新模型参数,即可在新任务实例中复用积累的干预知识。 在真实世界操控任务中,harness 将成功率从 37.3% 提升到 64.0%。在 SimplerEnv Bridge 上,带 playbook 的轻量智能体取得 66.7% 成功率,而仅用 GR00T 的基线为 41.7%,且优于不带 playbook 的强智能体。同一份 playbook 也能帮助强智能体,使其成功率达到 79.2%。 这些结果证明了 harness 蒸馏 在机器人领域的可行性:干预经验可以被积累、通过执行不断精炼,并跨智能体复用以提升操控表现。
论文精读
TL;DR 提出 Recursive Harness Distillation,将强 agent 的干预经验蒸馏为可递归精炼的 playbook 并跨 agent 复用,无需更新模型参数,真实世界操作成功率从 37.3% 提升至 64.0%。
问题
机器人操作领域正从单一任务策略转向 Vision-Language-Action (VLA) 模型的通用操控能力,但这类模型在长程任务或环境变化时,往往缺乏诊断失败并自适应调整的能力。现有方法主要依赖专家干预、语言反馈或强化学习微调:专家干预成本高且难以规模化;语言反馈通常是一次性提示,无法沉淀为可复用的经验;微调则需更新模型参数,部署风险大且不灵活。此外,强智能体(如多模态大模型)能够通过交互发现有效干预,但这些干预知识隐式、依赖具体执行上下文,缺乏系统化提取和跨智能体迁移的机制。该问题的难点在于:干预经验本质上是过程性、片段化的,难以形式化为可共享的 playbook;同时递归蒸馏需在轻量智能体的执行反馈中迭代修正,必须平衡信息压缩与执行保真度。业界高度关注不更新模型参数即可提升操作成功率的方法,因为它能降低部署成本并快速适应新任务,与工业界对大模型 tool-use 或 prompt engineering 经验库的探索形成类比。
核心洞察
- 通过蒸馏干预经验为可复用 playbook,而非更新模型参数,实现跨任务和跨 agent 的持续改进。与传统 VLA 微调或 prompt 工程不同,该方法将强 agent 在交互中发现的干预策略凝练为结构化知识(playbook),轻 agent 直接调用,无需重新训练底层模型。这避免了灾难性遗忘和部署成本,且 playbook 可跨 agent 复用,在实验中同时提升轻、强 agent 成功率,说明干预知识可与具体模型解耦。
- 递归利用轻 agent 执行反馈优化 playbook,形成闭环迭代,而非一次性蒸馏。初步 playbook 来自强 agent 经验,但通过轻 agent 实际执行后的反馈递归修正,能发现仅靠强 agent 单次观察难以覆盖的失败模式。这一机制类似 data flywheel,但针对策略级指导而非模型权重,使得轻 agent 在不更新参数的情况下持续进化,并最终反哺强 agent,揭示了干预知识可自举优化的工程路径。
方法
方法核心流程
输入:任务指令、环境观测、VLA 策略的实时执行状态(当前动作、视觉输入、历史交互记录)。
关键模块:
干预生成
强代理(strong agent,具备诊断能力的多模态模型)与 VLA 策略交互,当检测到执行偏离目标或即将失败时,生成干预信号(例如重新规划子目标、调整抓取位姿、触发重试)。干预信号可以是文本指令或动作修正。Playbook 蒸馏
将强代理的干预经验(状态→干预的映射)蒸馏为轻量代理可查询的 playbook。Playbook 以规则条目、提示模板或轻量检索结构存储,轻代理在新任务实例中只依据当前状态查询 playbook,无需访问强代理。递归蒸馏循环
轻代理使用当前 playbook 实际执行任务,收集成功/失败反馈。失败案例被送回强代理,强代理分析错误后补充或修正 playbook 条目,再将更新后的 playbook 部署回轻代理。该循环递归进行,直到 playbook 在验证集上收敛。
输出:一个无需更新 VLA 模型参数、可跨代理复用的 playbook。推理时轻代理或强代理均可调用该 playbook 对 VLA 输出进行干预,提升任务成功率。
差异点:相比于直接微调 VLA 权重或一次性提示工程,RHD 将干预经验显式累积为外部知识库,通过递归执行反馈持续精化,实现低成本、可转移的跨代理能力提升。
实验
实验设计
RHD 在两类环境验证:真实世界机器人操作任务和 SimplerEnv Bridge 仿真基准。轻量 agent(GR00T-only)搭配蒸馏 playbook 与强 agent 对比;强 agent 自身也测试使用 playbook 的增益。递归过程从强 agent 干预经验蒸馏出 playbook,再基于轻量 agent 执行反馈迭代优化。
关键发现
- 真实世界成功率从 37.3% 提升至 64.0%(+26.7 个百分点)。
- Bridge 上轻量 agent 带 playbook 达 66.7%,远超 GR00T-only 基线 41.7%,且超过无 playbook 的强 agent。
- 同一 playbook 使强 agent 达 79.2%,说明干预知识可跨 agent 复用。
基线对比解读
轻量 agent 单独执行 VLA 策略容易失败,而通过 playbook 固化的干预经验显著弥补短板;有趣的是轻量 agent + playbook 甚至超越无 playbook 的强 agent,表明蒸馏的 playbook 比单一强 agent 的在线干预更稳定,可能因为递归优化捕获了更泛化的执行策略。强 agent 使用 playbook 进一步提升,说明多 agent 间经验萃取不限于弱智能体。
行业影响
落地场景
- 仓储物流机器人:强 agent 的诊断干预经验可沉淀为 playbook,指导轻量 VLA 模型处理复杂抓取、分拣任务,减少现场调试和人工介入。
- 家庭服务机器人:面对多样化家居环境,playbook 积累的失败恢复策略可提升长时操作成功率,无需每户重新训练模型。
- 工业装配 / 医疗辅助:需要精确诊断与干预的场景,也可复用跨任务干预知识。
商业价值
- 降本:避免为每个新任务或环境微调 VLA 模型(省 GPU 训练成本),并降低人工远程干预频次。
- 体验提升 / 增收:真实世界成功率从 37.3% 提升至 64.0%,直接提高机器人可用性,缩短 ROI 周期。轻 agent 在 SimplerEnv Bridge 上从 41.7% 提升至 66.7%,说明低算力部署也能获得显著收益。
与现有工作流接口
- RHD 以 harness 层 形式包裹现有 VLA 策略,不改动模型参数,易于集成到机器人控制栈。
- 可将 playbook 作为中间件,实时查询干预建议,类似规则库或外部记忆。
- 与云边协同结合:强 agent 在云端生成 / 更新 playbook,轻 agent 在端侧执行并回传反馈,形成闭环。
具体案例
- 电商仓储:某电商仓库部署 GR00T 类 VLA 模型进行商品分拣,频繁出现抓取失败需人工介入。引入 RHD 后,强 agent 在少数样本上生成 playbook,轻 agent 执行时查询干预策略,将分拣成功率提升 20+ 个百分点,减少人力成本。
- 家庭清洁机器人:多户型环境切换时,机器人常因路径或操作失败停止。借助 playbook 累积的跨场景干预经验,机器人能自动诊断并调整行为,降低返修率。
局限
- **评估基准较为狭窄**:实验主要在真实世界操作任务与 SimplerEnv Bridge 单一模拟环境上进行,未在更广泛的任务类别、不同 VLA 模型基座或更复杂的多阶段长程操作中验证。真实世界实验的样本量与重复次数也未明确报告,可能影响结果统计稳健性。与同类工作(如参数微调、上下文学习)的跨环境对比不足,playbook 的通用性结论尚需更多证据支撑。
- **递归蒸馏的交互成本与效率未充分量化**:方法依赖强代理通过在线交互发现有效干预,但论文未报告所需的探索轮次、环境交互次数或人工监督程度。若强代理需要大量试错才能生成高质量 playbook,部署前的准备成本可能很高,阻碍快速迁移。同时缺少与端到端微调、检索增强生成等参数高效策略的成本——收益系统比较,难以判断在实际工程中的投入产出比。
- **playbook 的泛化性与可扩展性存疑**:playbook 本质是静态的文本化规则或干预策略,面对开放世界中的长尾场景或显著分布偏移时可能失效。递归蒸馏的离线批量更新机制无法在线适应动态变化的任务环境,且轻量代理过度依赖 playbook 可能引入新的故障模式(如错误触发干预、忽略关键视觉线索)。与 learnable 参数更新相比,固定知识表达在复杂连续控制中的容量上限未做深入分析。