TimeBraid:统一时间序列与语言,实现理解与预测
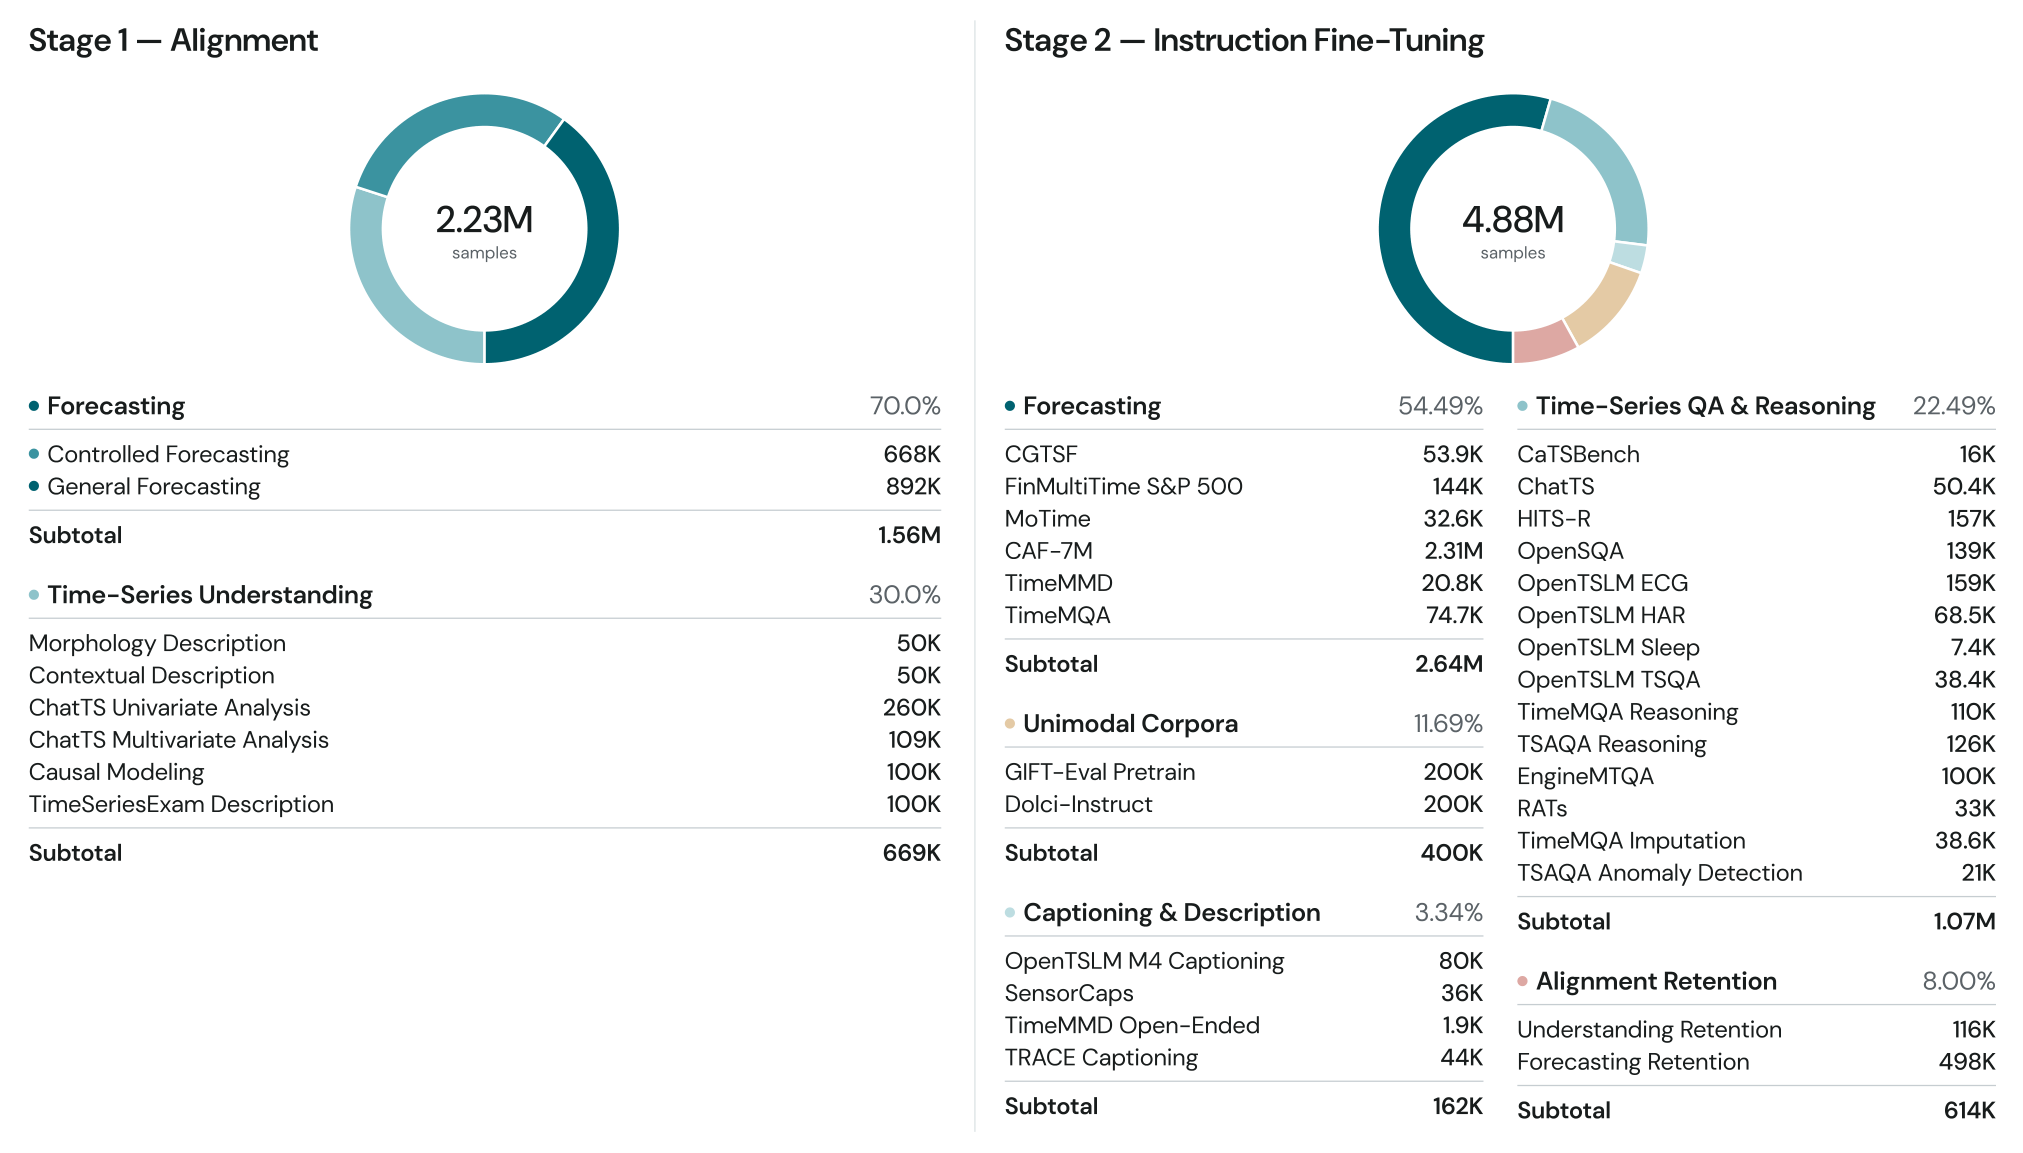
TimeBraid 是一系列统一的时间序列与语言模型,通过交错式全局残差注意力层 将预训练语言模型与预训练时间序列基础模型对齐。每个模型一方面继承语言侧的知识、指令跟随 与推理 能力,另一方面继承时间序列侧的连续信号感知 与零样本预测 能力,并在两种模态均可理解与生成的共享表示空间中完成融合。 我们系统研究了让这类统一建模奏效的设计选择:在何处对齐两个表示空间、如何将语言落地到时间结构上、如何平衡理解与生成、以及如何保持联合优化稳定。由此得到的配方包含三项要素: - 面向多样时间序列与文本任务的统一提示方案; - 稳定化的联合训练 策略; - 来自 2.2M 精选序列–文本对与 4.9M 指令微调样本的监督。 在覆盖时间序列感知、理解、推理以及上下文辅助预测与单模态预测的基准上,TimeBraid 与规模远大于自身的通用模型及任务专用模型相比仍保持竞争力。
论文精读
TL;DR TimeBraid 通过交错全局残差注意力对齐预训练语言模型与时序基础模型,在共享表示空间同时处理理解与生成;利用 220 万对齐对和 490 万指令样本稳定联合训练,在时序理解、推理和预测上匹敌更大的通用模型与专用模型。
问题
问题背景
当前时间序列分析领域正从单模态预测走向时序-语言统一建模,试图同时获得大语言模型的推理能力和时序基础模型的精准感知。
现有方法局限
- 时序基础模型(如 TimesFM、Chronos)虽擅长零样本预测,但缺乏指令遵循与自然语言交互能力;
- 大语言模型将时序数值 token 化后,常丢失连续信号的时间结构和动态特征,难以做高精度 forecasting;
- 已有“语言+时序”统一方案多采用浅层特征拼接或单向映射,未在正确表示空间深度对齐,导致两模态信息隔离;
- 联合训练时语言专家与时序专家容易相互干扰,优化不稳定,无法同时维持语言生成质量和时序预测精度。
为什么难/重要
时间序列与自然语言在数据分布、尺度、语义粒度上差异极大:时序是连续、有序、高噪声的,语言是离散、层次化的。共享表示需要同时解决表示空间对齐位置、时序结构如何被语言 grounding、理解与生成的平衡、多任务联合稳定性等核心难题。业界对跨模态时序问答、上下文辅助预测的需求上升,单一模态模型无法覆盖复杂推理场景,而从头训练大规模多模态模型面临数据稀缺和高昂算力成本,因此高效融合现有基础模型成为关键路径。
行业类比
类似多模态医疗诊断中融合影像与文本报告,统一时序与语言模型可让系统既读懂历史传感器流,又能用自然语言回答业务问题并预测未来值。
核心洞察
- TimeBraid 的核心是将预训练语言模型与时间序列基础模型作为两个独立专家,通过交错全局残差注意力层在同一表示空间内对齐,而不是简单地将时间序列编码器接到 LLM 输入端。这一设计保持了时间序列侧的连续信号感知和零样本预测能力,同时保留语言侧的指令跟随与推理能力,避免了常见适配器方案中时序信息被压缩成离散 token 导致的信息损失,也区别于早期直接微调 LLM 处理时序的路径。
- 论文把联合优化稳定性显式作为一等公民对待:通过稳定化策略和文本强度调制(Text Strength Modulation)在推理时动态控制语言对预测的影响。这解决了多模态时间序列模型普遍存在的模态坍塌与训练震荡问题,让模型既能利用文本上下文提升预测,又能在纯数值预测任务中屏蔽语言干扰,对工程落地有直接参考价值。
方法
输入与统一提示
TimeBraid 接收两类输入:连续时间序列信号与自然语言指令/上下文。统一提示格式将时序序列 token 化后,与文本 token 直接拼接,形成单一序列输入模型。
关键模块
- Tri-Expert 架构:由一个预训练 LLM、一个预训练时序基础模型(TSFM)和一个共享对齐层组成;LLM 与 TSFM 分别负责语言推理和连续信号感知。
- Global Residual Attention:在 LLM 的多个中间层之间插入 interleaved 全局残差注意力模块,让时序表示以残差方式注入语言表示空间,同时保留原模型知识。
- Disentangled Positional Embeddings:为时间步与文本位置分别编码位置信息,避免两种模态在位置语义上冲突。
- 两阶段训练:先用 2.2M 序列-文本对齐语料做对齐,再用 4.9M 指令样本做监督微调;联合损失融合语言建模与预测/理解目标,配合稳定性技巧(梯度裁剪、模态权重平衡)以及推理时文本强度调制。
输出
模型可在同一架构下完成时序理解、问答、上下文辅助预测与纯时序预测,输出自然语言或预测序列。
与同类方法差异:不同于简单拼接或纯对齐的时序-语言模型,TimeBraid 通过 interleaved global residual attention 在 LLM 内部层动态融合时序专家,实现双向知识迁移并保持单模态能力。
实验
实验设计
论文构建多基准评估体系,覆盖时间序列感知、问答、推理、上下文描述与预测。评估套件包括 TemporalBench 、TimeSeriesExam 、TSAQA 、TimeMMD 、CGTSF 等。训练数据为 2.2M 对齐样本与 4.9M 指令微调样本。消融实验针对交互空间、专家分离、优化稳定性、模态平衡、对齐阶段必要性、文本对预测影响六个问题。
关键发现
TimeBraid 在多种时间序列任务上与更大规模通用模型及专职模型相比保持竞争力,证明统一表示空间能同时支撑理解与生成。消融显示交错全局残差注意力层和分离位置嵌入对稳定训练至关重要,文本信号在跨域和长历史预测中作用显著。
基线对比解读
与任务特定时间序列模型相比,TimeBraid 以更少参数利用语言先验提升零样本和上下文推理;与仅用语言模型相比,其连续信号感知能力带来预测优势。未披露具体数值,但定性结论强调架构级融合而非简单拼接。实际工程可借鉴其两阶段训练策略与全局残差注意力稳定化方案。
行业影响
落地场景
TimeBraid 适用于同时处理时间序列数据与自然语言交互的产品,例如智能运维(AIOps)、金融分析、零售预测、医疗监护。一个典型用例是电商平台的需求预测:模型接收历史销量序列与促销计划文本,输出未来销量预测并生成可读的业务解释。另一个用例是工业设备预测性维护,结合传感器时序与维修日志,自动判定故障风险并给出维护建议。
商业价值
- 降本:减少人工编写规则与专家分析的成本,模型直接生成诊断与预测文本,缩短决策链路。
- 增收:更准确的多模态预测优化库存、定价与资源调度,降低缺货或过剩损失。
- 体验提升:业务人员用自然语言查询时序数据,无需掌握专业时序分析工具,降低使用门槛。
与现有产品/工作流的接口
TimeBraid 可作为微服务部署,通过 REST/gRPC API 接入企业数据栈。时序数据从 InfluxDB、Prometheus 等数据库读取,文本上下文来自工单系统或知识库,模型输出结构化预测和自然语言解释。也可作为 Grafana 或 Tableau 的插件,实现对话式时序探索,或嵌入现有 LLM 应用框架(如 LangChain),作为时序感知的推理引擎。
局限
- **模型能力受限于所选基础模型**。TimeBraid 的融合效果高度依赖底层 LLM 与 TSFM 的质量,若任一骨干网络在特定任务上存在知识缺口或偏置,联合模型难以自主弥补;论文可能未支持真正的跨模态生成(如从时间序列直接生成自然语言描述以外的内容),当前输出仍以文本为主。此外,对齐数据仅 2.2M 对,相比互联网规模文本量级偏小,可能导致语言能力在长尾或复杂指令上退化,评测集多为合成或标准 benchmark,真实世界泛化性仍需验证。
- **计算与训练开销显著**。交错全局残差注意力要求同时加载两个大型预训练模型,显存占用和推理耗时远高于单模态模型,实际部署成本高,轻量边缘场景不友好。联合优化两个异构网络容易陷入模态竞争,虽然提出稳定化技巧,但超参数可能较敏感,复现门槛高;对训练硬件和调参经验要求苛刻,限制了在中小团队中的推广。
- **与同类工作对比优势有限**。相较于通用多模态大模型(如 GPT-4o、Gemini),TimeBraid 参数规模小得多,开放域知识和复杂推理能力可能存在差距;与专用时间序列基础模型(如 TimesFM、Chronos)相比,纯 unimodal forecasting 并未全面领先,摘要仅称“remains competitive”;与轻量级耦合方法(如 Time-LLM 的重编程思路)相比,TimeBraid 架构复杂度更高,但在多数指标上未见数量级提升,工程收益比不够突出。