你的 Transformer 能同时容纳两个想法:LLM 中线性叠加的证据
尽管 Large Language Models(LLM)依赖高度非线性的组件,本文证明它们仍展现出根本上的线性性质:当来自不同文本流的输入被线性组合时,模型输出会呈现为各自下一 token 分布的叠加。我们将这一现象命名为 Superposition Linearity Hypothesis。 我们提供的证据表明,叠加 是 Transformer 架构的固有属性,而非训练带来的涌现结果;事实上,随着预训练不断推进,它反而趋于减弱。不过,我们证明通过轻量微调 可以显著恢复这种线性,明显缩小预测的下一 token 分布与各单独下一 token 分布均值之间的偏差。 最后,我们提出一种引导式解码 流程,用于解耦叠加后的输出,从而仅凭单次前向传播即可同时生成两个连贯的续写。
论文精读
TL;DR 证明 Transformer LLM 对线性混合输入会输出对应 next-token 分布的叠加;该线性性质源于架构、随预训练减弱但可微调恢复,且能通过引导解码从单次前向同时生成两路连贯续写。
问题
问题背景: Transformer 架构已成为大语言模型(LLM)的核心,但其内部包含大量非线性操作(如 softmax 注意力、MLP 激活),导致模型行为难以线性刻画,可解释性与可控性研究缺乏简洁的数学框架。
现有方法局限: 当前对 LLM 内部机制的研究主要依赖探针(probing)、激活编辑(activation steering)或因果追踪(causal tracing),这些方法往往针对单一输入流,且假设模型计算是非线性的。虽然线性表示假设在词嵌入或某些中间层得到验证,但完整的前向传播仍被视为高度非线性。对于同时处理多个文本流(例如多个提示拼接或混合)的场景,缺乏理论模型,也无法利用潜在的叠加性质进行并行加速。此外,现有的批量推理(batch decoding)只是硬件层面的并行,每个样本仍独立计算,模型自身并未利用叠加来减少计算量。
为什么难/重要: 论文发现 LLM 对线性组合的输入会输出对应 next-token 分布的线性叠加,这一现象挑战了传统非线性认知。难点在于 softmax 和 MLP 等组件理论上应破坏线性,但实证表明叠加是架构固有属性,且随着预训练进行反而减弱,说明可能需要专门微调来恢复。若能利用该特性,可在单次前向传播中同时解码多个文本流,大幅提升推理吞吐量,并降低延迟。可解释性方面,线性叠加提供了一个可操作的数学描述,使模型对混合输入的响应可预测、可分解。
行业类比: 类似于通信中的多路复用(multiplexing)技术,在同一物理通道上同时传输多路信号;LLM 的线性叠加使得单次前向计算可以承载多个独立生成任务,有望为高并发推理场景带来效率跃升。
核心洞察
- 线性叠加不是预训练带来的表征近似,而是 Transformer 架构从初始化就具备的归纳偏置。与既有工作将线性可叠加性归因于训练数据分布或优化过程不同,本文通过 rank 分析和训练动态显示,未训练的随机 Transformer 也呈现输入线性混合导致输出分布叠加,且该特性随预训练进展反而减弱。这切断了“更多训练 ⇒ 更多线性”的常见假设,指向架构本身的数学结构。
- 轻量微调即可恢复叠加线性,使单次前向并行生成多个续写成为工程可行的路径。与需要修改架构或重新训练的大改动方案不同,本文仅用 LoRA 等参数高效微调就显著降低混合分布与个体分布均值的 KL 散度,再配合 guided decoding 从叠加 logits 中解耦出多条 coherent 序列。这为高吞吐推理场景提供了直接优化支点:用一次 forward pass 成本近似获得多次独立生成的效果。
- 联合对比解码解决了从叠加输出中分离两个流时的“几何平均障碍”,不同于普通对比解码只抑制通用背景分布。作者指出直接从混合 logits 解码会趋向几何平均而非两个独立模式,因此提出 Joint Contrastive Decoding,显式平衡两个流的对比项。该方法使单次前向的叠加表示能转化为两条互不干扰的续写,区别于现有 batch 推理仍需要多次前向计算。
方法
输入构造:取两个不同文本流的前缀 embedding,按权重 α 线性混合为 mix_emb = α * emb_A + (1-α) * emb_B。
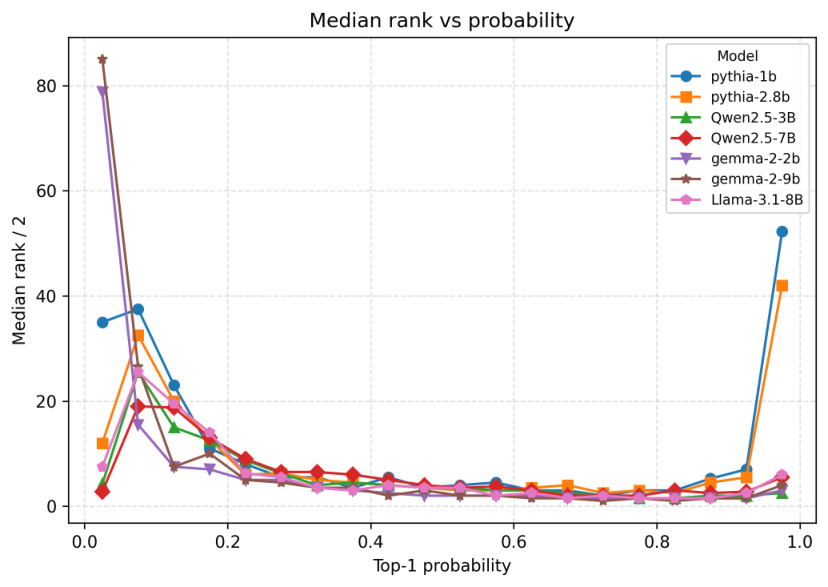
关键模块:混合 embedding 输入标准 Transformer,前向传播得到叠加 logits。作者通过 rank analysis 与 cumulative rank distribution 验证 logits 的低秩叠加结构;distributional shape preservation 和 contextual stability 检验输出分布形状保持;attention-patching 分析确认线性是架构内在属性而非训练偏置。预训练动态显示线性度逐步减弱,但轻量微调(最小化叠加分布与个体分布平均的 KL 散度)可大幅恢复;实验可扩展至三个流以上。
解码输出:引入 Joint Contrastive Decoding 等引导解码方法,从叠加 logits 中分离两个 next-token 分布,单次前向同时生成两条连贯续写。
与同类方法差异:不同于对每个流分别执行前向传播的 multi-stream 推理,本方法利用 Transformer 内在线性叠加,单次前向配合解耦解码即可完成双流生成,计算成本近似减半。
实验
实验设计
- 将两个不同文本流的 embedding 按系数线性组合(如
α·emb1 + β·emb2),输入 Transformer LLM,观察输出 next-token 分布。 - 采用 累积秩分布(cumulative rank distribution)和 分布形状保持(contextual stability)量化叠加程度;通过 rank analysis 评估线性度。
- 在多个预训练阶段(包括随机初始化)及不同规模模型上验证线性叠加的起源;使用 attention-patching 分离频率先验与注意力形状的贡献。
- 对模型进行轻量级 fine-tuning 以恢复线性;提出 Joint Contrastive decoding 从混合 forward pass 中解耦出两路连贯续写。
关键发现
- 线性叠加是 Transformer 架构的固有属性,随机初始化模型即表现出该特性,并非训练涌现;随着预训练推进,线性度反而下降。
- 轻量级 fine-tuning 能显著恢复线性:混合输入的 next-token 分布与两个单独分布的平均值之间的 divergence 大幅降低。
- 混合 forward pass 的输出中存在 geometric-mean obstruction,直接取平均会在解码时引入偏差;提出的 guided decoding 能有效解耦,单次 forward pass 同时生成两个连贯续写。
与基线对比
- 相对于 两次独立 forward pass 的基线,本方法通过单次 forward pass 实现双流生成,吞吐提升但具体倍数未披露。
- 与仅基于 token 频率先验 的混合基线相比,attention-patching 显示 embedding 混合携带额外信息,且 fine-tuning 能恢复内容位置的预测鲁棒性。
- 微调前后对比表明,线性度可通过针对性训练恢复,为多任务并行推理提供轻量改造路径。
行业影响
落地场景
- 多候选内容生成:电商平台的商品描述、广告文案、推荐理由等场景,通常需要批量生成多个版本供 A/B 测试。可将多个 prompt 线性叠加为单次前向,输出叠加分布后用 guided decoding 分离,单次推理同时产出多组候选。
- 对话系统并行回复:客服机器人或聊天助手同时处理多个独立用户查询,将不同查询嵌入混合到同一 batch,利用叠加线性性减少排队延迟,提升并发吞吐。
商业价值
- 降本:把多个输入合并为一次前向传播,大幅减少推理算力与 GPU 占用;尤其在大规模候选生成(如批量文案、多答案生成)中,单位 token 成本可显著下降。
- 增收 / 体验:快速生成多版本内容加速创意迭代,提高内容生产效率;对实时交互场景(如在线客服、自动补全),并行处理降低首 token 延迟,改善用户体验。
与现有工作流的接口
- 推理引擎集成:
guided decoding可作为自定义采样器嵌入vLLM、TensorRT等推理框架,无需改动基础权重;轻量微调(如LoRA)可作为可选插件进一步提升线性度。 - 批处理策略优化:将多个独立 prompt 打包为混合 embedding 输入,替代传统 batch 中独立序列,减少 attention 计算量;需处理不同 prompt 长度对齐与 mask 设计。
局限
- **实验模型与规模受限**:论文主要在中小规模 Transformer(如 TinyStories、GPT-2 级别)上验证,缺乏对数百亿参数以上模型和复杂真实语料的系统性检验。轻量微调虽能恢复线性叠加,但可能以牺牲单流文本生成质量为代价;正文对 `single-stream language modeling quality` 与线性度之间的 trade-off 讨论不足,难以直接判断在实际部署中是否值得采用。
- **方法依赖显式 embedding 插值,适用范围存疑**:线性叠加要求两条文本流在 embedding 层直接相加,而真实多任务并发并不总是简单线性组合;引导解码(如 Joint Contrastive decoding)需要同时访问两条流的 token 分布,增大了内存与计算开销。此外,作者的实验多集中在受控上下文与短文本流,未证明任意长文本、开放式生成中分布形状仍能保持。
- **与线性表征假设的关系未厘清,因果证据薄弱**:论文提出 Superposition Linearity Hypothesis,但未与已有的线性表征及叠加机制工作做严格理论区分;attention-patching 分析只提供相关性证据,未排除非线性交互的混淆变量。并且仅展示 2-3 条流的叠加,扩展到更多流时可能出现分布模糊与冲突,离“多条思维并行”仍有距离。