PUBG Ally: 作为 AI 队友的对话式具身智能体
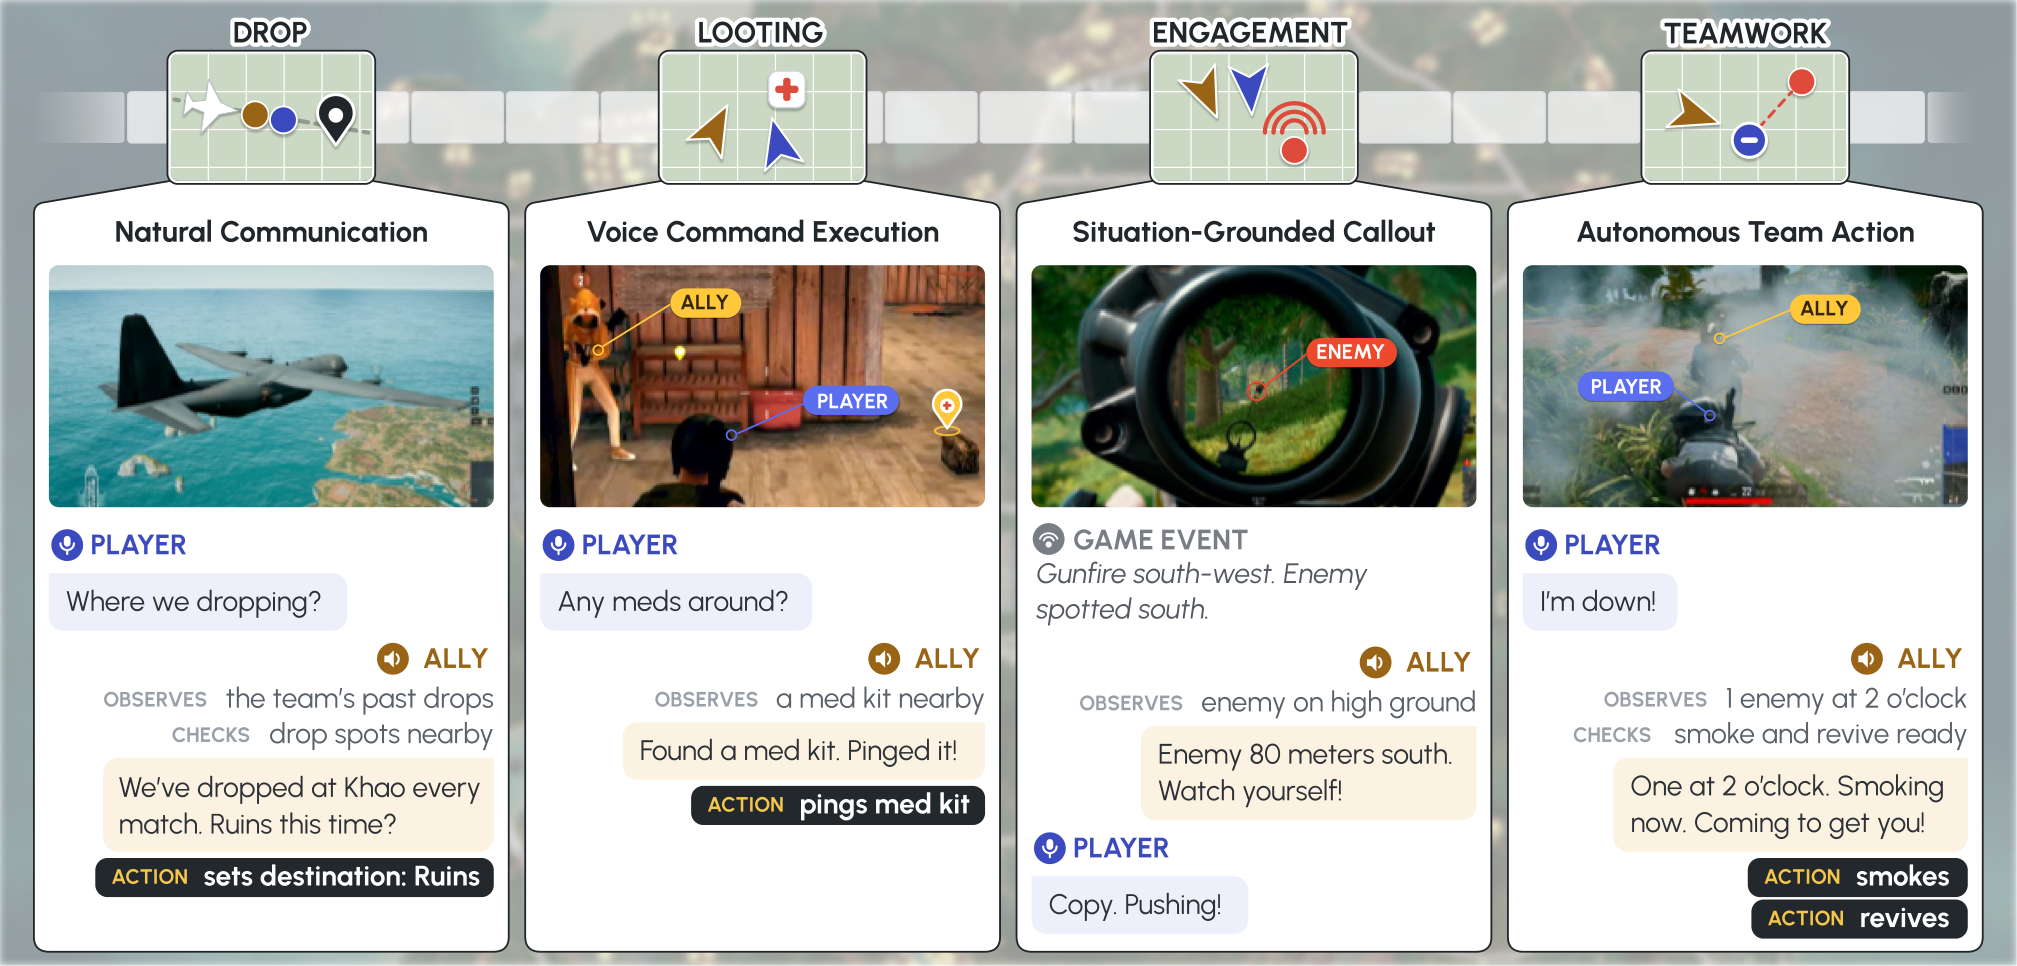
PUBG Ally 是面向 PUBG: BATTLEGROUNDS 的具身智能体,能够自主推理与行动,并作为语音队友与玩家并肩作战。要成为合格的队友,它必须同时具备两项困难能力:在严格的延迟约束下感知并响应不断变化的游戏世界,同时与玩家自然交互,使语音与动作保持同步。 方法上,Ally 将 智能体工具调用 与实时游戏控制结合:语言模型 agent 通过受控接口查看游戏信息、理解玩家语音、维护上下文、决定说什么,并发出高层动作选择,驱动更快的控制层完成移动、战斗与恢复。 由于玩家与 Ally 的语音和动作持续互相影响并左右比赛走向,训练需要真实对局数据。我们在近 39k 场 真实玩家与 Ally 同局的会话中记录游戏过程、玩家语音、agent 决策、工具调用、动作与玩家反馈,用于迭代训练。 评估方面,我们用玩家反馈与偏好比较识别离线评估与玩家偏好之间的差距,并迭代细化评估标准。上线服务还需要 低延迟端侧执行 与面向玩家交流的安全保障,我们通过模型压缩、上下文压缩、定向安全训练、运行时护栏与记忆脱敏来解决。在覆盖 141 个国家/地区的玩家调研中,经游戏记录确认与 Ally 同局的受访者里,愿意推荐 Ally 的正面回答比负面回答高出 25.1 个百分点,玩家不仅把 Ally 当作工具,也视为队友或伙伴。
论文精读
TL;DR PUBG Ally 是可语音交流的 PUBG 具身 AI 队友,用语言模型智能体做高层决策、低层实时操控,从近 3.9 万场真实对局中迭代训练,上线后玩家净推荐率超负面 25.1 个百分点。
问题
问题背景
近年来,大语言模型 驱动的具身智能体在开放世界游戏中的协作能力成为研究热点,目标是构建能与人类自然交互并自主行动的 AI 队友。
现有方法局限
传统游戏 NPC 的对话系统与行为控制相互独立,基于有限状态机或行为树,缺乏对玩家指令的语义理解和长期上下文维护;而纯 LLM 智能体虽然推理能力强,但每步决策延迟高(秒级),无法满足 FPS 游戏对毫秒级反应的要求,且直接输出低层控制信号不稳定。此外,现有训练数据多为离线脚本或模拟环境,缺少真实人类玩家与智能体共同游戏时的自然语音交互和动态反馈,导致模型难以学习到语音与动作的时序协调。
为什么这个问题难/重要
PUBG Ally 需要同时解决两个核心矛盾:
- 实时性:在严格延迟约束下感知不断变化的游戏状态并作出动作决策;
- 自然性:语音回复需与当前动作状态同步,不能出现“说一套做一套”的脱节。
训练数据必须来自真实对局,因为玩家的语音与智能体的行动会互相影响,形成闭环动态,离线合成数据难以覆盖。此外,生产部署还需解决设备端低延迟推理、玩家沟通安全性等工程问题,业界对可规模化运营的 AI 队友产品需求日益增长。
行业类比
这种“低延迟物理控制 + 自然语言交互”的组合,类似于自动驾驶中车载语音助手与车辆控制的融合挑战。
核心洞察
- **分层架构解耦认知决策与实时控制**:PUBG Ally 采用 System 2 事件驱动语言模型代理 + System 1 状态化实时控制层的两层设计。语言模型负责理解玩家语音、维护上下文、调度工具和生成高层行为选择,而底层控制层以行为树引擎在严格延迟下执行移动、战斗和恢复动作。这种解耦与多数仅用 LLM 做回合制决策或依赖脚本接口的代理不同,它直接解决了 LLM 推理延迟与实时游戏要求之间的矛盾,同时允许代理在运行中通过受控接口检查游戏状态、动态生成行为数据,为复杂环境下的可部署 agent 提供了实用架构范式。
- **真实玩家共同游玩数据驱动迭代训练与偏好对齐**:论文收集了近 39k 个真人玩家与 Ally 共同游玩的完整会话,记录游戏过程、玩家语音、代理决策、工具调用、动作和玩家反馈,并基于这些数据执行教师模型修正学生 rollout、合成扩充和分阶段训练。与仅依赖离线语料或模拟环境的做法不同,该方法捕捉了玩家与代理言语和行为相互塑造的真实动态,并进一步用玩家反馈和成对偏好比较定位离线评估与玩家偏好之间的差距,迭代修正评估标准。这揭示了在线共玩数据不仅是训练语料,更是持续对齐玩家期望的关键信号。
方法
输入与感知
Ally 接收两类输入:实时游戏状态(经受控接口查询,如地图、敌人位置、装备、角色状态)和玩家语音指令。语言模型代理在事件驱动循环中调用工具获取游戏信息,解析语音内容,并综合历史对话与行为上下文维持情境。
核心模块:分层架构
System 2(事件驱动 Agent Harness) 基于大语言模型,通过事件调度触发推理,输出两部分:自然语言回应(语音)与高层动作意图(如“移动到掩体后”)。这些意图经行为树引擎编码为可执行行为数据,支持运行时由 agent 生成或修改,实现反应式与主动式决策。
System 1(状态实时控制层) 是有状态执行层,将高层意图转换为连续控制信号(移动、瞄准、射击、使用道具),支持优先级抢占与恢复,保证毫秒级响应。例如战斗时优先执行规避动作,事后再恢复探路行为。
训练与部署优化
训练数据来自真实玩家双排对局(近 39k 场次),记录游戏轨迹、玩家语音、agent 决策、工具调用、动作及玩家反馈。采用教师-学生蒸馏:教师模型生成的正确动作与话语用于修正学生 rollout;辅以合成数据增强扩充稀有场景。分三阶段训练语言模型:预训练、指令微调、安全对齐。部署时使用模型压缩、上下文压缩、记忆脱敏、运行时护栏,确保低延迟与合规。
输出
实时输出语音回复(同步于动作)与高层动作指令,经控制层执行。
与同类方法的差异点:相比纯对话式游戏 NPC 或纯强化学习 bot,PUBG Ally 融合了 LLM 工具调用、分层控制与真实玩家联合训练,并针对在线服务做了端侧优化和安全防护,形成可部署的语音队友系统。
实验
实验设计
PUBG Ally 采用分层评估:离线能力测试集评估工具使用、语音同步与动作选择;安全评估覆盖有害 / 良性输入;在线评估从 PC Bang 小规模扩展至 141 国大规模调研。训练数据来自 39k 场真实人机双排会话,记录 gameplay、玩家语音、agent 决策、工具调用与反馈,用于迭代训练与评估 grader 权重学习。
关键发现
- 推荐意愿 净正向差值
+25.1 pp:正面反馈比负面反馈高出 25.1 个百分点。 - 玩家在开放反馈中不仅将 Ally 视为工具,更描述为 teammate / companion,说明语音同步与行动陪伴产生关系化价值。
- 模型压缩、上下文压缩、运行时护栏与记忆脱敏实现低延迟上线,支撑 on-device 执行。
与基线对比解读
论文未直接给出离线统一指标对比,但重点揭示离线评估与玩家偏好存在 gap;通过玩家反馈迭代修正 grader 权重、加入 preference comparison 后,在线推荐净正向差值才达到 +25.1 pp。这表明传统能力分数不足以预测真实 teammate 体验,需要把偏好排序与开放式反馈并入评估循环。
行业影响
落地场景
PUBG Ally 展示的 实时语音交互 + 自主控制 架构可迁移到需要低延迟、多模态协同的领域:
- 游戏与虚拟陪伴:AI 队友、NPC 对话与行动一体化,提升沉浸感;
- 在线教育:虚拟学习伙伴可边操作演示边语音指导,模拟一对一辅导;
- 电商直播:AI 数字人主播可实时回应观众提问并操控虚拟商品展示,类似玩家语音指挥 AI 行动。
商业价值
核心价值在 体验提升 与 降本。玩家调查中,愿意推荐的正面反馈高出负面 25.1 个百分点,证明情感化 AI 队友能显著提高用户粘性与付费意愿;同时替代部分真人陪玩、客服人力,降低运营成本。实时运行与安全护栏保证可规模化部署。
与现有产品/工作流接口
该系统采用 分层架构:上层 LLM 智能体负责语言理解与高层决策,下层 行为树引擎 负责实时控制。该模式可嵌入现有游戏引擎(如 Unreal/Unity)作为插件,语音链路可对接云 ASR/TTS 服务,模型可压缩后部署到端侧。对于企业 agent 栈,其 事件驱动 harness + 状态化执行层 提供了处理实时环境反馈的参考设计。
局限
- **泛化性受限**:该工作深度绑定 PUBG 游戏环境与特定 API 接口,分层架构(System 2 / System 1)及工具设计依赖游戏内结构化状态(如地图、物品、玩家位置),难以直接迁移至其他游戏或真实世界任务。论文未讨论跨环境适应性或抽象中间层的可复用性,作为通用具身智能体方案的证据不足。
- **评估主观性偏差**:主要在线评价依赖玩家问卷与偏好比较,参与者为自愿调查用户,可能存在选择偏差与回忆偏差;离线能力评估使用 LLM 作为 grader,其打分标准虽经迭代向玩家偏好对齐,但仍可能与真实体验有差距。缺少客观游戏表现指标(如胜率、伤害输出、生存时间)的系统报告,难以量化 Ally 作为队友的实际贡献。
- **安全机制的覆盖范围有限**:虽然部署了内容安全训练、运行时 guardrails 和输入脱敏,但论文未提供对抗性攻击或越狱测试的严格基准;在实时语音交互中,低延迟要求可能限制复杂安全过滤器的深度,存在生成不当言论或泄露隐私的风险。此外,对玩家输入的依赖使得系统可能受到提示注入等攻击,安全评估仅依赖有限的红队测试,长期稳健性待验证。