AV-GRPO:面向联合音视频生成的模态锚定解耦扩散强化学习
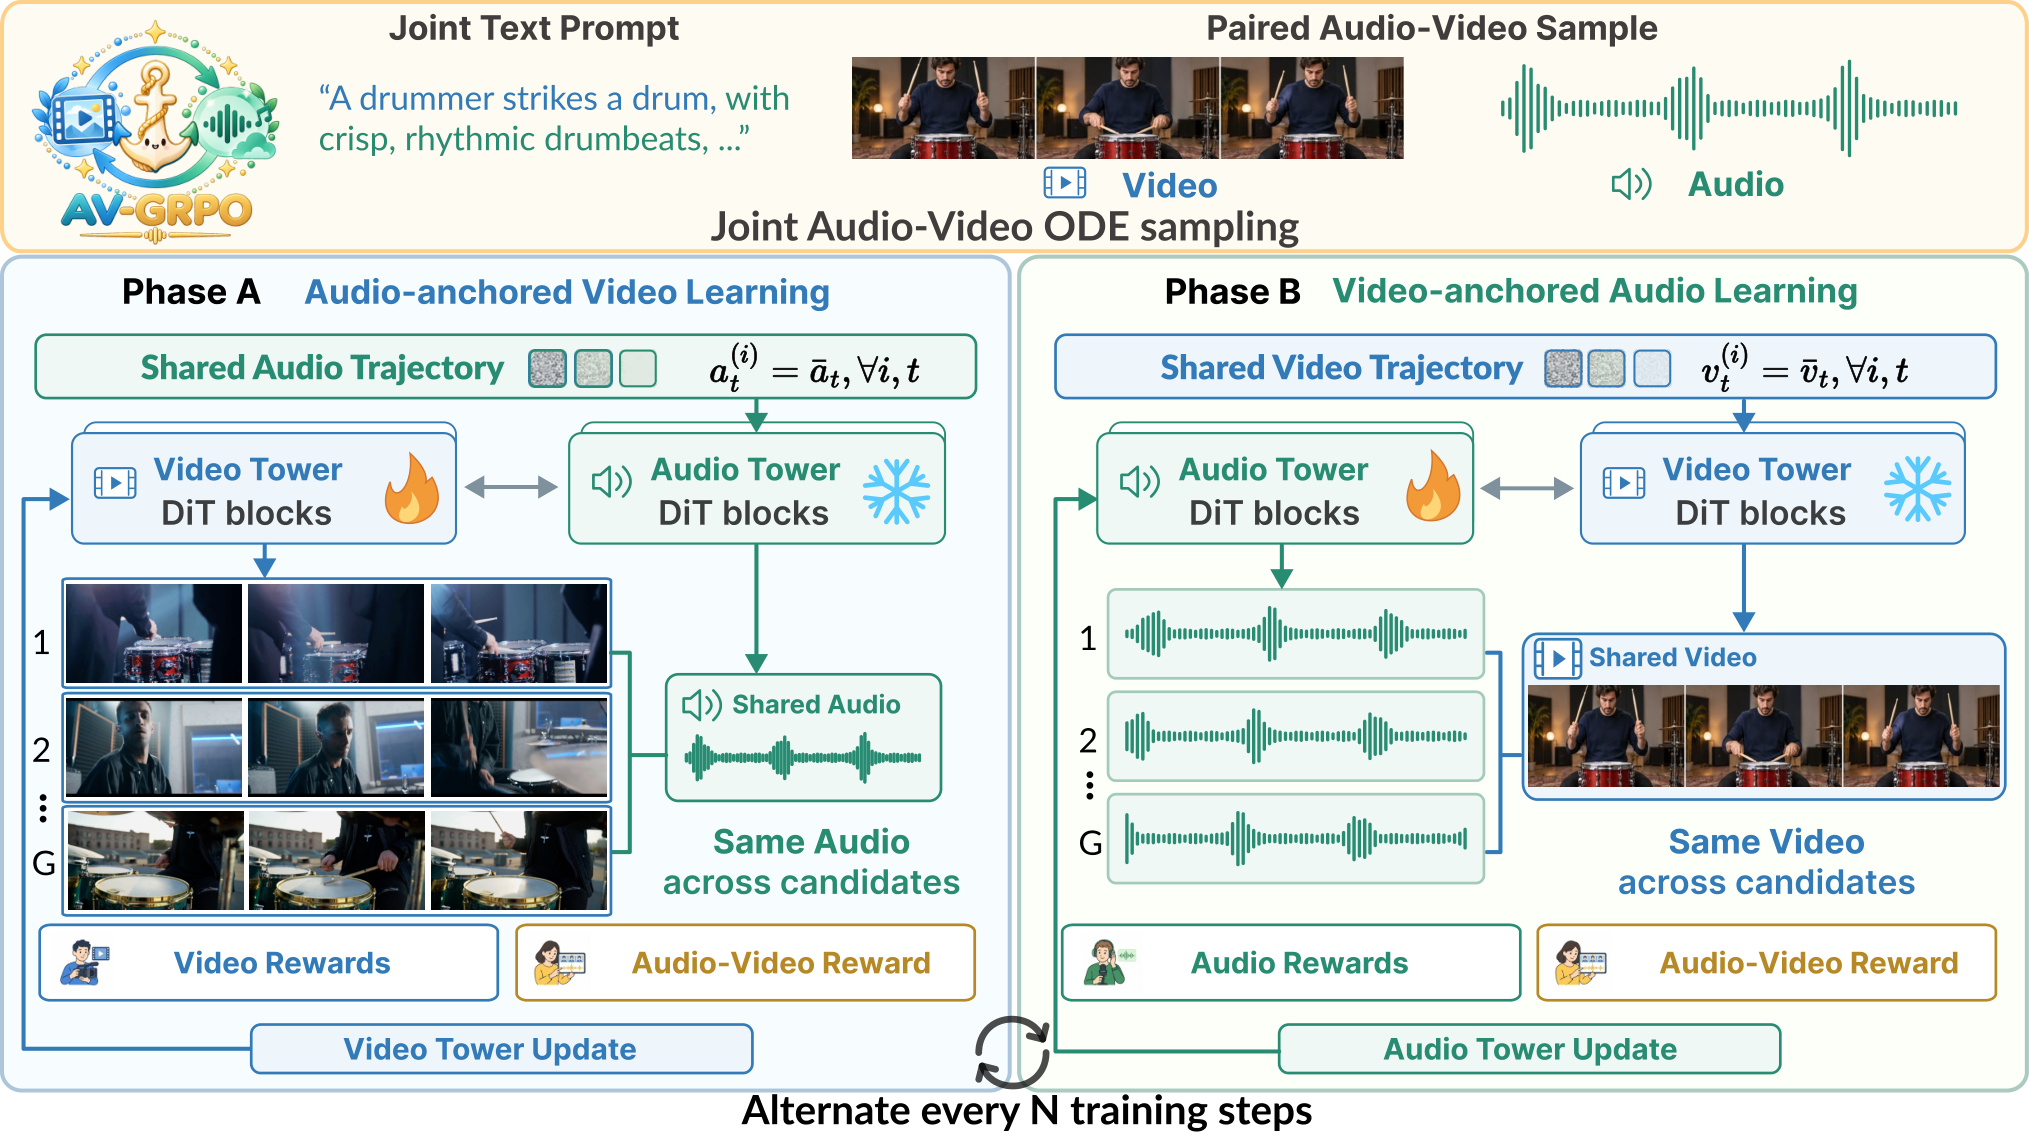
近年来,联合音视频生成取得重大进展,但现有模型仍受限于单模态保真度有限、文本-模态对齐不足与跨模态同步性弱。强化学习后训练虽是有前景的补救方案,直接迁移到该任务却面临挑战:异构多模态奖励纠缠学习信号、令信用分配复杂化;两座模态塔动态差异大,联合优化开销高昂;同步性评估依赖成对样本,难以公平比较奖励。 为此我们提出 AV-GRPO,一个模态锚定的在线扩散 RL 框架,以及 5DAV,一个解耦且难度可控的训练数据集。AV-GRPO 含三个关键模块:1. 模态锚定 rollout,解耦学习信号并稳定难度;2. 轨迹锁定的冻结塔优化,降低开销并重新分配信用;3. 针对模态特定动态的自适应目标与扰动强度。由此将耦合的多模态偏好学习转化为单模态子问题,实现精确奖励归因与更好的同步性。 5DAV 数据集在五个维度上解耦样本以支持系统性训练。在 JavisBench 与 VABench 上的实验表明,在 LoRA 与全量微调下,AV-GRPO 在生成质量、语义对齐与跨模态同步性上均优于 LTX-2.3,消融实验也验证了各项设计。代码与数据:https://github.com/zhiyuxu03/AV-GRPO
论文精读
TL;DR AV-GRPO 将音视频联合生成的强化学习后训练解耦为单模态子问题,通过模态锚定 rollout 与冻结塔优化实现精准奖励分配,配合 5DAV 数据集提升生成质量与跨模态同步。
问题
问题背景
近期联合音频视频生成(joint audio-video generation)成为多模态内容生成的热点方向,模型需同时输出时间同步的音视频流,但生成质量与对齐能力仍落后于单模态生成。
现有方法局限
直接将在单模态上成功的 RL post-training 迁移到联合生成会遭遇三重障碍:
- 异构奖励纠缠:音频质量、视频质量、语义对齐等奖励信号混合,造成 credit assignment 困难,无法判断性能提升来自哪个模态。
- 双塔联合优化代价高且动态不匹配:音频塔与视频塔收敛速度、梯度尺度差异大,联合更新易导致一方欠拟合或过拟合。
- 同步评估偏差:跨模态同步奖励依赖成对样本的难度分布,不同样本难度不同,使奖励信号不可比。
技术难点与业界关注
从工程角度,联合音视频生成本质上是要建模两个异质模态的联合分布,同时维持时间维度上的细粒度对齐。RL 信号若不能精确归因到单一模态,会破坏已学到的单模态能力。业界对自动配音、虚拟数字人、视频配乐等应用需求强烈,后训练是提升模型上限的关键环节,但缺乏可稳定训练的 RL 框架已成为瓶颈。
行业类比
这类似于自动驾驶中多传感器融合的联合优化:全局奖励直接回传到相机与激光雷达分支会导致某一模态主导优化,必须对各模态解耦贡献,才能稳定提升整体性能。
核心洞察
- 信用分配的解耦:AV-GRPO 将联合音频-视频生成的多模态偏好学习转化为单模态子问题,通过 modality-anchored rollouts 和 trajectory-locked frozen-tower optimization 分离异质奖励信号。与直接对联合分布施加 GRPO 的基线相比,该设计避免了音频和视频奖励相互纠缠,使每个模态塔能独立接收精准的梯度更新,从而提升 per-modality fidelity 与 text alignment。
- 计算与稳定性优化:通过冻结对方模态塔的交替优化策略,AV-GRPO 在保持同步性的同时显著降低联合 RL 的计算开销;自适应噪声裁剪和超参数解耦则针对音频、视频不同的扩散动态进行适配。相比同时微调双塔的方案,这种轨迹锁定机制减少了发散风险,并利用 5DAV 数据集的难度可控样本来增强训练的鲁棒性。
方法
AV-GRPO 面向联合音视频生成,输入为预训练扩散模型与多模态奖励信号,输出为经过强化学习微调、语义对齐与跨模态同步更优的生成模型。
关键模块
- 模态锚定 rollout:将联合音视频生成解耦为音频、视频两个单模态子问题,分别采样展开轨迹,避免异构奖励信号互相干扰,稳定训练难度,实现精准的奖励归因。
- 轨迹锁定冻结塔优化:交替优化音频塔与视频塔时,冻结另一模态的生成轨迹,降低联合训练的计算成本,并将跨模态同步奖励重新分配给当前优化模态,缓解信用分配难题。
- 自适应目标与扰动强度:根据音频与视频不同的收敛动力学,调整各自的 KL 约束力度与噪声裁剪范围,提升训练稳定性。
配套的 5DAV 数据集 在五个维度解耦样本难度,支持系统化的课程式训练。整体上,AV-GRPO 将耦合的多模态偏好学习转化为单模态子问题,最终获得更高质量的生成结果与更一致的音画同步。
与直接扩展 GRPO 到多模态的方法相比,AV-GRPO 首次通过模态锚定与冻结塔交替优化,显式处理异构奖励纠缠与信用分配问题,避免联合优化发散。
实验
实验设计
AV-GRPO 以 LTX-2.3 为基线模型,在联合音视频生成任务上分别采用 LoRA 与全参数微调两种训练模式。训练数据使用提出的 5DAV 数据集,该数据集在五个维度上解耦样本,使训练难度可控。评估基准为 JavisBench 与 VABench,覆盖生成质量、语义对齐与跨模态同步三类指标。消融实验围绕数据集设计与交替模态优化策略展开。
关键发现
- 模态锚定 rollout 将音视频解耦为单模态子问题,降低多模态 reward 的信用分配难度。
- 轨迹锁定冻结塔优化 在训练中冻结一个模态塔,减少计算开销并重新分配梯度信用。
- 自适应目标与扰动强度 针对不同模态动态分别调整,提升训练稳定性。
- 实验表明 AV-GRPO 在生成质量、语义对齐和跨模态同步上均超过 LTX-2.3,且 LoRA 与全参数微调下结果一致。
与基线对比解读
相比直接适配多模态 RL 的基线 LTX-2.3,AV-GRPO 的核心差异在于将耦合偏好学习转化为可独立优化的单模态子问题,避免异构 reward 信号互相干扰。冻结塔策略显著降低联合训练成本,同时保持同步性能。这一设计对多模态生成的后训练工程具有实用价值:模块化解耦与难度可控数据有助于提升 RL 训练的稳定性和样本效率。
行业影响
落地场景
AV-GRPO 适用于需要文本到音视频联合生成的场景:电商商品短视频、在线课程讲解视频、虚拟主播 / 数字人、社交媒体短剧与广告素材。通过强化学习后训练,模型输出音画同步、语义对齐更准的成片,可直接用于内容平台或内部创意工具。
商业价值
主要收益来自降本与体验提升:降低人工配音、剪辑与音画对齐成本;提高成片一次性通过率,减少返工;提升用户观看完成率与转化。交替冻结塔的训练策略减少算力开销,使中小团队也能在有限 GPU 上做 RL 后训练。
与现有工作流集成
可作为现有 Diffusion / Flow 音视频模型的 post-training 环节,以 LoRA 或全量微调接入。需准备好 5DAV 类训练数据与多模态 reward model(如语义、同步、保真度打分器)。它把联合优化拆为单模态子问题,能嵌入现有 RLHF / GRPO 训练框架,无需重写生成主干。
具体 use case:
- 电商:输入商品描述与卖点,生成带真人/数字人口播、环境音和产品展示的视频广告,自动保持口型与动作同步。
- 教育:根据知识点生成讲师讲解视频,语音与板书/动画同步出现,支持多语言和个性化节奏。
局限
- **计算开销依然较高**:虽然采用了 frozen-tower optimization 和 adaptive perturbation strengths 来降低联合训练的成本,但 AV-GRPO 本质上仍是双塔在线扩散 RL 方法,每个 rollout 需要对音频和视频两个独立塔进行采样,并且 full fine-tuning 设置下需更新全部参数。论文未报告与单模态 RL post-training 相比的具体加速比,也未讨论在资源受限环境下的可行性。对于产品级部署,这种训练开销可能成为实际应用的瓶颈,除非进一步压缩采样步数或采用更轻量的 reward model 近似。
- **实验基线单一,难以隔离解耦机制的贡献**:实验主要与 LTX-2.3 基线对比,未纳入将现有 RL 方法(如原始 GRPO、DDPO)直接扩展到联合音频-视频生成的对照。因此无法明确判断性能提升究竟来自于 modality-anchored rollouts、frozen-tower optimization 还是 5DAV 数据集本身,削弱了方法组分消融的说服力。与同类工作(如多模态 RLHF 的统一奖励模型方案)也缺乏横向比较,可能导致对解耦优势的高估。
- **理论保证依赖强假设,实用扩展性受限**:附录中的收敛性证明建立在指数倾斜、Gibbs 核和严格的条件独立性假设之上,而实际训练中使用扩散模型近似采样和替代奖励函数,可能偏离这些理论条件。此外,方法基于 LTX-2.3 的 Flow-GRPO 框架设计,是否适用于其他联合生成架构(如基于 AR 或非扩散模型)尚未验证,限制了方法的通用性。