CodeGraph:面向源代码的开放分类体系知识图谱,基于 Wikidata 实体链接
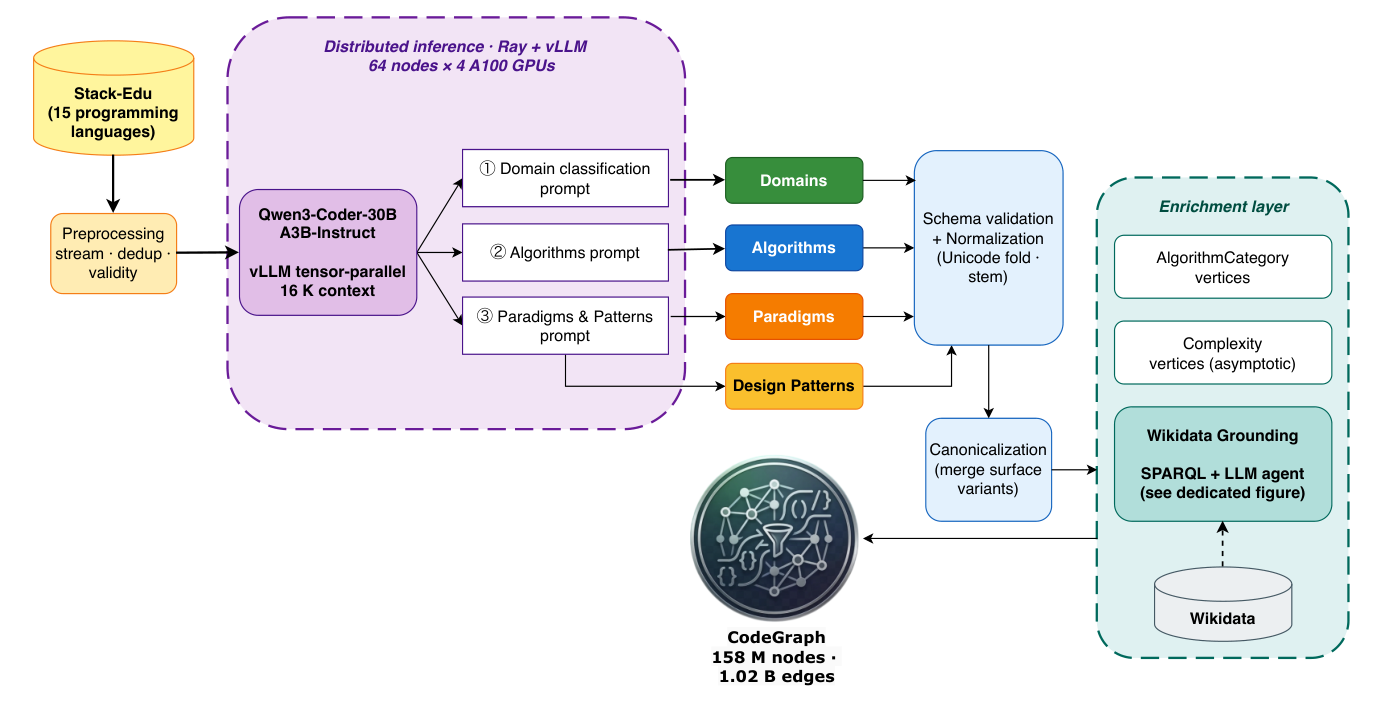
公开软件仓库(如 GitHub 和 Software Heritage Archive)存储了数十亿文件,但从中抽取隐含的工程知识——它们实现的算法、遵循的范式、实例化的设计模式,以及所服务的应用领域——仍然困难重重,因为现有工具局限于句法与词元级分析。 我们提出一条由代码专用大语言模型驱动的流水线,为源代码构建开放分类体系的语义标注。抽取出的实体通过三阶段流程 grounding 到 Wikidata:确定性的 SPARQL 阶段处理无歧义实体,Deep Research Agent 消解剩余的长尾,层级上卷阶段则导入每个已解析 Wikidata 标识符的父子闭包。最终标注被物化为源码专用的开放分类知识图谱。此外,我们引入一套经过校准的质量保证协议,结合小型人工 gold set 与 LLM-as-a-judge 过滤来量化标注精确率。 我们将该流水线应用于 Stack-Edu 语料的 1.67 亿 个文件,构建了首个已知的大规模源代码开放分类知识图谱。该图谱命名为 CodeGraph,包含约 1.58 亿节点,其中包括: - 约 1.45 亿个文件; - 约 63,000 个抽取概念实体(算法、范式、设计模式、应用领域); - 约 19,800 个已 grounding 的 Wikidata 实体。 CodeGraph 还拥有约 10 亿条类型化边,将文件连接到对应概念、把概念链接至其 grounded 的 Wikidata 标识符,并关联到父类目,覆盖 14 种编程语言。
论文精读
TL;DR CodeGraph 首次对亿级源码文件做开放分类学语义标注,并通过三步 Wikidata grounding 构建知识图谱,使算法、范式、模式等隐性工程知识可被结构化查询。
问题
问题背景
软件工程与 AI 交叉领域正聚焦从大规模代码仓库中提取可复用的工程知识(算法、设计范式、应用领域),以支撑代码搜索、自动生成和依赖治理。
现有方法局限
主流工具如静态分析、代码检索和基于 token 的模型,仅能捕获语法结构和表层语义,缺乏对代码所实现“概念”的抽象。这类方法存在三类具体限制:1) 无法识别诸如“HashMap 扩容策略”或“发布-订阅模式”等高层设计意图;2) 依赖预定义封闭词汇表或类别体系,无法覆盖跨语言、跨项目的开放概念空间;3) 缺少与外部知识库(如 Wikidata)的实体链接,导致语义标注彼此孤立,难以聚合推理。即使引入通用 LLM,也面临长尾实体消歧和规模化质量控制的双重挑战。
为什么这个问题难/重要
从 167M 文件级别的语料中抽取开放分类法的语义标注,需要同时解决三个技术难题:LLM 推理成本与吞吐的平衡、非受控概念与 Wikidata 实体对齐的召回率、以及人工标注难以覆盖全量数据时的精度保证。该问题直接影响代码智能系统的可解释性和跨仓库知识迁移能力,是软件工程领域从“代码检索”迈向“知识理解”的关键瓶颈,也受到工业界在代码助手、软件成分分析等方向的密切关注。
行业类比
类似从非结构化文本构建通用知识图谱(如 Google Knowledge Graph)时所面临的实体规范化与长尾覆盖问题,但对象从自然语言切换为代码,语义密度更高且领域约束更强。
核心洞察
- **开放分类学 + Wikidata 对齐解决代码语义标注的长尾问题** 现有代码知识图谱通常依赖预定义 schema(如 CodeOntology、代码属性图),只能覆盖有限的概念集合,遇到算法、范式、设计模式等长尾概念时捉襟见肘。CodeGraph 让 LLM 自由提取概念,再通过三层 Wikidata 实体链接将自由文本对齐到开放知识库,既保留了 LLM 的覆盖广度,又获得了结构化语义。这种 “开放提取 + 开放对齐” 的思路比固定 schema 更适应真实代码仓库中不断演化的工程知识,是可复用的工程范式。
方法
输入
- Stack-Edu 语料库 的 1.67 亿个源代码文件,覆盖 14 种编程语言。
关键模块
- 开放分类法 LLM 标注:使用代码专用大语言模型(code-specialised LLM)对每个文件进行语义分析,提取算法、编程范式、设计模式、应用领域等概念实体,不依赖预定义封闭分类法。
- 类型化属性图构建:将文件与提取的概念实体作为节点,建立文件-概念、概念-概念等类型化边(typed edges),形成初始图。
- 三阶段 Wikidata 实体链接:
- 阶段一:确定性 SPARQL 查询处理无歧义实体;
- 阶段二:Deep Research Agent 解决剩余长尾实体;
- 阶段三:层级回滚(hierarchy-rollup)导入每个已解析 Wikidata ID 的父类闭包,丰富语义层级。
- 质量保证协议:结合小型人工黄金标准集与 LLM-as-a-judge 过滤器,校准并量化标注精度。
输出
- CodeGraph:约 1.58 亿节点(1.45 亿文件节点、6.3 万概念实体、1.98 万已链接 Wikidata 实体)和约 10 亿条类型化边。
与同类方法差异:现有工具仅停留在句法与 token 级分析,而本方法首次在亿级文件规模上构建开放分类法知识图谱,并通过三阶段 grounding 与校准 QA 保证实体链接质量。
实验
实验设计
CodeGraph 的构建以 Stack-Edu 语料库为核心数据集,覆盖 167 million 个源文件、14 种编程语言。流程采用 code-specialised LLM 进行开放分类学语义标注,再通过 三阶段 Wikidata 链接:确定性 SPARQL 查询处理无歧义实体,Deep Research Agent 解决长尾实体,最后层级上卷(hierarchy-rollup)导入父类闭包。质量保证方面,结合小规模人工金标集与 LLM-as-a-judge 过滤器量化注释精度。
关键发现
最终生成 CodeGraph 知识图谱,包含约 158 million 个节点:145 million 个文件节点、63,000 个抽取的概念实体(算法、范式、设计模式、应用领域等)、19,800 个 Wikidata 接地实体;边数量约 1 billion 条,类型化连接文件-概念、概念-Wikidata 标识符、概念-父类。这首次实现了对大规模源代码的开放分类学语义注释。
与基线对比解读
现有工具局限于句法和 token 级分析,无法提取算法、范式等工程知识。CodeGraph 通过 LLM 结合 Wikidata 结构化知识库,构建源码头特定的知识图谱,弥补了语义鸿沟。其质量保证协议提供了可校准的精度指标,相比纯启发式或纯 LLM 方法更具可信度。该工作为代码检索、知识发现等下游任务提供了新的基础设施。
行业影响
落地场景
CodeGraph 将大规模源代码转化为语义知识图谱,可直接用于代码语义搜索、技术债务分析和自动化文档生成。具体场景:
- 代码搜索引擎:支持按算法(如
A*)、设计模式(如singleton)、应用领域(如推荐系统)检索代码片段,超越传统的 token 匹配。 - IDE 智能插件:在开发过程中实时提示相似实现、潜在复用组件,或标记不符合特定范式的代码。
- 企业级架构治理:扫描内部代码库,识别技术栈迁移风险(例如发现大量使用过时加密算法的文件),辅助合规审计。
商业价值
- 降本:减少开发者跨仓库查找和理解代码的时间;自动生成代码的知识标签,降低人工维护成本。
- 增收:为代码托管平台、开发者工具提供增值订阅服务(如高级语义搜索、代码健康度报告)。
- 体验提升:更智能的代码补全与推荐,提升开发者效率与平台粘性,间接提高留存率。
与现有产品/工作流的接口
CodeGraph 可作为独立的知识图谱服务,通过 REST API 或图数据库协议(如 Neo4j、Apache Jena)集成到现有栈:
- 作为 RAG(检索增强生成) 的知识底座,提升代码问答 Agent 的准确性。
- 接入 CI/CD 流水线,在构建阶段自动生成代码的语义标签,并触发质量门禁。
- 数据导出为 RDF 或属性图格式,可直接导入企业数据湖或知识图谱平台。
具体 use case:
- 电商平台在维护推荐系统代码库时,通过 CodeGraph 快速定位所有实现 协同过滤 的文件,评估替换为深度学习模型的迁移成本。
- 金融科技公司使用 CodeGraph 识别风控代码中的 加密算法 和 设计模式,自动生成合规审计报告,减少人工审查工作量。
局限
- **LLM 注释可靠性存疑**:论文依赖 code-specialised LLM 提取工程知识概念,但未充分披露模型选择、提示设计及微调细节。LLM 可能产生幻觉或偏向训练数据中高频概念,导致注释偏差。人工 gold set 规模较小(论文未给出具体数量),LLM-as-a-judge 过滤可能继承相同偏差,使得 precision 校准的置信度有限。此外,未验证召回率,无法判断重要概念是否被系统性遗漏,这影响图谱作为知识资源的可信度。
- **数据集与语言覆盖局限**:实验基于 Stack-Edu 语料库,该语料主要来自教育场景,代码结构与生产代码存在差异,可能无法代表真实世界软件仓库中的复杂算法、设计模式与领域分布。当前 CodeGraph 仅覆盖 14 种编程语言,未包含函数式语言(如 Haskell、Scala)或脚本语言(如 Perl、R),限制了图谱的通用性。同时,开放分类法提取的 63k 概念实体相对 145M 文件极为稀疏(平均每文件不足 0.0004 个概念),可能无法支撑细粒度代码搜索或推荐任务。
- **评估指标单一且缺乏下游验证**:质量保证协议主要量化 annotation precision,通过小规模 human gold set 与 LLM 过滤,但缺少实体链接准确率、概念召回率及图谱完整性的系统评估。三阶段 Wikidata grounding 中 Deep Research Agent 的推理效率与可复现性未详细说明,可能引入额外延迟和不确定性。此外,论文未展示 CodeGraph 在下游任务(如代码分类、检索、问答)上的实际增益,其应用价值仍待验证。