IterSynth: 以角色解耦的迭代合成重新思考深度搜索智能体
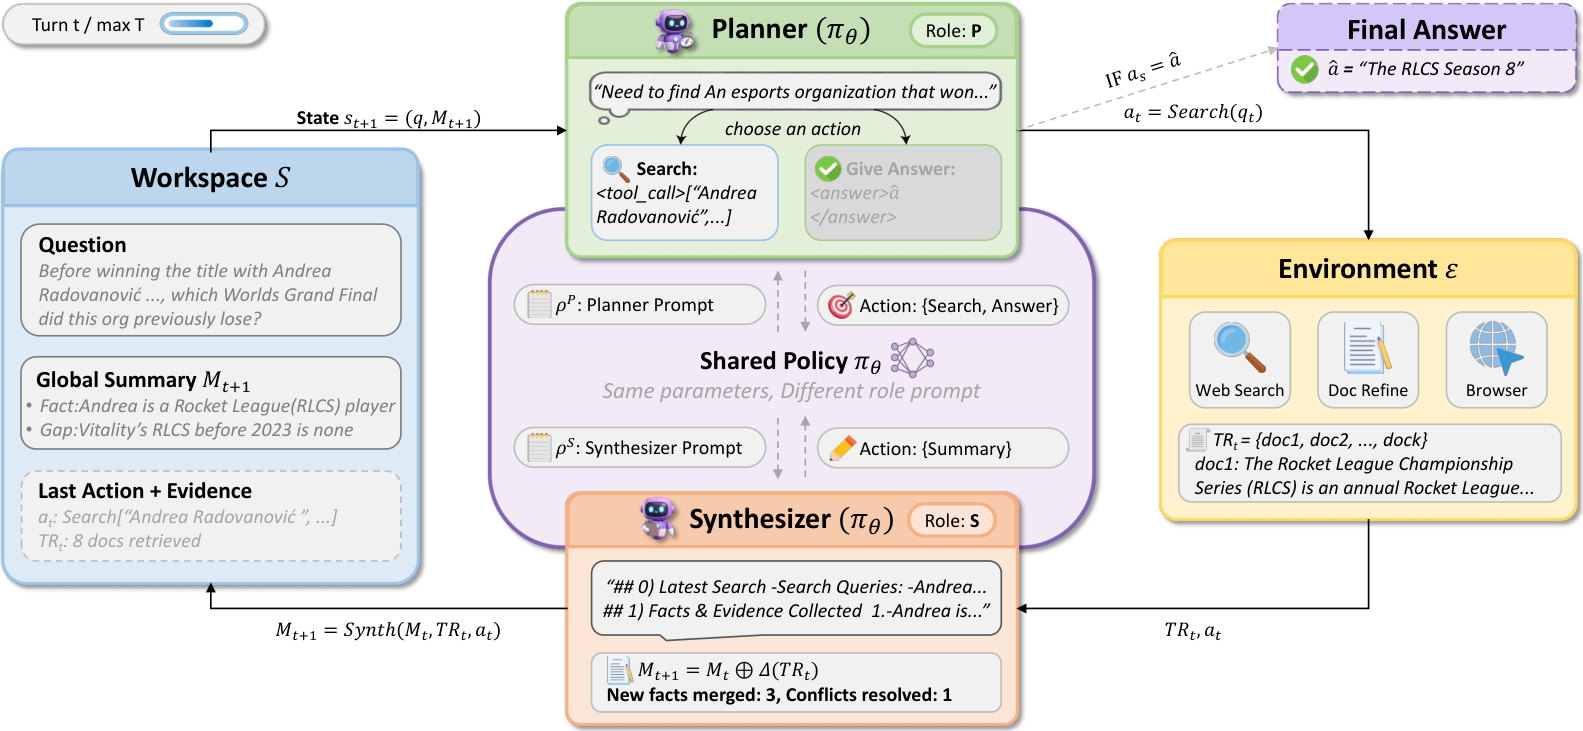
深度搜索 要求 LLM 智能体分解复杂查询、检索证据并合成有依据的答案,但现有 ReAct 式智能体存在两个局限:一是 角色耦合,单一策略需同时承担规划、证据使用与答案合成;二是 上下文累积,不断增长的搜索历史引入噪声,掩盖了有用信息。 为此,我们提出 IterSynth,一种角色解耦且基于摘要的范式:它在 Planner 与 Synthesizer 之间交替——前者负责识别信息需求,后者负责将证据整合进持续演化的摘要状态。该设计将规划与合成分离,并以摘要作为搜索的持久状态,从而同时缓解能力耦合与上下文噪声。 为有效训练 IterSynth,我们进一步提出 Role-Decoupled Policy Optimization(RDPO) 强化学习方法:它结合终端结果奖励与轮级评分量表评估,并为不同角色计算各自的优势,实现更精确的信用分配。 在 BrowseComp、Xbench-DS 等五个长程深度搜索基准上,IterSynth-8B 取得平均 50.7 分,超越此前最强 ≤8B 智能体 +4.2%。此外,IterSynth 也可作为与模型无关的提示范式,在前沿闭源模型上相较 ReAct 等提示范式带来显著的零样本提升。
论文精读
TL;DR IterSynth 将深度搜索解耦为 Planner 与 Synthesizer 双角色迭代,以摘要状态替代累积上下文,并用 RDPO 强化学习分别优化角色,使 8B 模型在 BrowseComp 等基准上超越同规模最强,还能零样本提升闭源模型。
问题
问题背景
深度搜索代理领域正关注如何让 LLM 自主分解复杂查询、多次调用搜索工具,并综合多源证据生成可靠答案。
现有方法局限
当前主流的 ReAct-style agents 存在两个关键技术瓶颈:
- 角色耦合:同一策略网络同时承担查询规划、证据筛选与答案综合,单一模型能力被分散到多个异质子任务,训练与推理时都难以对每个角色做精细优化。
- 上下文累积:搜索历史被线性追加到 prompt 中,随着轮次增加,早期关键信息被噪声淹没,且 token 成本线性增长;在长时程任务中,这种上下文膨胀会直接导致模型遗漏证据或超出上下文窗口而无法完成任务。
为什么这个问题难且重要
深度搜索需要长时程推理、多步工具调用和证据一致性检查,任何一步的规划偏差都会在后续综合中放大。行业对搜索代理的可靠性有高要求,但现有小规模模型在复杂 benchmark(如 BrowseComp 和 Xbench-DS)上差距明显;同时,上下文膨胀直接增加 API 推理成本与延迟。因此,如何将规划与综合解耦、并用压缩状态替代原始历史,成为提升搜索代理效率和鲁棒性的关键难题。
行业类比
这类似于企业知识库多轮检索问答中,系统不能无限制地把每一轮检索片段塞进上下文,而需要维护一个随对话更新的摘要状态,只保留与当前问题相关的证据精华。
核心洞察
- 角色解耦与 summary 状态是解决深度搜索 agent 两大瓶颈(角色耦合与上下文积累)的核心设计。与 ReAct 风格 agent 将规划、证据使用和综合全部耦合在单一策略中不同,IterSynth 引入 Planner 和 Synthesizer 两个角色,通过交替迭代将信息压缩为可更新的 summary 状态。这种设计不仅分离了认知职责,还避免了随着搜索轮次增加而不断膨胀的上下文噪声,使模型能专注于当前需要的信息,而不是全量历史。该工作流本质上是把状态管理从对话历史中解耦出来,对长程搜索任务的稳定性和可扩展性至关重要。
- Role-Decoupled Policy Optimization (RDPO) 通过角色特定优势估计改善了长程搜索任务的信用分配。传统 RL 方法通常对整个轨迹使用单一优势信号,难以区分 Planner 的信息需求判断与 Synthesizer 的证据整合质量。RDPO 结合终局结果奖励和回合级 rubric 评估,分别为两个角色计算 advantage,使训练信号能够精准地强化每次角色决策。这种更细粒度的奖励分解对于多轮交互场景特别有效,因为它减少了无关步骤的噪声奖励,加速收敛并提升最终性能。实验显示,RDPO 是解锁 IterSynth 长程能力的关键因素。
方法
输入与整体流程
输入为复杂多跳查询,IterSynth 将其交给双角色迭代工作流:Planner 与 Synthesizer 交替运行。Planner 根据当前摘要状态识别下一步信息需求并发出搜索指令;Synthesizer 将检索到的证据融合进摘要状态,该状态作为搜索过程中持久化的上下文表示,避免保留完整历史轨迹。
关键模块
- Planner 角色:负责规划与信息缺口识别,输出搜索动作。
- Synthesizer 角色:负责证据整合与摘要更新,输出中间摘要。
- Summary State:可变摘要状态,替代累积的原始上下文,降低噪声与长程退化。
- Role-Decoupled Policy Optimization (RDPO):训练时结合终端结果奖励与轮次级 rubric 评估,并为 Planner / Synthesizer 分别计算角色专属优势,实现更精细的信用分配。冷启动先经过 SFT。
输出
最终 Synthesizer 根据充分更新的摘要状态生成有证据支撑的答案。
与 ReAct-style 代理相比,IterSynth 将规划与合成解耦,并用摘要状态取代原始上下文堆叠,从而缓解角色耦合与上下文噪声问题。
实验
实验设计
IterSynth 在五个长时域深度搜索基准(包括 BrowseComp 和 Xbench-DS)上评估,覆盖复杂多跳推理与证据合成任务。训练采用两阶段:先通过监督微调(SFT)冷启动,再用 Role-Decoupled Policy Optimization (RDPO) 强化学习优化。IterSynth-8B 作为主模型,对比基线包括 ReAct 风格智能体及同类 ≤8B 参数模型,同时测试作为模型无关提示范式的零样本效果。
关键发现
- IterSynth-8B 在五个基准上平均得分 50.7,超越此前最强 ≤8B 智能体 +4.2%。
- 作为模型无关提示范式,IterSynth 在 frontier 专有模型上较 ReAct 及类似提示范式带来显著零样本提升。
- RDPO 通过回合级 rubric 评估与角色特异优势计算,有效缓解了角色耦合与上下文累积噪声问题。
基线对比解读
ReAct 风格智能体将规划、证据使用与合成耦合在单一策略中,且搜索历史持续累积导致噪声干扰。IterSynth 的 角色解耦 让 Planner 专注信息需求识别,Synthesizer 维护演进的摘要状态,降低能力耦合与上下文噪声。从结果看,平均分 +4.2% 表明摘要状态相比原始历史堆叠更利于长时域证据整合,而模型无关的零样本提升说明该工作流本身具有通用价值,不依赖特定模型微调。
行业影响
落地场景
IterSynth 的角色解耦迭代合成框架适用于需要多轮证据收集与整合的长程搜索场景,例如企业知识库问答、电商商品深度对比、学术文献综述、金融尽调报告生成、医疗证据检索等。其 Planner 与 Synthesizer 分离的设计,使系统能在长 horizon 任务中保持信息聚焦,避免上下文噪声累积。
商业价值
- 降低推理成本:summary 作为持久状态替代全量搜索历史,减少每轮输入 token 数,直接降低 API 调用成本。
- 提升完成率与质量:在 BrowseComp、Xbench-DS 等长程基准上,IterSynth-8B 平均分 50.7,超过同规模最强代理 +4.2%,可减少因上下文溢出导致的非完成失败。
- 模型无关的通用价值:作为 prompting 范式,在前沿闭源模型上零样本提升显著,无需额外训练即可部署到现有产品。
与现有产品/工作流的接口
- 可直接嵌入 LangChain、LlamaIndex 等 agent 框架,替换 ReAct 风格执行循环,或作为自定义 workflow 节点。
- 支持两阶段集成:先以 zero-shot prompting 模式套用,再针对自有数据用 RDPO 微调小模型,平衡效果与成本。
- 训练侧提供 role-decoupled advantage 计算,与现有 RLHF/DPO 管线兼容,可复用 reward model 基础设施。
具体 use case
- 电商平台复杂商品对比:用户查询“适合 4K 视频剪辑的 14 英寸笔记本,续航大于 8 小时,预算 1 万以内”,Planner 分解为多个信息需求,Synthesizer 逐步整合参数、评测、价格,最终生成结构化对比与推荐理由。
- 金融研报自动生成:输入某上市公司名称,Planner 检索财报、新闻、行业数据,Synthesizer 滚动更新摘要,最终输出含估值、风险、竞争格局的研报草稿,减少分析师手动信息整理时间。
局限
- **摘要信息损失**:IterSynth 用摘要状态替代完整搜索历史,虽能降低上下文噪声,但在多轮迭代中可能丢失关键细节,尤其对需要精确检索与多跳推理的任务(如 GAIA)会导致错误证据整合。与 ReAct 保留完整轨迹相比,该方法牺牲了部分可回溯性与细节保真度,需额外机制(如检索辅助或关键点缓存)弥补。
- **训练复杂度较高**:Role-Decoupled Policy Optimization (RDPO) 需要额外训练 turn-level rubric judge 并构建对比轨迹以诱导奖励规则,增加了训练流程的复杂度和计算开销。相比直接使用终局结果奖励的 RL 方法,RDPO 需要更复杂的奖励工程与评估管线,可能限制其在资源受限场景下的复现与推广。
- **实验规模与泛化性有限**:论文主要验证了 IterSynth-8B 在 ≤8B 参数规模下的表现,未展示在更大模型上微调的效果;作为零样本提示范式虽有提升,但提示模板仍需人工设计角色分工与迭代流程,其泛化到其他类型 agent 任务(如代码生成、多模态搜索)的有效性有待进一步验证。