Rufus-Air: 一个开放的 LLM 后训练配方
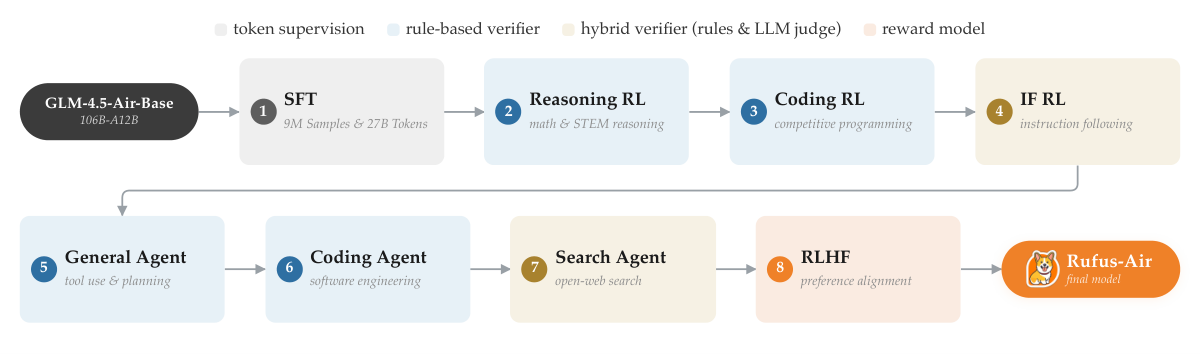
Rufus-Air 是在 GLM-4.5-Air-Base (106B-A12B) 上构建的一套开放、可复现的后训练配方,由八个阶段串联成一条流水线:SFT、Reasoning RL、Coding RL、Instruction-Following RL、General Agent、Coding Agent、Search Agent 与 RLHF。文中完整记录了复现该配方所需的数据、奖励设计、基础设施、阶段顺序以及各阶段结果。 阶段编排遵循两条线索:能力上从基础到高级逐步递进,奖励上从难以作假的硬性可验证信号过渡到更软的 judge 信号。训练全部建立在开源组件与公开数据之上,其中大部分数据按原样使用,既不引入新的人工标注,也不依赖自建的蒸馏教师模型。 主要发现有四点: 1. 多样且高质量的 SFT 奠定了坚实的能力下限; 2. 难度过滤能让 RL 提示词保持在有效的学习区间内; 3. 奖励可靠性为阶段排序提供了可操作的原则; 4. 基础设施与工程选择本身就是配方的一部分,而非单纯的实现细节。 最终,Rufus-Air 优于官方发布的 GLM-4.5-Air 后训练版本,并与同规模的开源模型相比具有竞争力。
论文精读
TL;DR Rufus-Air 公开了一套八阶段 LLM 后训练配方(SFT→推理 RL→编码 RL→指令遵循 RL→各类 Agent→RLHF),基于 GLM-4.5-Air-Base 仅用开源数据和奖励设计,性能超越官方版本,展示了奖励可靠性驱动的阶段顺序与可复现训练工程。
问题
问题背景
当前大模型后训练领域正从“基座能力”转向“系统性配方”竞争:如何将预训练模型稳定地转化为具备推理、代码、指令跟随、智能体等多维能力的生产级助手,成为核心议题。业界普遍关注后训练流程的可复现性与工程化程度,但完整、开放的配方仍属稀缺资源。
现有方法局限
多数后训练工作或聚焦单一阶段(如仅 SFT 或仅 RLHF),或虽涉及多阶段但未公开关键细节:
- 数据与奖励不透明:私有的 SFT 数据、奖励模型或蒸馏教师让外部无法验证结论,甚至无法判断能力提升来自数据、算法还是工程技巧。
- 阶段顺序缺乏系统性论证:先推理 RL 后编码 RL、agentic RL 与 RLHF 的衔接往往凭经验,缺少对“奖励可靠性—学习难度”关系的明确设计原则。
- Agentic RL 工程门槛高:环境接口、分布式 rollout、token 保真等基础设施常被视作实现细节,而非配方的一部分,导致复现时能力损失或训练不稳定。
为什么这个问题难/重要
后训练是一个多阶段串联的复杂系统,每个阶段的数据分布、奖励信号(硬验证 vs. 软判断)和训练动态差异巨大,任何一个阶段的失误都会在后续阶段被放大。难点在于:
- 奖励可靠性需成阶梯:从可验证的数学/代码奖励过渡到基于模型的评判,需保证奖励信号在能力尚弱时足够稠密且无偏。
- 难度过滤决定学习效率:RL 提示若过难或过易,都会导致策略梯度噪声大或收敛停滞,如何自动筛选“学习区间”是工程关键。
- 开放配方的行业价值:可复现的后训练配方能显著降低所有团队从基座到产品的重复试错成本,加速整体迭代。
Rufus-Air 的价值在于将数据、奖励、基础设施、阶段顺序全部开源,并以 GLM-4.5-Air-Base 为底座验证了整个管线的可复现性,为社区提供了一个可执行的“后训练参考实现”。
行业类比
就像软件工程中公开的 CI/CD 模板让团队不必从零搭建部署流水线,Rufus-Air 试图为 LLM 后训练提供一份可复用的“构建配方”,让不同团队能在同一基座上快速对齐能力基线。
核心洞察
- - Rufus-Air 将“奖励可靠性”作为决定 RL 阶段顺序的核心原则,而非单纯按能力递进或任务难度排列。这一角度独特在于,它把可验证的硬奖励(如数学、代码执行)前置,把依赖模型判断的软奖励(如 **RLHF**)后置,从而在训练早期建立稳定的学习信号,后期再引入噪声较高但更贴近人类偏好的信号。相比许多工作只报告最终结果而忽视阶段顺序对稳定性的影响,本文通过八个阶段的逐阶段结果量化展示了该原则的有效性。
- - Rufus-Air 强调训练基础设施和工程选择是配方本身的一部分,而非可忽略的实现细节。论文详细记录了环境接口、代理循环、**token fidelity**、沙箱后端和分布式 rollout 等设计,并论证这些选择直接影响可复现性和最终性能。与许多模型技术报告只侧重算法改进而省略工程约束不同,本文将工程决策显式纳入配方,为社区提供了可操作的复现路径,揭示了后训练中系统工程与算法同等重要。
方法
方法详解
输入为 GLM-4.5-Air-Base (106B-A12B) 与公开数据;全程无新增人工标注、无专有蒸馏教师。八阶段串行执行:SFT → Reasoning RL → Coding RL → Instruction-Following RL → General Agent → Coding Agent → Search Agent → RLHF。
关键模块:
- SFT:多样化高质量指令数据建立能力下限,包括格式遵循、通用知识与工具调用基础。
- 可验证奖励 RL:Reasoning RL、Coding RL、Instruction-Following RL 使用编译器、单元测试、约束校验等硬信号。对提示做难度过滤,只保留模型当前可学的“生产性难度区间”,避免噪声与高方差。
- Agentic RL:General Agent、Coding Agent、Search Agent 引入环境、沙盒后端与工具调用。奖励从任务成功逐步过渡到 judge 软信号,训练多轮 agent loop 与轨迹级策略。
- RLHF:最后用奖励模型在偏好数据上对齐,处理开放式、难以硬验证的目标。
输出为 Rufus-Air 模型,超过官方 GLM-4.5-Air 后训练版本,与同规模开放模型竞争。其核心差异在于:将 agentic RL 纳入完全可复现的串行配方,并以奖励可靠性原则排序阶段,而非仅按任务类型堆叠。
实验
实验设计概述
该工作以 GLM-4.5-Air-Base (106B-A12B) 为底座,公开复现一套后训练流水线:SFT → Reasoning RL → Coding RL → Instruction-Following RL → General Agent → Coding Agent → Search Agent → RLHF。训练完全基于开源组件与公开数据,且大部分数据直接使用发布版本,未引入新的人工标注或内部蒸馏教师。阶段设计从基础到高级能力递进,奖励信号从可验证的硬奖励逐步过渡到基于判断模型的软奖励。
关键发现
文章强调四点:高质量多样化的 SFT 奠定能力下限;难度过滤 将 RL 提示词控制在有效学习区间;奖励可靠性为阶段排序提供实用原则;基础设施与工程选择本身属于配方的一部分。这些发现表明,后训练流程的可复现性不仅取决于算法,也取决于数据过滤、奖励设计和工程实现。
与基线对比解读
Rufus-Air 在评估中超过官方 GLM-4.5-Air 后训练版本,并与同规模开源模型竞争。该结果表明,基于公开数据的开放式后训练配方能够达到或超越专有后训练效果,为行业提供了可复现的参考路径。但论文未给出具体数值,需查阅原文评估章节获取详细指标。
行业影响
落地场景
Rufus-Air 的八阶段后训练配方可直接用于构建 通用对话助手、编程 Copilot、多步 Agent(Search Agent / Coding Agent)等产品。例如电商平台可部署 Search Agent 处理商品检索与比价,内容平台可集成 General Agent 做个性化推荐问答。其阶段设计覆盖从基础指令跟随到复杂工具调用,适配客服、代码生成、信息检索等高频业务。
商业价值
开源可复现配方大幅降低高质量后训练门槛:企业无需大量人工标注或依赖闭源教师模型,通过公开数据与开源组件即可将 GLM-4.5-Air-Base 提升到与同规模开源模型竞争的水平。直接效果是降本(省去标注与蒸馏成本)与体验提升(更强的指令跟随、推理和工具使用能力)。难度过滤与奖励可靠性原则减少无效 RL 计算,提高 GPU 利用率,间接降低训练总成本。
与现有产品/工作流的接口
该配方可嵌入现有 LLM Ops 流水线:SFT 阶段复用已有的指令数据集;RL 阶段支持可验证奖励与 judge 模型,与主流 RLHF 框架(如 TRL / OpenRLHF)兼容。Agent 阶段的环境接口与 sandbox 后端设计可直接对接企业内部的 API 网关或微服务。例如一家企业服务公司可先用自己的客服对话数据做 SFT,再跑 Reasoning RL 和 Search Agent 阶段,快速迭代垂直领域助手,无需从零搭建训练设施。基础设施部分明确给出了分布式 rollout 与 token fidelity 方案,便于集成到 Kubernetes 或 SLURM 集群。
局限
- 仅基于 **GLM-4.5-Air-Base** 单个基础模型验证,未证明配方跨模型架构与规模的泛化性。各阶段数据、奖励设计和顺序可能与该模型特性深度耦合,迁移到其他模型需重新调参甚至重构。论文在 Discussion 中承认未建立最优性,阶段组合是否全局最优、能否简化,仍缺乏系统消融实验或理论指导,限制了其作为通用后训练配方的参考价值。
- 评估主要依赖公开 benchmark 与特定 agent 环境,可能无法充分反映真实世界指令遵循、多轮交互、安全对齐等软性能力。尤其是 Search Agent 和 RLHF 使用 judge-based 信号,评估引入用户模拟器,其分布外泛化与对抗鲁棒性未检验。论文虽与同规模开源模型比较,但并未宣称 SOTA,且未覆盖所有重要能力维度,属于工程复现而非全面评测。
- 计算成本与基础设施要求极高:**106B-A12B** 模型八阶段串行 RL 训练需要大规模 GPU 集群与分布式 rollout 系统,普通团队难以负担。虽然论文提供了详细配置与数据描述,但未公开完整训练代码、数据处理脚本和已训练 checkpoint,实际复现仍需大量工程调优,且可能难以获得完全相同的数据源版本,影响结果可复现性。