GAVEL: 面向可验证且高效的长时程 LLM 任务规划的图世界模型
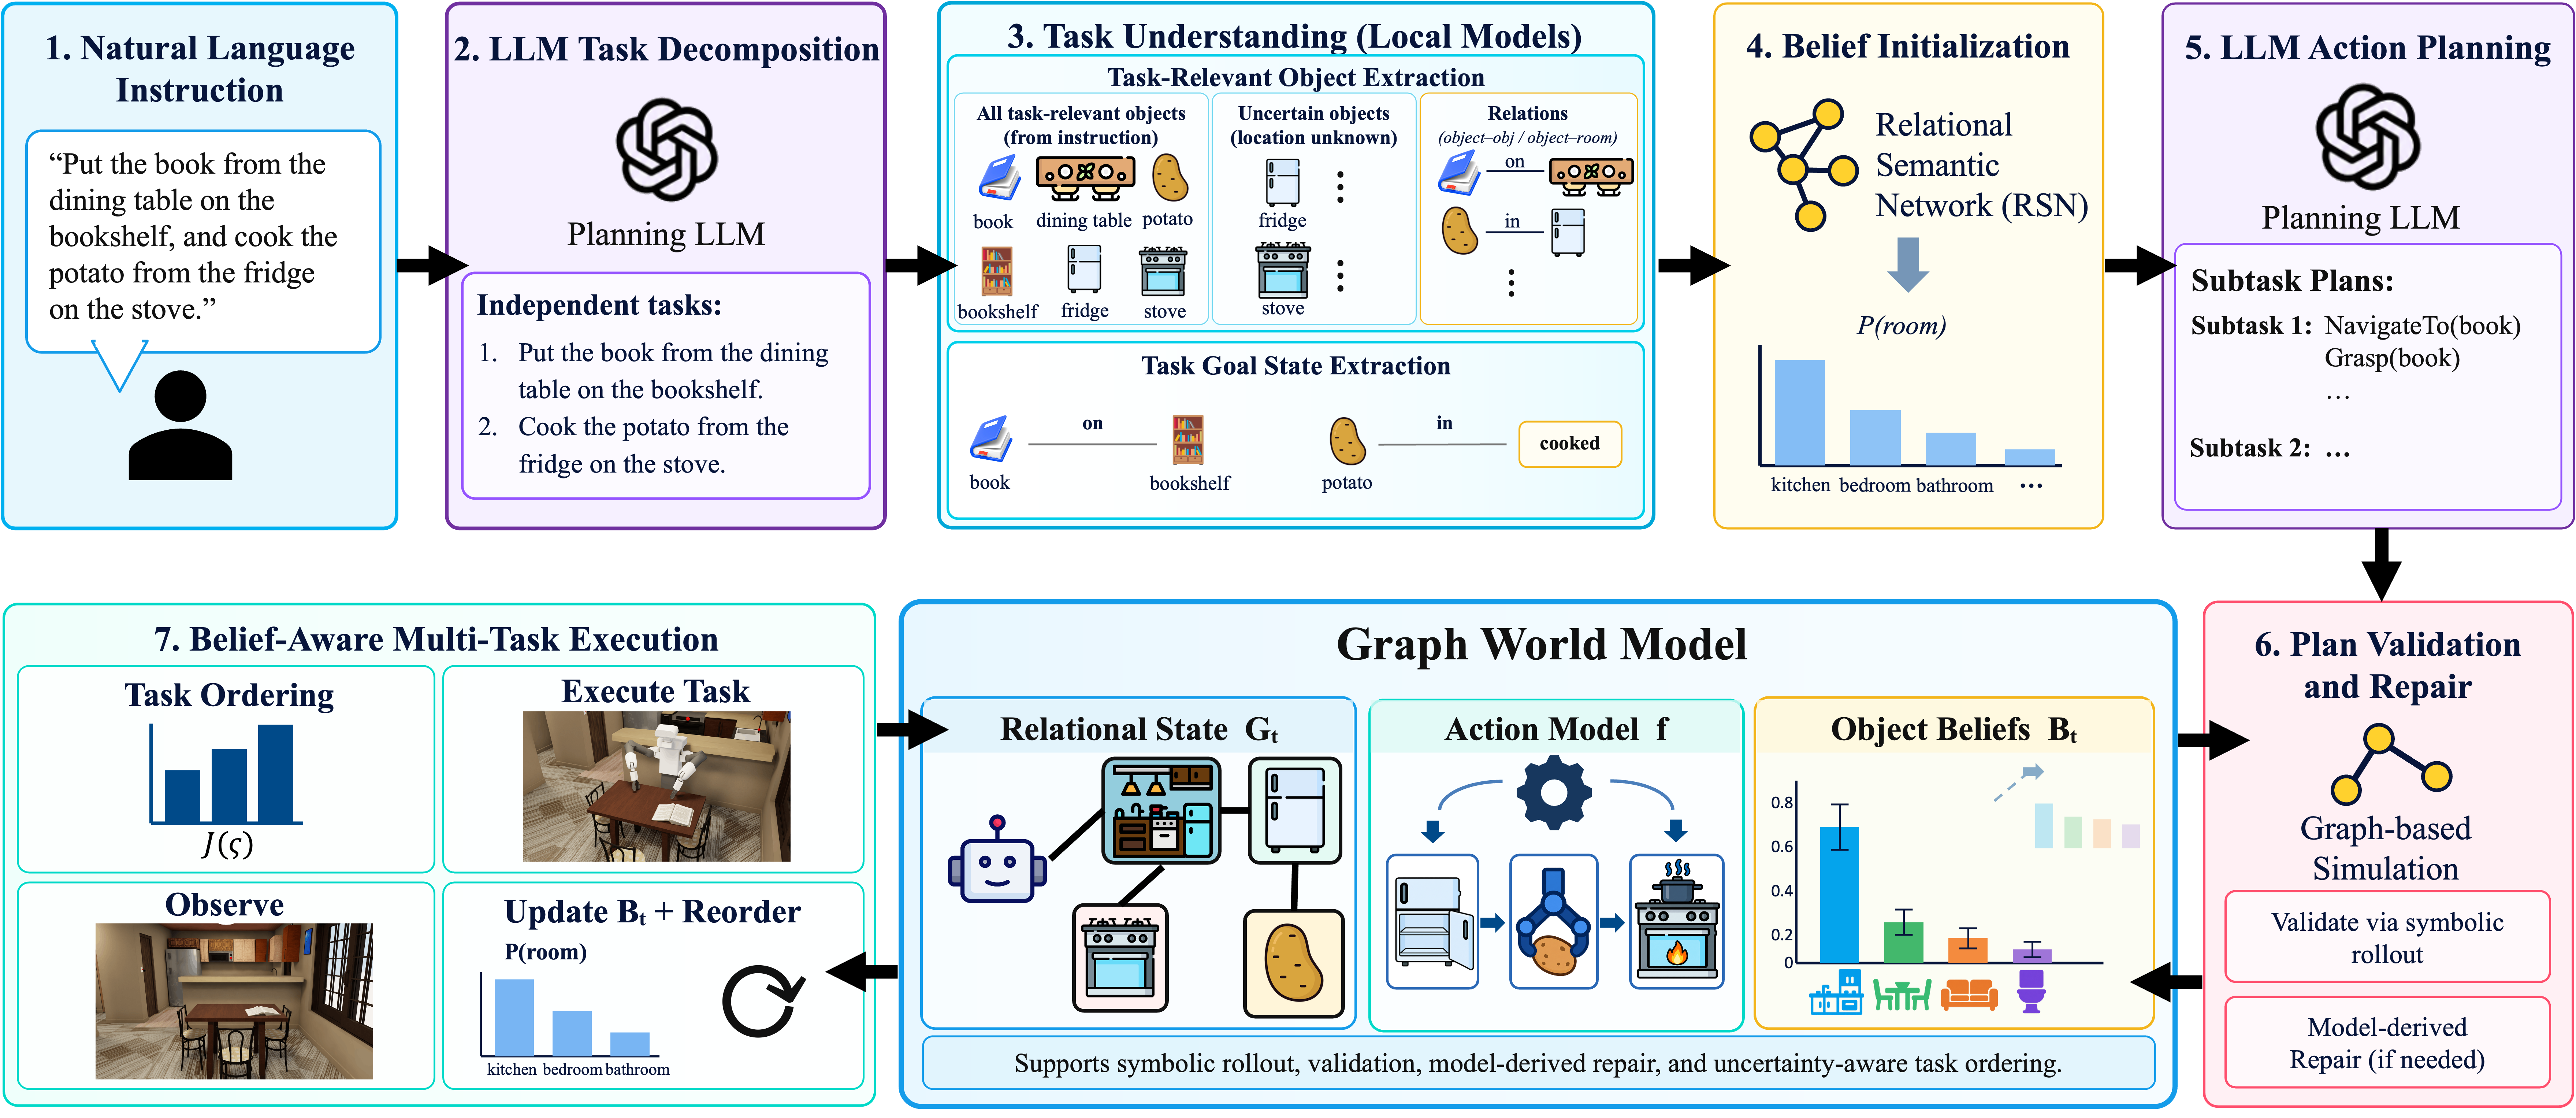
大型语言模型(LLMs)为长时程机器人规划提供了灵活的接口,但生成的计划往往无法满足具身约束、难以从规划错误中恢复,且在部分可观测条件下推理能力有限。 我们提出 GAVEL,一个围绕显式图世界模型(graph world model)构建的长时程 LLM 规划验证与修复框架。该图编码相关的物体关系、动作前置条件与效果,以及未观测物体位置上的概率信念。它能在执行前预测 LLM 所生成动作的后果、检测违规,并直接依据世界模型修复那些修正方式可由模型直接推出的错误;仅将需要语义推理 的错误留给 LLM 重新规划。面对多任务指令时,GAVEL 还会依据物体可能位置的分布对剩余子任务重排序,以最小化期望搜索代价。 我们在 BEHAVIOR-1K 的 100 个单长时程任务与 500 条多任务指令上进行评估。使用 Qwen3-8B 时,单任务成功率从 41.2% 提升至 91.8%,多任务成功率从 19.9% 提升至 92.6%;基于分布信念的推理相比静态变体还将移动距离减少约 5.4%。 这些结果表明,显式图世界模型外壳能显著提升长时程具身规划在紧凑型与前沿托管 LLM 能力下的可靠性与效率。
论文精读
TL;DR GAVEL 用显式图世界模型验证和修复 LLM 生成的长期机器人规划,将 Qwen3-8B 的单任务成功率从 41.2% 提升至 91.8%,多任务从 19.9% 提升至 92.6%,把 LLM 重规划限制在语义推理必需处。
问题
问题背景:长程机器人任务规划中,LLM 被用于将自然语言指令转化为动作序列,但生成计划常因缺少执行前验证而失败。
现有方法局限:现有方法主要依赖 LLM 直接生成动作序列,缺乏显式的世界模型来预测动作后果、检查前置条件或更新环境状态。这导致三类问题:
- 可执行性差:计划可能违反 embodiment 约束(如不可达位置、错误对象交互),直到执行时才暴露;
- 错误恢复难:一旦失败,系统往往只能整体重规划,缺乏局部修复机制,成本高且不稳定;
- 部分可观测性处理弱:面对未知物体位置等不确定信息,LLM 难以进行概率推理,常忽略或错误假设。
为什么难/重要:长程任务动作空间大,组合复杂性高;必须在 LLM 语义灵活性与符号验证的确定性之间取得平衡。同时,在部分可观测条件下维护概率信念并据此优化任务顺序,对实时性和可解释性要求很高。这要求工程上构建可验证的中间表示(如场景图与概率图模型),而非单纯依赖 prompt 工程;该路径直接关系到 LLM 在物理世界中的可信部署,受到工业界广泛关注。
行业类比:如同在 LLM 代码生成中引入编译器静态检查与自动修复,GAVEL 为机器人规划提供了一层执行前验证与修复机制。
核心洞察
- 图世界模型作为 LLM 规划的可验证载体,将执行前验证与常规修复从 LLM 推理中解耦。与依赖提示工程或失败后整体重规划的 LLM 规划方法不同, GAVEL 用显式图结构记录对象关系、动作前提与效果、概率信念,在执行前预测动作后果并检测违规,对可直接推导的修正直接在图上完成,只有当错误涉及语义理解时才调用 LLM replanning。这降低了 LLM 调用频率与不确定性,提高了长程任务的执行可靠性,在 BEHAVIOR-1K 上单任务成功率从 41.2% 提升至 91.8%。
- 概率信念感知的任务排序,将部分可观测性下的搜索代价最小化纳入任务调度。与以往基于已知世界状态或 LLM 按固定顺序执行多任务指令的方法不同, GAVEL 维护对象位置的概率分布,并据此对剩余子任务进行重排,以最小化期望旅行/搜索距离。实验显示分布信念推理相比静态变体减少约 5.4% 旅行距离,而且多任务成功率提升至 92.6%。该机制显式建模不确定性对执行效率的影响,是长期任务中少有的将信念状态与规划优化结合的方法。
- 分层错误处理机制:图模型修复常规错误,LLM 仅作语义重规划。这不同于一遇到规划失败就调用大模型重新生成整个计划的 baseline,也不同于完全依赖符号 PDDL 的硬编码系统。GAVEL 把可形式化的前提/效果违规交给图世界模型即时修复,节省了 LLM 推理时间和 token 成本,同时保留 LLM 对复杂语义指令和非常规错误的泛化能力。实验在小模型 Qwen3-8B 上即达到 91.8% 单任务成功率,说明通过结构化验证可以显著弥补模型容量不足,对资源受限场景有工程价值。
方法
输入与任务理解
GAVEL 接收自然语言指令(单任务或多任务)与当前环境的观察结果,其中对象位置可能部分不可观察。框架首先通过 任务理解模块 提取任务相关对象与目标状态,作为后续规划的约束条件。
关键模块与流程
- 信念初始化:维护一个关于未观察对象位置的概率分布,利用场景图与先验知识初始化信念状态。
- LLM 动作规划:调用 LLM 生成候选动作序列,充分利用其语义理解和长程规划能力。
- 图世界模型:显式构建图结构,节点为对象与状态,边表示对象关系、动作前置条件与效果。该模型可预测任意动作执行后的世界状态变化。
- 计划验证与修复:在执行前用图世界模型验证每个动作的可行性,检测前置条件缺失或状态冲突。对于可由图模型直接推导的修正(如补上缺失的预动作),自动修复;仅当错误涉及复杂语义判断时才触发 LLM 重规划,减少昂贵调用。
- 信念感知多任务执行:对多任务指令,基于对象位置分布计算剩余子任务的重排顺序,最小化期望搜索成本(近似旅行商问题),提升执行效率。
输出
输出为经过验证和修复的可执行动作序列,并在多任务场景下动态调整子任务顺序。
该方法将 LLM 的开放语义规划与显式可验证的图世界模型结合,后者作为“安全带”保障物理可行性,同时避免频繁重新调用 LLM。
与同类方法的差异点:不同于仅依赖 LLM 端到端生成或纯符号规划,GAVEL 用图世界模型承接可形式化验证、修复与部分可观察下的概率推理,将 LLM 保留给语义级错误处理,从而在可靠性与效率之间取得平衡。
实验
实验设计
在 BEHAVIOR-1K 基准上,评估 GAVEL 与直接 LLM 规划(使用 Qwen3-8B)的性能。测试集包括 100 个单任务长程任务和 500 个多任务指令。还引入一个 静态变体(不使用分布信念推理)作为消融,以量化信念感知任务排序的收益。
关键发现
- GAVEL 将单任务成功率从 41.2% 提升至 91.8%(+50.6 个百分点)
- 多任务成功率从 19.9% 提升至 92.6%(+72.7 个百分点)
- 分布信念推理使机器人移动距离减少约 5.4%
这些结果表明,显式图世界模型能够有效验证和修复 LLM 动作,并优化部分可观测下的任务顺序。
对比解读
多任务场景的提升幅度更大,可能因为信念感知排序将 LLM 重规划限制在语义错误上,而常规错误由世界模型直接修复,减少了无效探索。静态变体虽然也使用图世界模型验证,但缺少对物体位置分布的推理,导致次优的任务执行顺序,增加移动开销。这一对比凸显了信念建模在长程规划效率中的关键作用。
行业影响
落地场景
GAVEL 的核心能力是验证并修复 LLM 生成的长期任务规划,特别适合机器人、智能家居和工业自动化领域。典型产品包括:
- 家庭/商用服务机器人:接收自然语言指令如“整理客厅并准备晚餐”,需要拆解多步骤操作并验证可行性(如物品位置未知、机械臂可达范围限制)。
- 仓储物流机器人:处理“从 A 区取货、B 区取货、打包后送往发货区”等多任务指令,需优化顺序并应对部分可观测环境。
- 智能家居中枢:协调多个设备执行复杂场景(如“离家模式”),验证每个动作的前提条件(门窗关闭、安防布防)是否满足。
商业价值
- 降本:将单任务成功率从 41.2% 提升至 91.8%、多任务成功率从 19.9% 提升至 92.6%(Qwen3-8B 上),意味着大幅减少执行失败后的重试和人工接管,显著降低运维成本。
- 增收:更高可靠性使机器人能承担更复杂的长周期任务,拓展可销售场景(例如从单一搬运升级为多步骤仓内作业)。
- 体验提升:用户下达复杂指令后机器人能自主验证、修复并完成,提升对自动化系统的信任。
与现有产品/工作流接口
GAVEL 可作为规划验证中间层,插入 LLM 规划器与机器人执行器之间:
- LLM 生成动作序列后,GAVEL 利用图世界模型预测动作后果,检测违规(如缺少前提、违反 embodiment 限制);
- 对可由世界模型直接修复的错误立即修正,仅对语义级错误触发 LLM 重新规划;
- 与现有 ROS、行为树、PDDL 规划栈集成时,可将其作为独立的符号验证模块,不需要重构整个 pipeline。
具体落地 use case
- 电商仓储机器人:接到指令“从 A 区取商品 X 和 B 区取商品 Y,打包后放到发货区”。GAVEL 验证每个子任务前提(商品位置是否已知、机械臂是否可及),利用概率信念对未观察位置进行推理,重新排序子任务以最小化期望搜索成本(论文报告约 5.4% 移动距离缩减),直接适用于类似 Amazon Kiva 的仓储自动化方案。
- 医院配送机器人:执行“去药房取药,送到 302 病房,再回收餐盘”。环境部分可观测(病房门是否关闭、电梯占用),GAVEL 的概率信念可处理位置不确定性,并在规划出错时自动修复,避免机器人卡死或需要护士干预。
该框架已开源(arXiv:2609.19315),可直接作为模块嵌入现有机器人控制栈。
局限
- 图世界模型的构建和信念初始化依赖较高质量的场景图与对象关系标注。在 BEHAVIOR-1K 仿真中这些信息可由模拟器直接获取,但迁移到真实环境或新领域时,需要额外的感知与关系提取模块,且可能引入噪声。论文未讨论图模型的自动构建或跨域适应性,限制了其开箱即用的能力。
- 分布式信念推理虽然在多任务排序中减少了旅行距离,但实验中的信念分布更新机制较为简单,依赖对象位置的先验假设和有限观测。在高度动态或敌对环境(如物体被频繁移动或遮挡)下,概率分布可能失真,导致任务排序优化失效。此外,与静态变体相比仅提升 5.4%,边际收益较小,可能被维护信念状态的计算开销所抵消。
- 虽然 GAVEL 显著提升了成功率,但系统整体延迟与计算开销未充分评估。每次 LLM 生成动作后都需进行图模型验证与潜在修复,若需多轮 LLM 重规划,可能增加端到端执行时间。对于实时性要求较高的机器人任务,该开销可能成为瓶颈。另外,实验仅使用 Qwen3-8B,未展示对更强或更弱 LLM 的鲁棒性,方法是否与 LLM 能力解耦尚待验证。