UFO: 面向多模态图像生成中全条件对齐的链式评估
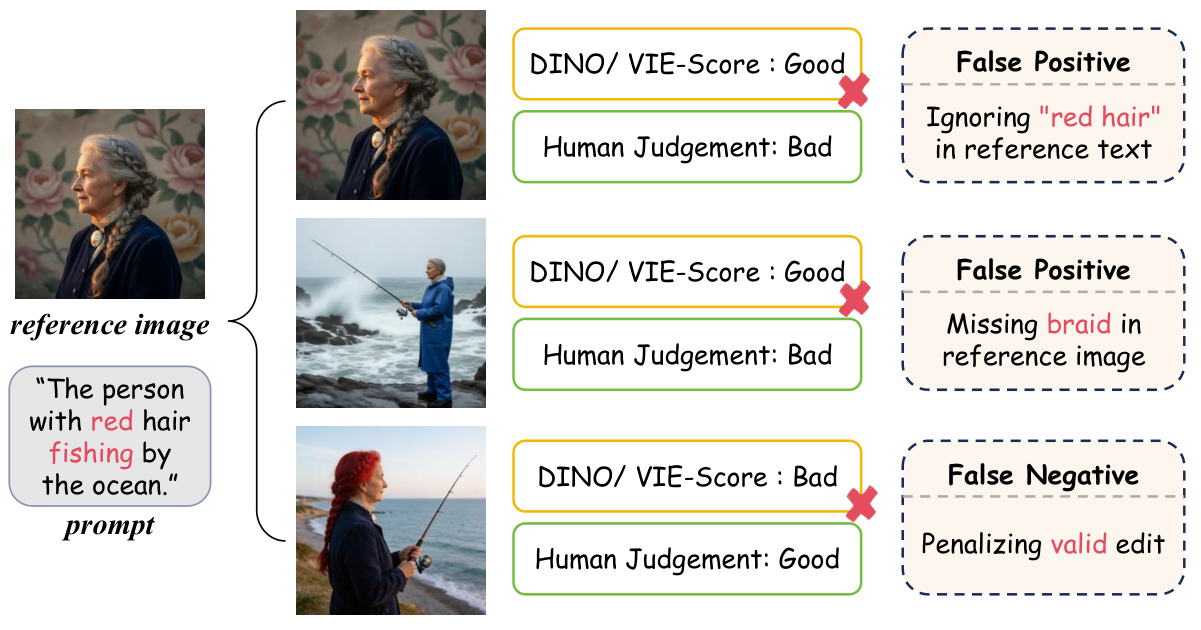
多模态图像生成,尤其是主体驱动定制 ,近些年受到越来越多关注。尽管生成模型发展迅速,其评估方法却明显滞后。现有方法无论是基于嵌入 还是基于多模态大语言模型(MLLM) ,都对各模态条件进行孤立评估,这与多模态图像生成需要同时对齐多个条件的目标相矛盾,导致与人类判断的一致性较差。 为解决这一问题,我们提出 UFO,这是首个用于全条件对齐 同时评估的统一框架。具体而言,UFO 引入了新颖的原子化链式评估(Atomized Chain-of-Evaluation) 范式:首先将全条件对齐分解为一系列细粒度、解耦的原子评估单元(AEU) 构成的链,并将其归类为不同的模态相关性类别,然后针对不同类型的 AEU 采用通用或专用的功能调用进行精确验证。 实验结果表明,UFO 与人类评估偏好的相关性最高,平均提升 15.25%。此外,我们还提出了 UFO-Bench,一个专门设计的基准,用于在文本与视觉条件的多种相互交互下,全面评估现有定制模型的性能。
论文精读
TL;DR UFO 框架统一评估多模态图像生成的全条件对齐,通过原子化评估链分解细粒度单元,与人类判断相关性平均提升 15.25%,并配套 UFO-Bench 基准。
问题
问题背景
多模态图像生成,尤其 subject-driven customization,已成为内容生成领域的热点,但评估体系明显滞后于生成模型的发展。
现有方法局限
当前评估方法主要分两类:
- Embedding-based(如 CLIP score / DINO score)分别计算生成图与文本、参考图的特征相似度,但无法捕捉复杂语义关系,且对属性绑定、空间关系等细粒度要求不敏感。
- MLLM-based 方法虽然能理解语义,却通常将文本对齐和视觉对齐视为独立问题分别打分,忽略多条件同时满足时的相互影响。例如,当文本要求“戴着红帽子的猫”且参考图是一只白猫时,模型可能既保留了白猫身份又错误添加红帽,单独打分均高,但整体不符合人类期望。
这种 孤立评估 违背了多模态生成“同时满足所有条件”的核心目标,导致与人类判断相关性差。
为什么这个问题难且重要
难点在于不同模态条件之间存在 耦合与权衡:一个条件满足可能以牺牲另一个条件为代价。评估器需要将整体对齐目标分解为可验证的原子单元,并在推理链中联合考虑,这对现有 MLLM 的推理能力提出更高要求。同时,缺乏覆盖多样化模态交互(冲突、互补、重叠)的统一基准,使得模型改进缺乏可靠反馈信号。从工程角度看,评估是迭代优化的前提,低质量评估会误导模型选型与调优方向。
行业类比
与推荐系统中需要同时优化相关性、多样性与用户意图的多目标排序类似,单指标各自达标不代表整体体验好,必须采用联合评估框架来驱动系统迭代。
核心洞察
- 从“逐条件独立打分”到“原子化链式评估”的范式转变,以模拟人类对多模态条件同时满足的整体判断。现有 embedding 或 MLLM 方法分别计算文本与视觉相似度再简单聚合,忽略条件间交互,导致与人类判断不一致。UFO 将全条件对齐分解为细粒度 AEUs 并顺序验证,能捕捉跨模态依赖关系,因此与人类偏好相关性平均提升 15.25%。其独特之处在于把评估从静态相似度计算重构为动态证据链构建,更符合多条件生成任务本质。
- 用“模态相关性分类 + 功能调用”架构实现了可解释、可扩展的评估系统。UFO 将 AEUs 按纯文本、纯视觉、跨模态交互分类,针对不同类别选用通用 VQA 或专用函数调用(如人脸验证、OCR)进行精确验证。这避免了单一 MLLM 统一打分对跨模态组合的偏差,同时因为 AEU 与验证器解耦,新增条件类型或域外测试时只需扩展功能调用,无需重新训练评估器。相比依赖固定 embedding 空间或整体 MLLM 输出的方法,UFO 提供了模块化、可审计的评估工程范式。
- UFO-Bench 揭示了现有定制模型在文本-视觉条件相互作用下的系统性缺陷,为模型迭代提供诊断依据。该基准不仅评估单条件对齐,还设计了属性覆盖、角色绑定、冲突消解等多样化交互场景。结果暴露出多数模型在孤立条件下尚可,但在条件相互干扰时性能显著下降。这种以交互为中心的基准设计更贴近实际生成场景(用户常同时指定主体与文本修改),推动模型从单条件可控向全条件协同进化,并能定位具体失败模式,优于以往只关注单条件或简单组合的基准。
方法
输入与总体流程
输入包括:生成图像、文本条件 prompt、视觉条件参考图像。UFO 旨在对全条件对齐进行同时评估,输出一个与人类偏好高度相关的对齐得分。
关键模块
AEUs 分解:将全条件对齐分解为一系列细粒度、解耦的原子评估单元 (AEUs)。每个 AEU 对应一个可独立验证的属性,例如主体身份保持、文本属性匹配、姿态/风格一致性等。
模态相关性分类:根据 AEU 所依赖的条件类型,将其划分为纯文本相关、纯视觉相关、跨模态交互相关等类别。该步骤避免将不同性质的条件混为一谈,从而提升评估的针对性。
评分模块:
- 对文本相关 AEU:采用 MLLM 的视觉问答 (VQA) 方式,输出语义符合性分数。
- 对视觉相关 AEU:调用专用函数(如 CLIP 相似度、人脸识别、关键点检测等)进行精确验证。
- 对跨模态交互 AEU:结合文本与视觉信号进行综合判断。
加权聚合:将各 AEU 的分数按预设权重或动态重要性加权求和,得到最终的全条件对齐分数。
输出与差异
最终输出为 0-1 的 omni-condition alignment 得分。与之前 embedding-based 或 MLLM-based 方法仅评估单一模态条件不同,UFO 的链式评估结构显式建模了多模态条件间的相互影响,更贴合多模态图像生成同时满足文本与视觉条件的评估目标。
实验
实验设计
论文提出 UFO-Bench,专门评估多模态图像生成(尤其是 subject-driven customization)在文本与视觉条件相互交互下的表现。UFO 采用 Atomized Chain-of-Evaluation:将全条件对齐分解为细粒度、解耦的 Atomic Evaluation Units (AEUs),按模态相关性分类,再调用通用或专用函数调用进行精确验证,最后加权聚合得到综合评分。实验与多种现有评估方法对比,并测量其与人类评估偏好的一致性。
关键发现
UFO 在所有对比方法中取得了与人类评估偏好的最高相关性,平均提升 15.25%。这一结果表明,将全条件对齐同时评估、而非孤立评估各模态条件,能够显著提高评价的可靠性。UFO-Bench 揭示了现有定制化模型在文本和视觉条件存在相互干扰时的性能差异,为后续改进提供了系统基准。
与基线对比解读
现有方法(embedding-based 或 MLLM-based)通常单独评估每个模态条件的对齐程度,这与多模态图像生成同时满足所有条件的目标相矛盾。UFO 通过链式分解和函数调用,更贴近人类对多条件一致性的判断逻辑,因此相关性更高。该框架对实际工程的启示:评估多条件生成模型时,应设计能够捕捉条件间相互作用和冲突的自动化流程,而非简单拼接单模态指标。
行业影响
落地场景
UFO 可直接嵌入 电商商品图生成、虚拟试穿、游戏角色定制 等 subject-driven 生成业务。例如:电商平台用参考商品图 + 文本描述批量生成多角度展示图,UFO 自动评估生成图是否同时满足“保持商品外观”与“环境 / 风格文本条件”。内容平台可用其过滤用户上传的二次创作图,保证角色形象一致性与风格适配。
商业价值
- 降本:替代人工抽检生成结果,尤其在高并发生成场景,降低审核人力成本;UFO 与人类偏好相关性高(平均提升 15.25%),减少误筛导致的重生成浪费。
- 体验提升:作为生成后质量门禁,减少用户收到“货不对版”图像,提升平台信任度。
- 增收:加速模型迭代,UFO 可作为 reward model 参与 RLHF 或 prompt 优化,缩短 A/B 测试周期。
接口与集成
UFO 提供 原子化评估单元(AEU) 与 函数调用 接口,可封装为独立评估服务(如 POST /evaluate),输入生成图、文本条件、参考图,输出各维度得分与聚合分。现有生成管线只需在推理后追加一个评估节点,即可实现实时筛选或批量离线评测。UFO-Bench 可直接用于横向对比不同定制模型,适合作为模型选型基准。
局限
- **评估框架依赖 MLLM 与函数调用的可靠性**。UFO 将 omni-condition alignment 分解为原子评估单元(AEUs),并通过通用或专用函数调用验证。然而,MLLM 本身对细粒度视觉属性(如材质、光影、空间关系)的识别准确率有限,可能引入认知偏差;专用函数通常针对特定属性设计,泛化到未见过的条件类型或复杂场景时可能失效。此外,函数调用的错误传播会累积到最终评分,影响与人类判断的一致性。
- **UFO-Bench 的覆盖范围与规模有限**。论文提出的基准聚焦于 subject-driven customization,可能无法全面反映多模态图像生成在其他任务(如纯文本条件、多参考图融合、风格迁移等)上的 omni-condition alignment。基准中文本与视觉条件的交互模式种类(如冲突、互补、冗余)可能未穷举,且数据规模若不够大,统计显著性可能不足。此外,基准构建中的人工标注可能存在主观性,影响评估结果的稳健性。
- **计算成本与可扩展性挑战**。将评估分解为多个 AEU 并逐一调用函数,相比单一的 MLLM 评分或 embedding 相似度,计算开销显著增加,可能不适用于大规模模型筛选或在线评估。同时,AEU 的分解规则和加权聚合方式需要针对不同任务手动调整,自动化程度和可迁移性有待验证。与现有轻量级评估指标相比,部署门槛更高。