VA-Bench: 通过视觉示范、主动感知与度量控制衡量具身空间智能
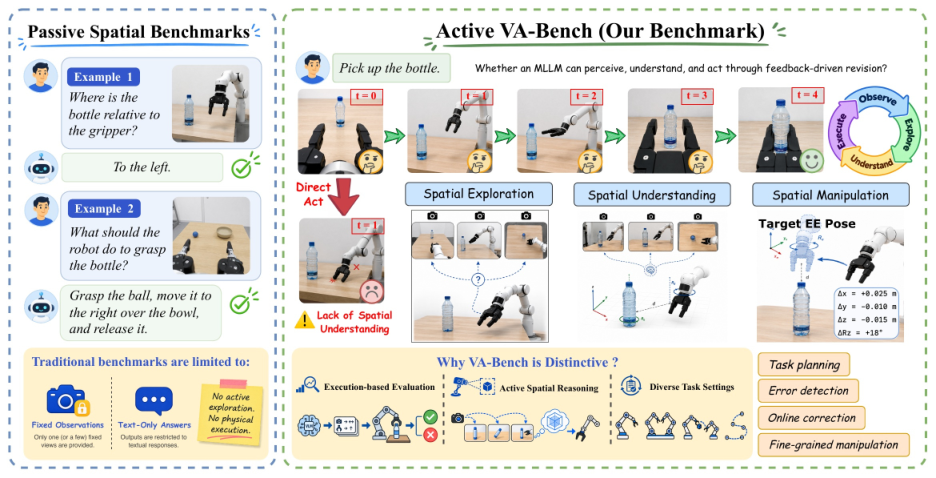
空间智能不止于描述物体位置。在观测不完整时,模型必须自行识别并获取缺失的证据,将其统一到共同的空间坐标系中并据此行动。VA-Bench 用于评测完整的「观察—推理—行动—修正」闭环。 通用 MLLM 仅从纯 RGB 示范中学习流程上下文,主动选择相机视角,输出度量级笛卡尔指令,并根据执行反馈进行修正。模型无法获得特权物体位姿、oracle 轨迹或预训练动作头;一个固定的、与模型无关的控制器只执行模型指定的目标。该基准包含 14 个基础任务族(11 个单臂、3 个双臂)、7 个留出的几何/布局变体,以及一条长时程五物体组合轨迹。 评测覆盖 12 种主模型设定,在每项基础任务同一组 20 个经物理验证的随机种子上独立运行三次,报告最终成功率、九项轨迹级行为诊断指标与子任务进度。结果如下: 1. 最佳模型在标注运行中目标定位达 100.0%、空间关系达 78.9%,但三次运行的宏平均任务成功率仅 53.93±3.17%; 2. 主动相机控制显著优于被动多视角观察,一项配对比较中成功率由 27.86% 升至 57.50%; 3. 留出几何迁移可使成功率下降超过 30 个百分点; 4. 没有任何模型能完成严格的长时程回合。 因此,VA-Bench 检验的是:通用 MLLM 能否把视觉示范与主动获取的证据转化为成功的具身动作。
论文精读
TL;DR VA-Bench 评估通用多模态大模型在部分观测下的具身空间智能完整循环:基于视觉演示、主动选视角、发度量命令并修正,发现主动感知显著提升成功率,但几何泛化与长程任务仍是瓶颈。
问题
问题背景:具身智能正从静态感知转向 观察-推理-行动闭环,视觉语言模型(MLLM)在桌面操作任务中的空间理解与决策能力成为研究热点。
现有方法局限:多数机器人操作基准存在以下简化:1) 依赖特权信息如物体 6D 位姿,模型无需从原始视觉推断空间关系;2) 固定摄像头视角,缺乏主动选择观察角度的能力;3) 演示数据包含动作标签(关节角度或末端位姿),泛化至新布局时脆弱;4) 评估仅报告最终成功率,缺乏轨迹级诊断,难以定位失败环节。VABench 取消这些简化,要求模型只从 RGB 演示学习 procedural context,主动选择相机视角,输出公制笛卡尔命令,并根据执行反馈修订。
为什么难且重要:主动感知与度量控制结合对通用模型构成根本挑战:模型必须在不同视角间建立空间一致性,将二维像素证据映射到机器人基座坐标系下的三维命令,并在失败时判断是感知错误还是动作错误。从视觉演示中提取可迁移的任务流程要求理解操作语义与几何约束,而非简单模仿轨迹。业界高度关注通用 MLLM 在真实操控中的泛化能力,若能自主获取信息并输出可执行命令,将显著降低机器人编程成本并提升对非结构化环境的适应性。
行业类比:类似自动驾驶中车辆根据传感器输入自主决策路径并控制执行,机器人操作同样要求将感知证据转化为度量空间中的动作序列,而 VABench 将这一过程引入桌面操作场景进行系统评估。
核心洞察
- - VA-Bench 将具身空间智能评估从被动接收完整观察的定位描述,推进到不完整观察下主动获取证据并发出度量控制命令的闭环。与常见机器人基准提供多视角图像或特权物体位姿、并允许 oracle 轨迹或专用动作头不同,VA-Bench 强制通用 MLLM 仅从 RGB-only 演示学习上下文,自主选择相机视点,输出 metric Cartesian 目标,再根据执行反馈修正。这种 observe-reason-act-revise 协议更贴近真实部署,让评估不再偏向视觉问答或策略模仿,而是直接检验模型的空间推理与行动闭环能力。
- - 主动相机控制是通用 MLLM 在具身任务中获取显著性能提升的关键杠杆,其收益超过被动接收多个固定视角。论文 matched comparison 显示任务成功率从 27.86% 升至 57.50%,说明“何时查看何处”的决策本身就是空间智能的一部分。同类工作通常把主动感知作为外部模块或强化学习策略,而 VA-Bench 将相机选择纳入模型原始输出空间,直接测试模型在不确定性下的信息寻求能力。这一设计对实际工程的意义在于:若系统能自主决定观察时机和角度,即便底层控制为固定控制器,也能大幅提升任务成功率,为模块化 VLM-VLA 控制提供优化方向。
方法
输入
模型接收 RGB-only 视觉演示和当前单视图观测,无特权物体位姿、oracle 轨迹或学习动作头。演示提供任务程序上下文;当前观测不完整,模型需在每个交互回合输出一个主动相机动作以获取缺失证据。
关键模块
- 演示条件空间重定位:从 RGB 演示中提取目标物体与场景的空间关系,将当前观测映射到共同空间框架,避免依赖绝对位姿。
- 主动感知:模型在受限相机动作空间内选择下一视点(平移/旋转),替代被动多视图输入,通过信息增益驱动探索。
- 度量控制:模型直接输出以米为单位的笛卡尔坐标目标位姿,由固定模型无关控制器执行,不使用策略网络或动作头。
- 执行反馈与修正:模型收到执行结果后更新状态,可修改后续命令,形成观察-推理-行动-修正的闭环。
输出
评测输出包括终端成功率、九种轨迹级行为诊断(目标定位、空间关系、探索信息量、操作语义等)以及子任务进度。基准覆盖14个基础任务族(11个单臂+3个双臂)、7个几何/布局变体、长时程合成赛道,每个任务基于20个物理验证种子,采用三独立运行取均值。
差异点
与传统具身基准相比,VA-Bench 严格移除特权信息与学习动作头,强制通用 MLLM 通过主动视觉证据获取和度量命令闭环完成操作,更接近真实机器人部署条件。
实验
实验设计
- 基准:VA-Bench 包含 14 个基础任务族(11 单臂 + 3 双臂)、7 个 held-out 几何/布局变体、5 物体长程组合 track。
- 协议:3 次独立运行 × 20 个物理验证种子,固定模型无关控制器执行模型指定 metric Cartesian 目标;模型仅从 RGB 演示获取程序上下文,可主动选择相机视角。
- 评估:终端成功率 + 9 项轨迹级行为诊断 + 子任务进度。
关键发现
- 最佳模型在标注运行中 目标定位 100.0%、空间关系 78.9%,但三跑宏平均任务成功率仅 53.93±3.17%,显示感知-行动闭环仍有断层。
- 主动相机控制 显著优于被动多视图:匹配对比中成功率 27.86% → 57.50%。
- Held-out 几何迁移可导致成功率下降 超过 30 个百分点;严格长程 episode 无模型完成,虽有一定部分进展。
基线对比解读
- 通用 MLLM 在没有特权物体位姿、oracle 轨迹、learned action head 条件下,虽能理解演示和局部感知,但“观察-推理-行动-修订”闭环的鲁棒性不足。
- 主动感知的 +29.64 个百分点提升说明:合理信息获取策略比增加输入视图更重要,为实际工程中设计主动感知模块提供依据。
- 几何泛化大幅下降暴露了模型对训练分布布局的依赖,提示在真实部署中需要结合几何先验或在线重定位。
行业影响
落地场景
VABench 评估的具身空间智能能力可应用于仓储物流机器人、柔性制造装配、服务机器人操作、自动驾驶近距离交互(如自动泊车)以及 AR/VR 空间交互设备。具体用例:电商仓库中机械臂从杂乱料箱拣选指定 SKU,需根据视觉演示理解任务、主动调整相机视角确认物体位置与抓取姿态;医疗辅助机器人根据示教视频完成器械递送,需在遮挡下主动探索并输出精确笛卡尔坐标。
商业价值
该基准提供统一、可复现的模型评估协议,帮助机器人公司与集成商降低模型选型和迭代成本。通过主动感知对比与轨迹级诊断,团队可快速定位模型失败环节(目标定位、空间关系、操控语义),减少真机调试次数与数据采集开销。对通用 MLLM 供应商,VABench 可作为面向具身操作的垂直能力证明,提升产品溢价;对终端用户,更高的任务成功率直接转化为更少人工干预和更高吞吐,推动机器人服务订阅或按件计费模式落地。
与现有产品/工作流接口
VABench 的模型无关控制器与固定执行协议可嵌入现有机器人开发栈:在 ROS 2 环境或自研仿真平台中,将 VABench 场景作为回归测试集接入 CI/CD 流水线,每次模型版本更新自动跑基准并输出成功率与行为诊断报告。与数据飞轮结合,可筛选出几何泛化失败的种子,定向采集更多演示数据,提升模型鲁棒性。也可将主动相机控制策略作为插件,与现有 VLA(视觉-语言-动作)模型或分割/抓取模块协同,先评估空间智能再决定是否切换到高成本真机验证。
局限
- **基准规模与多样性有限**:VABench 包含 14 个基础任务族(11 单臂 + 3 双臂),每个任务仅 20 个物理验证种子,实例总数约 280 个,相对整个 embodied AI 任务空间仍显稀疏。控制变量主要改变几何布局,未充分覆盖物体材质、光照、遮挡、动态扰动等现实因素;长时程组合轨迹仅一个五物体场景,统计效力不足。模型在该基准上的表现无法完全外推到真实应用,且论文未进行真实机器人实验或 sim-to-real 迁移验证,物理验证可能只做了初始位置检查,不足以证明现实可行性。
- **演示条件重接地引入潜在偏差**:模型依赖人工录制的 RGB 视频演示来推断空间约束,但演示生成策略与视角选择是否具备代表性和最优性未明确,可能携带人类操作偏好。论文对演示摘要来源的消融显示不同摘要模型会显著影响下游性能,表明方法对演示摘要质量高度敏感。这导致基准无法完全独立评测模型固有的空间推理能力,因为模型可能过度依赖演示中的线索而非从原始观察中自主推理,削弱了评测公平性与泛化结论的可靠性。
- **与同类基准相比评估维度受限**:VABench 采用固定模型无关控制器,模型输出 metric Cartesian 目标命令,不支持连续力控或接触丰富操作,因此对需要精细力反馈或柔顺控制的任务(如插入、拧紧、装配)可能被简化或排除。主动摄像头控制虽然引入交互,但相机动作被限定为少量离散视角,无法反映真实场景中连续、实时的主动感知。整体上基准偏重高层决策与空间理解,低估了底层执行鲁棒性,与 RLBench、BEHAVIOR 等更全面的基准存在差距。