样本数量并非全部:候选生成策略决定 LLM 测试时扩展的能耗与性能
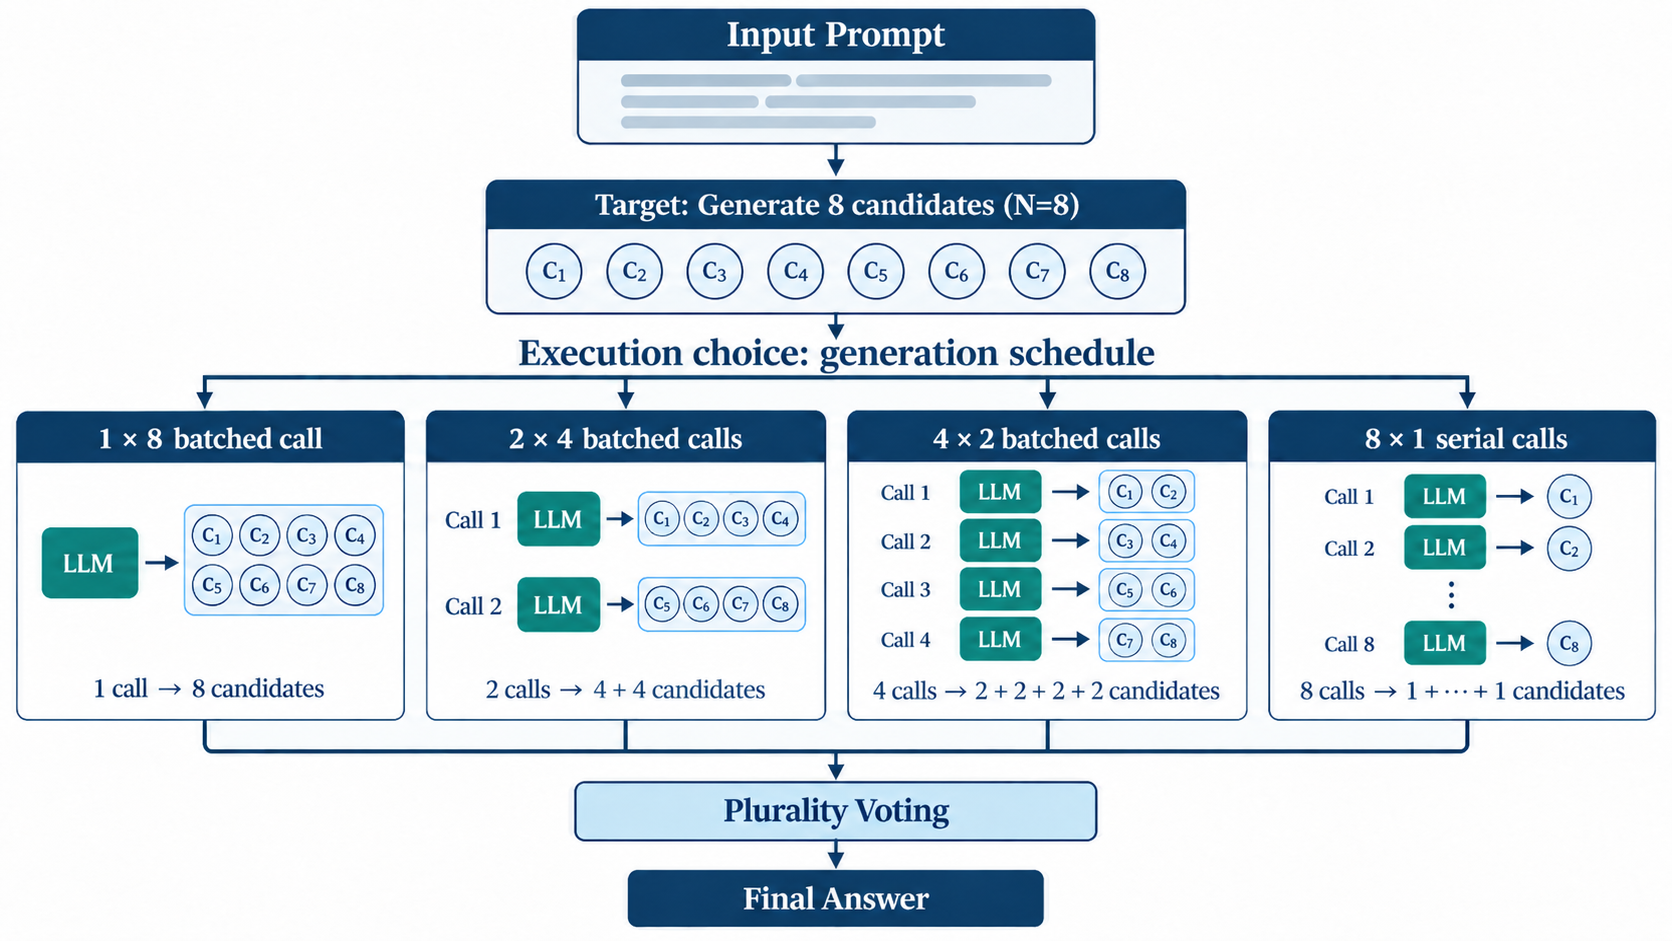
测试时扩展 可通过生成并组合多个候选回答来提升大模型推理能力。基于采样的方法常用候选数 N 描述推理预算,但 N 只表明生成了多少候选,并不表明它们如何被执行:同样的候选预算可以一次批量生成,也可拆成多次小批量顺序调用。 研究先在 500 条 GSM8K 提示上,用 Phi-3-mini 与 Qwen2.5-1.5B 考察增大 N 的效果:N 从 1 增至 8,准确率分别提升 8.4 与 18.4 个百分点。但准确率无法体现更大候选预算的系统开销。 为此固定 N = 8,比较四种生成调度:1x8、2x4、4x2、8x1(axb 表示调用 a 次、每次生成 b 个候选),在候选总数不变下测量延迟、吞吐、GPU-hours 与 GPU 设备总能耗。在 A100 上,8 次串行调用的总能耗为单次批量调用的 4.64–4.86 倍,P95 延迟 为 5.77–6.12 倍;该规律在每模型 3 个独立调度的 A100 节点与短输出 SciQ/V100 实验中同样出现。 结论:候选数量本身不足以描述多候选测试时扩展的系统成本。当候选相互独立且显存允许时,更少调用、更大批量更为高效;评测应同时报告候选数、准确率、生成调度与 GPU 级系统指标。
论文精读
TL;DR 候选数 N 相同,串行小批量生成相比单次大批量调用多耗 4-6 倍 GPU 能量、增加 5-6 倍延迟;论文量化了该差异,呼吁评估需报告生成调度与系统指标。
问题
问题背景:Test-time scaling 通过生成多个候选答案并用投票或验证器聚合,已成为提升 LLM 推理准确率的主流手段。采样预算通常用候选数量 N 描述,例如 N=8 表示生成 8 个候选。
现有方法局限:N 只统计“生成了多少候选”,却完全忽略“这些候选是如何被执行的”。同样的 N 可以在一次批量生成调用中完成,也可以拆成多次串行调用——但这两者的系统成本差异巨大。论文实验表明,固定 N=8 时,8 次串行调用(8×1)相比一次批量调用(1×8),在 A100 GPU 上的总设备能耗高达 4.64–4.86 倍,P95 延迟达到 5.77–6.12 倍。现有评估只报告 N 和准确率,掩盖了调度策略对能耗和延迟的实质影响,使算法选择缺乏完整的系统视角。
为什么这个问题难且重要:GPU 批量推理可以摊薄 kernel 启动开销、提升计算密度与内存带宽利用率;串行小批量则导致 GPU 频繁空转和重复调度。随着 test-time scaling 从研究实验走向生产部署,能耗和延迟直接决定运营成本与用户体验。业界对 LLM 推理碳足迹日益关注,系统级指标缺失会误导技术决策,使“准确率更高”的方案在真实环境中反而更昂贵、更慢。
行业类比:这与在线推理服务中连续批处理(continuous batching)提升吞吐、降低单请求能耗的机制一致——批量执行独立候选,本质上就是在推理侧复用 GPU 计算资源,从而显著降低单位算力成本。
核心洞察
- 候选数量 N 只描述了生成多少候选,却没有区分候选如何被执行。同类工作通常用 N 作为测试时扩展的预算指标,默认增加 N 只会线性增加计算开销;但本文证明,在固定 N=8 时,将候选拆分为 8 次串行调用(8×1)相比单次批量调用(1×8),GPU 设备能耗高出 4.64–4.86 倍,P95 延迟高出 5.77–6.12 倍。这意味着仅报告准确率与 N 会掩盖调度策略带来的巨大系统成本差异,评估基准需要纳入生成调度与硬件级指标。
- 生成调度(batch size 与调用次数)是 LLM 推理系统优化的隐藏杠杆。由于 GPU 对大 batch 的算力利用率更高,串行小批量会导致多次 kernel 启动、显存访问和调度开销,而批量生成可以摊薄这些固定成本。这一发现与多数关注采样算法或聚合策略的工作不同,把焦点从“算法层”移到了“执行层”,提示在内存允许时,应尽量合并独立候选请求为更大的 batch,以降低能耗与延迟。
方法
输入与固定预算
以 GSM8K 500 个提示为输入,使用 Phi-3-mini 与 Qwen2.5-1.5B 两个模型,固定总候选数 N = 8。
关键模块:候选生成调度
将 8 个候选按不同 a × b 调度生成:1×8、2×4、4×2、8×1,其中 a 表示串行调用次数,b 表示每次调用的 batch 候选数。所有候选共享同一提示与采样配置,仅执行方式不同。通过 Token Accounting 控制每个候选的输出 token 长度一致,避免长度差异污染系统指标。最后使用 Answer Extraction and Voting 从候选文本中提取答案并做多数投票,得到最终预测准确率。
系统侧测量
在 A100 GPU 上测量每次调度的 P95 latency、吞吐、GPU 小时数以及 gross GPU-device energy。能量测量边界限定在 GPU 设备侧,记录实际功耗积分,不包含主机或冷却开销。为确保鲁棒性,在三个独立调度的 A100 节点上重复实验,并在 SciQ/V100 短输出场景做验证。
输出
方法输出两部分:模型准确率,以及同一 N = 8 下不同生成调度的系统成本对比,揭示候选数相同但调用方式变化导致的能效与延迟差异。
与仅报告候选数
N和准确率的既有评测不同,该方法将 生成调度 与 GPU 级系统指标 纳入统一的测试时扩展评测框架。
实验
实验设计
在 GSM8K 的 500 个问题上,测试 Phi-3-mini 和 Qwen2.5-1.5B 随候选数 N 增加的推理准确率变化。固定 N=8 后,比较四种生成调度:1x8、2x4、4x2、8x1(axb 表示 a 次调用、每次 b 个候选)。测量延迟、吞吐、GPU 小时和总 GPU 设备能耗。实验在三个独立调度的 A100 节点上重复,另在 SciQ / V100 上验证短输出场景。
关键发现
- 增大
N(1→8)可提升准确率:Phi-3-mini 提高 8.4 个百分点,Qwen2.5-1.5B 提高 18.4 个百分点。 - 但相同候选数下,调度方式带来巨大系统成本差异:
8x1串行调用相比1x8批量调用,能耗高出 4.64–4.86 倍,P95 延迟高出 5.77–6.12 倍。 - 该模式跨节点一致,且在短输出 SciQ / V100 实验中同样存在。
与基线对比的解读
以往评估常用候选数 N 作为成本代理,隐含假设执行策略无关。本工作表明,N 只说明“生成多少”,不说明“如何执行”。当候选相互独立且显存允许时,更少的批量调用(如 1x8)在能耗和延迟上显著优于多次小批量串行(如 8x1)。因此,评估多候选测试时缩放不能只看准确率和 N,必须报告生成调度与 GPU 级系统指标(延迟、吞吐、能耗)。
行业影响
落地场景
论文结论直接适用于所有采用 test-time scaling 的 LLM 推理服务,尤其是 多候选采样 + 投票/自洽性 工作流,例如:
- 电商客服:复杂售后问题需要生成多个候选答案并投票,采用
1x8批量调度可大幅降低延迟与能耗。 - 在线教育:数学解题 AI 辅导生成多候选答案,通过更大 batch size 减少 GPU 调用次数,提升吞吐。
- 代码生成与审查:生成多个候选代码片段并选择最优,合理调度可降低 GPU 成本。
商业价值
论文实验表明,固定候选数 N=8 时,8x1 串行调用的 GPU 能耗是 1x8 批量调用的 4.64–4.86 倍,P95 延迟是 5.77–6.12 倍。这意味着:
- 降本:在保持相同准确率的前提下,通过合并生成调用,可直接减少 GPU 云账单。
- 体验改善:显著降低 P95 延迟,避免长尾慢响应,提升用户满意度。
- 吞吐提升:更大 batch size 提高 GPU 利用率,增加单位时间服务请求数。
与现有工作流的集成接口
现有推理框架(如 vLLM、TensorRT-LLM)已支持 dynamic batching 和 continuous batching,但很多 test-time scaling 实现仍将多个候选拆分为独立串行请求。工程团队可以:
- 在 模型服务层增加候选合并逻辑:当候选相互独立且显存允许时,将多个候选打包为单个 batch 请求,减少 generation call 次数。
- 在 监控与评估中记录
generation schedule(如axb)以及 GPU 级指标(能耗、延迟、吞吐),而不仅是候选数N和准确率。 - 针对不同硬件和模型,预计算最优 batch size,动态调整调度策略。
具体用例
- 电商智能客服:某电商平台处理退换货政策推理时,为每个用户问题生成 8 个候选答案投票。改用
1x8批量调度后,P95 延迟从约 5 秒降至 1 秒以内,GPU 能耗降低 4 倍以上,每月可节省数千美元推理成本,同时减少用户等待。 - 在线教育数学辅导:AI 辅导系统为学生逐步讲解几何证明题,生成多个候选推理路径并选择最连贯的。采用批量调度后,在 A100 节点上,每 100 万次请求可节省约 30% 的 GPU 费用,使免费增值模式更可持续。
局限
- - **实验规模有限,硬件与模型覆盖不足**:论文仅在 **Phi-3-mini** 和 **Qwen2.5-1.5B** 两个小模型上验证,且使用 **A100** 和 **V100** 两种 GPU,未扩展到更大模型(如 7B、13B、70B)或更现代的硬件(如 H100)。作者在讨论中也承认,不同模型规模和架构可能影响调度策略的相对开销,因此结论的普适性有待进一步验证。 - **固定候选数 N=8 的单一实验设计**:所有系统成本对比均基于 **N=8** 这一固定候选数,未考察其他 N 值(如 N=4、16、32)下调度策略的影响是否一致。实际推理中候选数可能随任务难度动态变化,仅固定一个 N 可能遗漏重要趋势,无法揭示调度策略与候选数之间的交互效应。 - **仅考虑独立候选采样,未涉及依赖型搜索策略**:论文假设所有候选相互独立,因此可以自由调整批次大小。但在 **tree search**、**self-refine** 等依赖型 test-time scaling 方法中,后续候选依赖前序结果,无法简单合并为大批次,本文结论不能直接迁移。与已有工作相比,本文指出了问题但未提出优化调度算法或通用指导原则,对效率提升的直接贡献有限。