PANORAMA: 通过掩码候选选择实现全景接地的图像描述
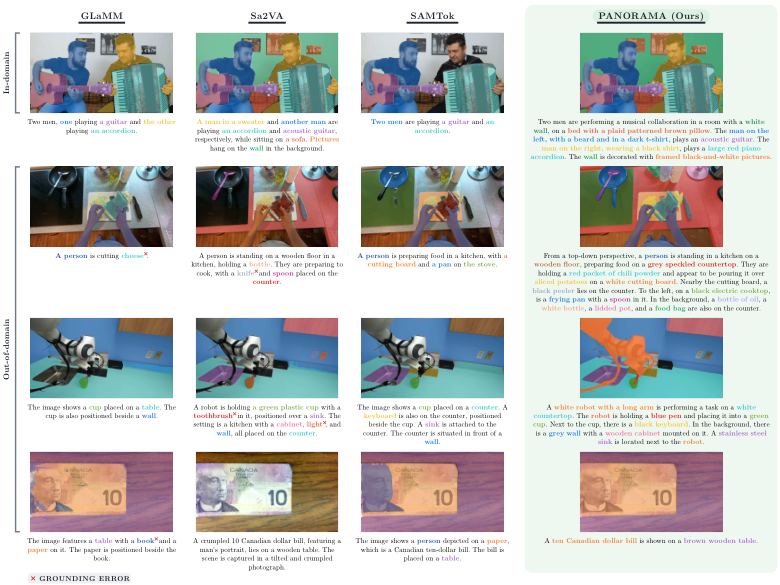
问题背景:当前视觉语言模型(VLM)能生成流畅、详细的图像描述,但很难可靠地将描述与图像像素对应起来。已有的密集描述与像素级接地方法往往产生不完整的描述或不准确的掩码。为此,作者研究 panoptic grounded captioning 任务:要求 VLM 同时描述前景物体和背景区域,并用像素级掩码为每个指称短语定位。 主要贡献: 1. 提出 PanoCaps,一个基于全景分割数据集人工标注的基准,提供近全覆盖像素的密集描述与实体级图文对齐,并给出短语-掩码匹配协议和 gPQ(Generalized Panoptic Quality)指标,联合评估文本与掩码的一致性。 2. 将短语接地建模为「从短语条件下的掩码候选池中选择」,提出 PANORAMA:用上下文化短语表示来条件化预训练分割器以生成候选掩码,并学习为每个短语挑选对应掩码;与描述生成联合训练后,每个短语可指向单个区域或多个实例。 实验结论:PANORAMA 在 PanoCaps 上取得最佳总体接地效果,并在多个像素级接地任务上匹配或超越专用模型,能产出精确的实体级分割,同时保持详细且与掩码一致的描述。代码、数据和模型已开源。
论文精读
TL;DR PANORAMA 提出全景接地描述:生成稠密图像描述时,通过短语条件掩码候选选择,同时实现前景物体与背景区域的像素级对齐,并配套 PanoCaps 基准与 gPQ 指标。
问题
问题背景
当前视觉语言模型(VLM)在图像描述上表现优异,但如何将语言描述与像素级空间位置可靠对齐,仍是多模态理解中的核心挑战。
现有方法局限
现有 dense captioning 与 pixel-level grounding 的结合方法存在两个主要问题:
- 描述不完整:通常只关注显著的前景对象,忽略背景区域(stuff)或小目标,导致 caption 无法覆盖全图语义。
- mask 不准确:phrase 与 mask 的对应关系模糊,尤其当一个 phrase 指代多个实例(如“a group of people”)时,模型难以输出正确分割。 此外,缺少统一的 benchmark 和评估指标来同时衡量文本质量与 mask 质量,不同方法难以公平比较。
为什么这个问题难/重要
技术难点在于需要联合建模自然语言生成与全景分割,并保证实体级对齐:每个 referring phrase 必须对应到正确的图像区域,且所有像素都要有语义归属。这比单独做 captioning 或 segmentation 更困难,因为语言指代具有歧义性和组合性,而全景分割要求严格区分 thing 与 stuff。在业界,机器人操作、自动驾驶、图像编辑等应用都需要模型输出带精确分割 mask 的描述,以支持下游的抓取、导航或局部编辑任务,因此该问题具有很高的实用价值。
行业类比
类似于大模型从“看图说话”走向“指哪打哪”:在具身智能中,agent 需要生成可操作的物体操作指令,同时输出对应的分割 mask 来引导机械臂,正是全景 grounded captioning 的典型场景。
核心洞察
- 将 phrase grounding 建模为从 phrase-conditioned mask proposal 池中选择,而非直接回归像素级 mask。这一设计把视觉分割能力(预训练 segmenter)与语言对齐能力(可学习的 selection)解耦,使模型可以复用强分割先验,同时支持一个短语对应多个实例。相比之下,既有 dense captioning + grounding 方法往往对每个 phrase 独立生成一个 mask,难以处理同类别多实例或背景区域,且 mask 质量受限于语言到分割的跨模态映射。
- 提出 PanoCaps 基准及 gPQ 指标,首次在 panoptic grounded captioning 场景下联合评估文本描述与 mask 的像素级一致性。传统指标如 captioning 的 CIDEr 或分割的 PQ 各自独立,无法反映“描述正确但 mask 错误”或“mask 准确但描述缺失”的对齐失败;gPQ 通过 phrase-mask matching protocol 将 text-mask agreement 纳入统一度量,为训练和评测提供了更贴近实际应用的目标。
- 在 caption 生成过程中联合训练 mask selection,使模型输出的每个 referring phrase 都具备可验证的视觉基础。与先独立生成 caption 再后处理对齐的两阶段方案相比,这种端到端训练能促使模型避免生成无法定位的描述,减少“流畅但幻觉”的短语,从而在保持描述详细度的同时提升 mask-consistent grounding。
方法
输入与任务定义
输入为图像,任务要求生成密集描述,每个指代短语关联像素级掩码,覆盖前景物体与背景区域。
关键模块
- 短语条件化掩码提案生成:利用预训练分割器,以 VLM 编码器输出的上下文化短语表示为条件,生成一组候选掩码提案(mask proposals)。该设计允许每个短语对应单个区域或多个实例。
- 掩码选择模块:不直接回归掩码,而是从候选池中选择与每个短语最匹配的掩码。通过短语-掩码匹配协议学习选择,联合优化 caption 生成与掩码选择目标。
- 统一 VLM 架构:PANORAMA 将 caption 生成、短语编码、掩码提案与选择集成在一个模型中,端到端可训练。
输出
输出为完整的密集描述文本,以及每个指代短语对应的像素级分割掩码,实现文本与掩码的一致性。
原文表述:将短语 grounding 表述为 selection from a phrase-conditioned pool of mask proposals。
与同类方法差异
与之前方法(先密集描述后独立 grounding 或直接回归掩码)不同,PANORAMA 利用预训练分割器的提案并学习选择,在保持 caption 细节的同时提升掩码精度,支持多实例指代。
实验
实验设计
- 使用 PanoCaps benchmark 作为主要训练与评估集,提供密集 caption 和 entity-level 对齐。
- 评估采用 gPQ 指标与 phrase-mask matching protocol,联合衡量文本与 mask 的一致性。
- 对比基线包括现有 dense captioning 与 grounding 结合方法,以及 specialized pixel-level grounding 模型。
- 通过 ablation studies 验证 mask proposal selection 与 joint training 的贡献。
关键发现
- PANORAMA 在 PanoCaps 上取得最佳整体 grounding,生成与 mask 一致的高密度 caption。
- 该方法在多个 pixel-level grounding 任务上匹配或超过专用模型,展现跨任务泛化能力。
- 掩码选择机制支持单个 phrase 指代单区域或多实例,同时保持 caption 完整性和精确分割。
与基线对比解读
- 现有方法常产生不完整描述或不准 mask,PANORAMA 通过从 phrase-conditioned proposal pool 中选择 mask,缓解了 dense caption 与 grounding 割裂问题。
- 联合训练 caption generation 与 mask selection 是性能提升关键,使文本输出与像素级证据一致。
- 工程启示:将 grounding 形式化为 proposal selection 而非直接回归,可复用预训练 segmenter 并降低端到端训练难度。
行业影响
落地场景
PANORAMA 的短语级像素 grounding 能力可直接用于以下产品与业务:
- 电商商品详情生成:自动对商品图像中的各个部件(如鞋面、鞋底、logo)生成独立描述并关联 mask,实现图文精确对齐,提升商品信息丰富度。
- 内容平台审核与标签:对用户上传图像生成带区域描述的场景理解,快速定位违规区域或提取结构化标签,用于推荐和广告投放。
- 自动驾驶数据标注:为路采图像自动生成包含车辆、行人、道路等实体的 mask 和对应短语,大幅降低人工标注成本,加速感知模型训练。
商业价值
主要价值在于降本与体验提升双线。传统的密集 caption 与分割 mask 通常由两个独立模型分别生成,人工对齐成本高且易出错。PANORAMA 的联合训练使得 caption 与 mask 天然一致,可将标注效率提升数倍。在电商场景中,精细的部件描述可提升用户理解和点击率;在内容平台,自动生成的区域标签可作为多模态搜索的索引,增强检索体验;同时,精准的 grounding 是构建可解释 AI 系统的基础,有利于合规审查和用户信任。
与现有工作流的接口
PANORAMA 可作为即插即用的视觉-语言对齐模块集成到现有 VLM pipeline 中。它接受一个预训练的分割器(如 SAM)和短语的上下文表征,输出一组候选 mask 并学习选择。因此,只需要替换或增加一个轻量的选择头,即可让现有 caption 模型输出带有 mask 的结构化结果。输出格式可以是 JSON:{"phrase": "red car", "mask": [polygon]},方便下游系统消费。训练数据与评测基准 PanoCaps 可直接用于 fine-tune 或评估,无需重新设计标注协议。
局限
- **PanoCaps 基准受限于源数据集类别与粒度**。论文构建 PanoCaps 时使用现成 panoptic segmentation 数据集作为基础,其类别体系和实例标注源自有限集合,可能无法覆盖开放世界中的细粒度物体、罕见类别或属性描述(如“生锈的蓝色椅子”)。这会导致在该基准上训练或评估的模型,在自然图像或需要开放词汇理解的任务上泛化能力受限;虽然论文声称接近完整像素覆盖,但覆盖范围仍受原始注释语义边界限制,难以扩展到任意概念。
- **方法依赖 mask proposal 池的质量**。PANORAMA 将 grounding 形式化为从 phrase-conditioned proposal 池中选择 mask,如果预训练分割器生成的 proposal 未能覆盖正确区域(例如严重遮挡、极小物体、非常规形状或复杂背景),后续选择模块无法纠正,可能造成漏检或错误 mask。此外,联合训练需要 image-text-mask 三元组对齐数据,人工标注成本高,限制了模型扩展到新领域或更大规模数据的可行性。
- **两阶段 pipeline 带来额外推理开销**。与端到端直接预测 mask 的方法相比,PANORAMA 需要先生成 proposal 池再执行选择,增加了推理时延和显存占用;在实时应用或资源受限场景中可能成为瓶颈。实验主要在 PanoCaps 及若干 pixel-level grounding 任务上验证,尚未在更广泛的开放域图像描述或视频 grounding 场景下全面测试,其效率与鲁棒性有待进一步验证。